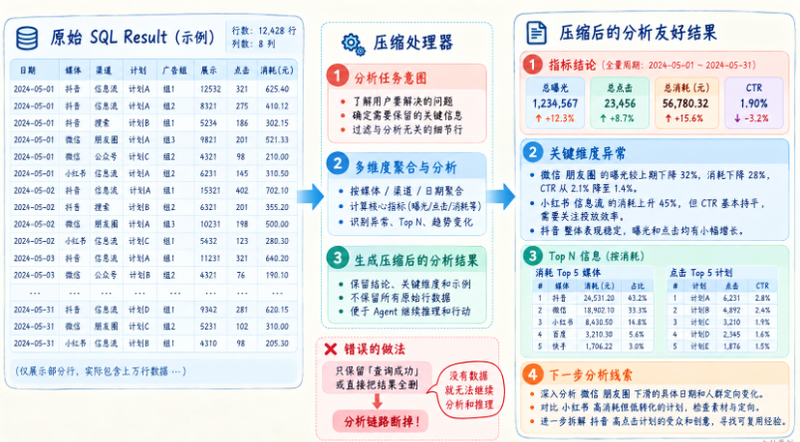


数据分析类任务里,最常见的问题不是“没有结果”,而是结果太大,直接把上万行 SQL 输出塞进 Context 根本不现实。所以真正关键的,不是保留所有原始行,而是把它压成仍然利于分析继续推进的结构化结果。
这张图把原始 SQL Result、压缩处理器,以及压缩后的分析友好结果放在了一条链路上。你会很直观地看到:压缩之后,保留下来的应该是指标结论、关键维度异常、Top N 信息和下一步分析线索,而不是整张明细表。这样做才是真正意义上的“既省 Token,又不丢分析链路”。
场景背景
用户问,“为什么昨天收入下降?”
Agent 已经执行 18 个 SQL。
旧 Tool Result 包括:
整体收入
请求量
曝光量
点击
eCPM
按媒体拆分
按广告位拆分
按 APP 拆分
按系统版本拆分
每个结果几十到几百行。
如果全部保留,Context 非常大。
错误方案
直接只保留最近 3 个 SQL Result。
问题:
请求量稳定这个重要结论可能丢失。
模型又回头查请求。
正确压缩
把旧 SQL Result 转成分析摘要:
Historical Analysis Summary:
- 昨日总收入下降 20%
- 请求量 +1%,不是主要原因
- 曝光量 -3%,影响有限
- eCPM -35%,是主要异常指标
- media_B 贡献了约 70% 的下降
- 当前需要继续下钻 media_B 的 position
最近一个按 position 查询结果保留原始小表。
Working Memory:
Completed:
- 已排除流量下降
- 已确认 media_B 为主要异常来源

Next Action:
定位 media_B 内异常广告位
结果
模型不需要再背 18 个 SQL 表格。
但分析链路完整保留。
迁移
同样适用于:
日志分析
监控指标
实验分析
用户行为分析
财务指标诊断
真正要保留的是,结论与证据关系。
不是每张旧表的所有行。
常见误区
误解: Context Compaction 就是删除旧消息,效果和 messages[-20:] 差不多。
正解: 简单截断只按时间保留最近内容,可能把最早但最重要的规则、用户约束和关键事实一起删掉。Compaction 的核心是先识别高优先级内容,再把旧执行历史提炼成 Summary,同时保留最近消息。它关注的是语义价值,不是单纯消息位置。
误解: Summary 一旦生成,就可以永久相信,不需要再读原始代码和数据。
正解: Summary 本质上有信息损失,而且可能过期。代码如果后面发生修改,旧 Summary 更不能作为精确编辑依据。更合理的是:Summary 用于理解和导航,真正执行 edit_file、精确定位 Bug 或验证数据时,仍然通过 Tool 重新读取当前原始内容。摘要不是事实存储的最终替代品。
误解: Tool Result 都是真实环境结果,所以不能压缩。
正解: “真实”不等于“必须每轮原样发送”。完整 Tool Result 可以保存在 Trace 或 Session Store,而当前 Context 只需要保留影响下一步决策的部分。比如 500 行 pytest 日志可以压缩成失败测试、异常类型和关键栈信息;60 条搜索结果可以保留总数量和最相关几条。原始证据仍然存在,只是不重复占用 Context。
误解: Working Memory 已经很短,所以有 Working Memory 就不需要 Compaction。
正解: Working Memory 只能压缩“当前认知”,但 Conversation、Tool Result、代码和日志仍会持续增长。如果 ContextBuilder 每轮继续携带完整历史,窗口仍然会被撑大。Working Memory 和 Compaction 是互补关系:前者维护当前任务快照,后者清理和压缩旧执行历史。
误解: 代码文件可以统一压缩成自然语言 Summary,以后不需要再读取源码。
正解: 代码摘要适合帮助模型理解结构,但精确修改依赖真实函数签名、变量名、上下文和最新版本。更稳的做法是:不活跃文件保留结构摘要,当前正在分析的文件保留相关片段,真正编辑前再次 read_file。Summary 用于导航,Raw Code 用于执行。
误解: 每一轮都做 Compaction 最安全,因为 Context 永远很短。
正解: Compaction 自己也有成本和信息损失。如果每一步都重新总结,不仅增加模型调用和延迟,还可能不断改写历史事实。更合理的是设置触发阈值,例如 Context 使用率、消息数量、Tool Result 体量达到一定水平后再压缩,并记录压缩前后指标。
误解: Summary 是模型生成的流畅文字,所以可以当成比原始 Tool Result 更高权限的内容。
正解: Summary 仍然是对数据的派生表示,可能遗漏、过期,也可能受到不可信内容影响。它应该作为普通上下文数据注入,不能升级成 System 指令;关键数字、约束和事实仍要能回到原始证据验证。
误解: 最近保留 6 条消息时,可以从任意第 6 条直接切开。
正解: 原生 Tool 协议有完整交互边界。Assistant 发出 Tool Call 后,对应结果通过 Call ID 关联;从中间切开会留下孤立请求或结果。保留窗口应按交互单元计算,而不是只按字典数量切片。















请登录后查看评论内容