

这一小节最适合先看一眼全貌。四类文件虽然都叫 Memory,但职责完全不同,别把偏好、事实、决策、经验一股脑塞进同一个文件里。
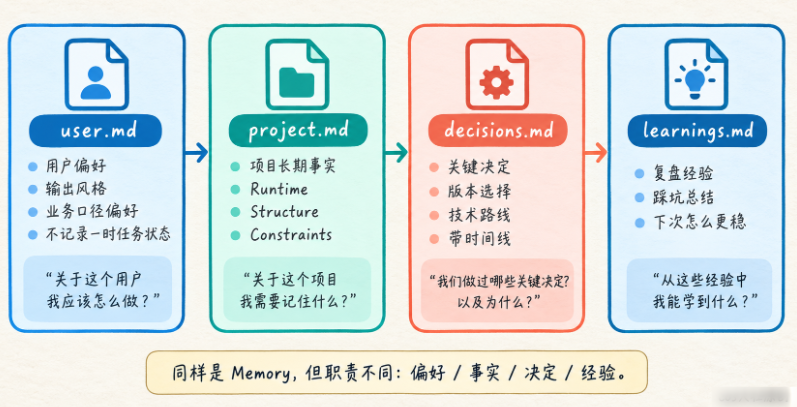
这张图其实回答了一个很常见的问题:为什么长期记忆要拆文件? 原因很简单,拆开以后写入规则更清晰,读取也更稳定。你看到 user.md,自然想到“这个用户长期是什么习惯”;看到 project.md,就知道这里存的是项目事实;decisions.md 侧重“做过什么选择、为什么这么选”;learnings.md 则更像复盘库,沉淀的是经验和教训。
现在我们正式设计目录:
memory/
├── user.md
├── project.md
├── decisions.md
└── learnings.md
为什么选择 Markdown?
因为它:
人可以直接读
Agent 可以直接读
Git 可以版本管理
Diff 很清楚
不依赖数据库
调试特别直观
对于学习 Agent Memory,这是非常好的第一版。
不过目录还隐含了一个前提,当前只有一个用户、一个项目。 一旦服务同时面对多人,所有人共用同一个 user.md 就会串记忆。更接近真实系统的布局会是:
memory/
├── users/
│   └── user_123/
│       └── user.md
└── projects/
    └── project_456/
        ├── project.md
        ├── decisions.md
        └── learnings.md
scope_id 解决的是“数据放在哪个作用域”,不是身份认证。调用方仍要确认当前用户是否有权读取 project_456。这个边界很容易漏:路径分开了,不代表权限就自动正确了。
user.md:长期用户偏好
适合保存:
用户偏好的输出方式
用户反复明确的工程习惯
默认交互偏好
长期约束
例如:
## Preferences

- 代码修改优先采用最小改动。
- 技术解释优先说明原因,再给实现。
- 未经明确同意,不执行高风险写操作。
注意,不是什么信息都应该写。
Memory 系统应该遵循最小化原则。
只保存真正帮助 Agent 完成任务的信息。
project.md:项目长期事实
适合:
技术栈
入口文件
测试框架
工作目录
关键目录
部署约束
项目规则
例如:
## Runtime

- Python 3.9
- Flask
- pytest

## Structure

- 入口文件:src/main.py
- 配置目录:config/
- 测试目录:tests/

## Constraints

- 禁止修改 tests/
- 默认不新增第三方依赖
这些信息未来每次处理项目都很有价值。
decisions.md:已经做出的关键决定
项目事实和项目决定有点像,但还是建议分开。
project.md 更像,“现在是什么样。”
decisions.md 更像,“为什么我们决定这样做。”
例如:
## 2026-09-06

### 保持 Python 3.9

决定:项目继续使用 Python 3.9,不升级运行版本。

原因:
- 现有部署环境固定在 3.9
- 当前依赖均已验证兼容

### 继续使用 SQLite

决定:当前阶段继续使用 SQLite。

原因:
- 数据量较小
- 暂无并发写压力
这个“原因”非常重要。
未来模型看到:
继续使用 SQLite不会误以为只是偶然状态。
它知道这是明确决策。
learnings.md:从过去任务中得到的经验
这类 Memory 非常适合 Agent 累积项目经验。
例如:
## Python Debug

- 该项目启动时报 ModuleNotFoundError 时,优先检查 pyproject.toml,而不是 requirements.txt,因为依赖统一由 Poetry 管理。
- 运行测试统一使用 `pytest -q`。
它不是项目硬规则。
更像,“过去执行中学到的可复用经验。”
为什么 decisions 和 learnings 要分开?
因为:
Decision代表,有明确选择与约束。
而:
Learning代表,从执行中总结出的经验。
例如:
决定:
继续使用 SQLite
不能被 Agent 随意改。
而:
经验:
这个项目多数配置问题都出在 config/
未来可能被新证据修正。
二者可信度不同。
初始化目录
下面先实现一个 Memory Store。
from pathlib import Path


MEMORY_FILES = {
    "user": "user.md",
    "project": "project.md",
    "decisions": "decisions.md",
    "learnings": "learnings.md",
}


def init_memory_dir(
    root: Path,
) -> None:
    root.mkdir(
        parents=True,
        exist_ok=True,
    )

    for (
        memory_type,
        filename,
    ) in MEMORY_FILES.items():
        path = root / filename

        if path.exists():
            continue

        title = (
            memory_type
            .replace(
                "_",
                " "
            )
            .title()
        )

        path.write_text(
            f"# {title} Memory\n\n",
            encoding="utf-8",
        )


if __name__ == "__main__":
    memory_root = Path(
        "memory"
    )

    init_memory_dir(
        memory_root
    )

    for path in (
        memory_root.iterdir()
    ):
        print(path)
运行后得到:
memory/
├── user.md
├── project.md
├── decisions.md
└── learnings.md
这一步看起来很简单。
但记忆架构已经有了最重要的第一层,分类。















请登录后查看评论内容