


题目 1:为什么 messages[-20:] 不能等价替代 Context Compaction?
请从项目规则、用户硬约束、历史结论和最近消息四个角度说明,并给出一个更合理的上下文重建结构。
messages[-20:]只按时间保留最近内容,会把更早但仍然重要的规则和约束删掉,例如“禁止修改 tests/”。真正 Compaction 应该把高优先级规则独立保存,把旧历史提炼成 Historical Summary,同时保留 Working Memory 和最近消息。一个更合理结构是:System Rules + Project Rules + Working Memory + Historical Summary + Recent Messages + Recent Tool Results + Current Task。
题目 2:判断题——旧 Tool Result 只要已经摘要,就可以从系统永久删除原始结果,对吗?
请说明 Context 与 Trace / Session Store 的区别。
不对。Compaction 解决的是“哪些内容继续发送给模型”,而不是“系统是否永久保留原始证据”。完整 Tool Result 可以继续存放在 Trace、Session Store、文件系统或数据库中,便于审计和后续重新读取。当前 Context 只保留摘要和关键片段,从而节省 Token。Storage 保存事实证据,Context 保存当前决策真正需要的信息,两者职责不同。
题目 3:Tool Result、日志、Traceback 和代码为什么不应该用同一种压缩策略?
请分别给出一种更合适的处理方式。
不同内容的信息结构不同。普通 Tool Result 可以保留关键字段与结论;日志适合保留 summary、ERROR/WARN 行、开头少量环境信息和最后若干行;Traceback 适合保留异常类型、message 与 workspace 内关键调用栈;代码则更适合保留类、函数、依赖等结构摘要,但精确修改前重新读取原文。统一截前 4000 字会丢失很多关键语义。
题目 4:编程实现——实现一个 compact_context(),旧消息压缩,最近 5 条保留原文
要求输入 messages,超过 12 条才触发压缩,并返回 summary 与 recent_messages。
from dataclasses import dataclass


@dataclass
class CompactResult:
    summary: str
    recent_messages: list[dict]
    triggered: bool


def compact_context(
    messages: list[dict],
    keep_recent: int = 5,
    trigger_count: int = 12,
) -> CompactResult:
    if len(messages) <= trigger_count:
        return CompactResult(
            summary="",
            recent_messages=messages,
            triggered=False,
        )

    old_messages = messages[
        :-keep_recent
    ]

    recent_messages = messages[
        -keep_recent:
    ]

    summary_lines = []

    for item in old_messages:
        role = item.get(
            "role",
            "unknown"
        )

        content = str(
            item.get(
                "content",
                ""
            )
        ).strip()

        if content:
            summary_lines.append(
                f"{role}: "
                f"{content[:120]}"
            )

    return CompactResult(
        summary="\n".join(
            summary_lines
        ),
        recent_messages=(
            recent_messages
        ),
        triggered=True,
    )


if __name__ == "__main__":
    messages = [
        {
            "role": "user",
            "content": (
                f"message-{index}"
            ),
        }
        for index in range(20)
    ]

    result = compact_context(
        messages
    )

    print(
        result.triggered
    )

    print(
        result.summary
    )

    print(
        result.recent_messages
    )
#这个版本仍然是规则式摘要,但已经具备“旧消息压缩、最近消息保留”的完整控制流程。
题目 5:综合应用——为什么代码 Summary 不能直接用于后续 edit_file?
请从“信息损失”“代码已更新”“精确修改”三个方面解释。
代码 Summary 会省略大量实现细节,例如具体变量名、函数体、上下文和行级结构;而且 Agent 可能已经修改过文件,旧 Summary 可能过期。
edit_file需要精确匹配当前最新文本,因此不能只依赖摘要。更合理的是 Summary 用于理解文件职责和决定“该看哪个文件”,真正修改前重新读取当前原始代码片段,确保执行基于最新事实。
题目 6:什么时候应该触发 Compaction?
请从 Token 使用率、消息数量、Tool Result 体量和执行成本四个角度设计一个简单策略。
可以组合触发。例如 Context Usage 超过 80% 时强烈建议压缩;messages 超过 40 条时检查;累计 Tool Result 超过某个字符或 Token 阈值时触发;同时避免每轮都压缩,因为 Summary 本身有模型调用成本。实际系统可以先设置
usage_ratio >= 0.8 OR messages >= 40 OR tool_result_tokens >= threshold,触发后记录压缩前后 Token 和压缩次数。
题目 7:概念理解——为什么说“压缩的是表达,不是事实”?
请结合 Trace、Historical Summary、Working Memory 三层说明。
原始事实仍然可以完整存在 Trace 或 Session Store 中,例如每次 Tool Call、完整日志和代码读取结果;Historical Summary 只是把这些旧事实以更短形式表达给当前模型;Working Memory 则进一步保留当前仍影响下一步的认知。Compaction 并不是抹掉事实,而是改变当前 Context 中呈现事实的方式,以较低 Token 成本维持任务连续性和决策质量。
题目 8:故障恢复——摘要生成失败时,为什么不能先删除旧消息?
请设计一个“候选摘要、校验、提交”的安全顺序,并说明原始证据放在哪里。
先从当前历史生成候选摘要,原消息保持不动;接着检查硬约束、关键事实、未完成动作、数字实体和 Tool 协议是否仍然完整,并比较压缩前后 Token。只有校验通过后,才把新的 Historical Summary 与最近交互作为当前 Context 快照提交。若生成超时、校验失败或摘要没有变短,就继续使用旧 Context或退回确定性策略。完整原消息和 Tool Result 保留在 Trace / Store,并记录摘要版本及覆盖范围,便于恢复和复盘。
进一步阅读
- Summarization / Hierarchical Summarization:理解多轮历史如何逐层压缩成稳定摘要。
- Context Engineering:继续关注 Context Selection、Priority、Budget、Compaction 之间的配合。
- Retrieval Architecture:被移出 Context 的原始内容可以通过检索再次取回。
- AST / Code Indexing:代码不一定只靠 LLM 摘要,可以通过语法树提取类、函数和依赖结构。
- Log Processing:了解日志采样、尾部保留、错误行抽取和结构化异常。
- State Snapshot:Working Memory Snapshot 与 Historical Summary 都可以作为 Trace 的一部分。
- Token Budgeting:真实系统应按模型 Token 预算触发 Compaction,而不是只按字符数。
- Long-context Agent Design:理解为什么长上下文模型仍然需要分层记忆和压缩。
术语表
- 上下文压缩(Context Compaction):把旧 Conversation、Tool Result、日志和历史细节提炼成更短但仍有决策价值的表示,同时保留高优先级规则与最近上下文的过程。
- 历史摘要(Historical Summary):对已不需要原文保留的旧执行历史进行语义提炼后的短文本,主要保存关键事实、已完成事项、重要决策和已解决问题。
- 最近上下文(Recent Context):距离当前 Step 最近的若干消息和 Tool Result,通常保留原文,因为它们对下一步最有直接影响。
- 压缩触发器(Compaction Trigger):决定什么时候执行压缩的条件,例如 Context 使用率、消息数量、Tool Result 总量或成本预算。
- 结构摘要(Structural Summary):针对代码等结构化内容提取类、函数、依赖和接口信息的摘要方式,不追求保留完整实现。
- 信息损失(Information Loss):摘要过程中不可避免丢弃部分细节的现象,因此高优先级规则和执行所需原始数据不能完全依赖 Summary。
- 上下文重建(Context Rebuild):在压缩后,使用 System Rules、Working Memory、Historical Summary、Recent Context、Current Task 等重新生成下一轮模型输入。
- 原始证据(Raw Evidence):完整 Tool Result、日志、Traceback、代码原文等事实材料,通常保存在 Trace 或 Store 中,而不是每轮全部进入 Context。
- 交互单元(Interaction Unit):不能被任意拆开的协议消息组,例如一条 Assistant Tool Call 及其全部 Tool Result。Compaction 应以单元为边界保留或压缩。
- 摘要漂移(Summary Drift):历史被多次重新总结后,事实、限定条件或置信状态逐渐改变的现象,需要版本、来源和回归校验来控制。
- 压缩提交(Compaction Commit):候选摘要通过约束、证据和协议检查后,才替换当前 Context 快照的步骤;失败时原 Context 仍可使用。
本章总结
这一节,我们真正把上一章提出的问题解决了一半。
上一章说,Agent 比普通 Chatbot 更容易把 Context 撑爆。
这一章继续回答,那 Context 快爆了以后,应该怎么做?
答案不是:
messages = messages[-20:]而是,Context Compaction。
它的基本流程是:
旧消息
  ↓
提取关键信息
  ↓
生成 Summary
  ↓
保留最近消息
  ↓
重新构建 Context
这里最重要的第一条原则是,压缩的是表达,不是事实。
原始 Tool Result、日志、代码、Traceback 可以继续存在:
Trace
Session Store
File Store
只是它们不需要每一轮都重新发给模型。
第二条原则是,不同类型信息不能一刀切。
System / Safety / Project Rules 属于高优先级约束,不能因为“太旧”就删。
Working Memory 保存当前任务认知,也应该继续保留最新版本。
旧 Conversation 适合压缩成 Historical Summary。
最近 Conversation 适合保留原文。
Tool Result 适合保留关键字段和结论。
日志适合保留错误、尾部和摘要。
Traceback 适合保留异常类型、message 和关键调用栈。
代码适合分层处理:
正在修改的代码
→ 保留相关原文

已读但暂时不活跃的代码
→ 保留结构摘要

完整代码
→ 需要时重新 read_file第三条原则是,Compaction 不是每一轮都做。
它应该由触发条件控制:
Context Usage
消息数量
Tool Result 体量
成本预算
例如 Context 使用率进入:
COMPACT_SOON再启动压缩。
第四条原则是,Summary 自己也不能无限长。
长任务可能经历多次 Compaction。
所以历史摘要也需要再次整合和压缩,而不是:
summary_v1 + summary_v2 + summary_v3一直拼。
我们在这一节实现了:
compact_context()并真正跑通:
Old Messages
→ Summary

Recent Messages
→ Keep Raw

Session
→ 更新 historical_summary

ContextBuilder
→ 重新构建
如果你要验证自己是否掌握,可以做一个很实际的实验。
让 Agent 生成 30 条历史。
压缩前统计:
消息数量
字符数
估算 Token
执行:
compact_context()再统计:
Summary 长度
Recent Messages 数量
新 Context 长度
然后检查 5 件事有没有丢:
Goal
项目硬约束
未解决错误
重要文件
Current Task
如果这些都还在,而旧日志、旧代码和重复 Tool Result 已经大幅减少,就说明 Compaction 真正起作用了。
到这里,我们已经有:
ContextBuilder
Working Memory
Session
Context Usage
Context Compaction
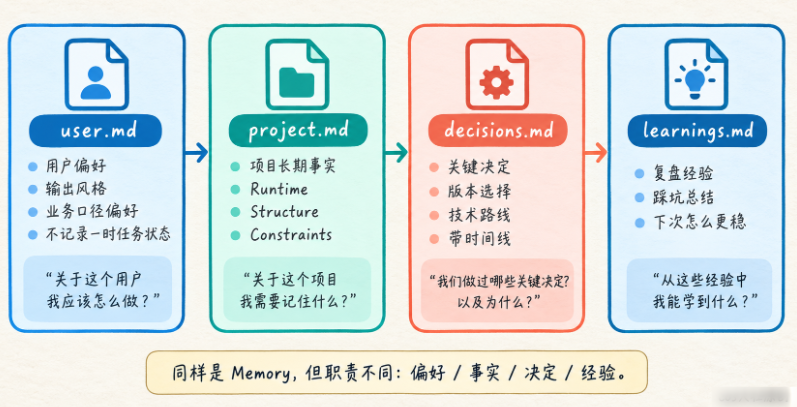
下一节,我们会继续处理另一个 Memory 问题,哪些信息值得跨 Session 继续记住?
也就是,Long-term Memory:让 Agent 跨 Session 记住信息。
Working Memory 负责:
当前任务Long-term Memory 则负责:
未来任务仍然有价值的事实、偏好、项目决策与经验。这两层真正分开以后,Agent 的记忆体系才开始完整。















请登录后查看评论内容