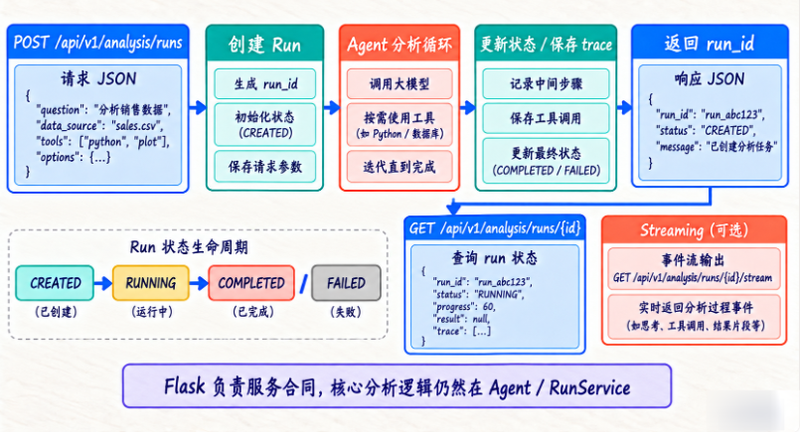


前面的分析链路能在脚本中运行以后,还要解决请求如何提交、Run 如何记录,以及客户端怎样查询任务状态。把这些职责拆开,Flask 接口就不用承担全部分析逻辑。
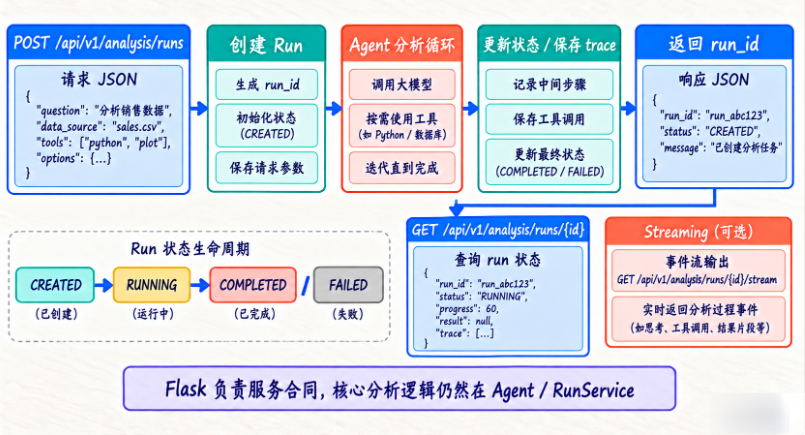
图示将创建 Run、分析循环、状态与 Trace 保存、查询结果放在一条链路上。接口样例和实际状态字段以这一节的代码为准,配图只用于帮助理解服务职责。
和 Coding Agent 一样。
Data Agent 不应该永远只是:
python3 agent.py我们要把它服务化。
接口:
POST /api/v1/data-analysis/runs请求:
{
  "question": "为什么昨天收入突然下降?"
}
返回:
{
  "run_id": "run_xxx",
  "status": "running"
}
查询 Run
GET /api/v1/data-analysis/runs/{run_id}可以返回:
当前 Step
当前状态
已确认发现
查询次数
最终结论
Streaming
也可以实时推:
正在确认收入变化...
发现 eCPM 明显下降...
正在下钻媒体...
Media A 异常最明显...
正在下钻广告位...
已定位 position_102...
分析完成。
这对用户体验非常好。
一个最小 Flask API:先验证服务合同
这段代码只创建了一条内存状态,还没有执行分析循环。它能帮助我们先对齐请求格式、run_id 和查询接口,却不能把 ready 当成已经分析完成。真实系统中:
create_run()内部调用:
AgentService
→ DataAgentEngine
而不是把所有分析逻辑写进 Flask Route。
从指标变化,走到有依据的分析结论
用户问“昨天收入为什么下降”,我们先确认昨天指哪个时区、是否数据齐全、与哪一天比较。示例数据库使用固定日期,因此演示问题应明确日期范围,避免把当前系统日期误用于历史样例。数据新鲜度和口径版本要与结果一同记录。
课程项目把日期范围作为 run() 的显式参数,默认比较 2026-09-05 和 2026-09-06。这两个默认值只是为了让离线示例可重复,不代表 Agent 已经从自然语言里可靠解析了“昨天”。接入真实业务时,日期解析应先得到用户所在时区、业务日切规则和对比基线;如果这些信息无法确定,我们宁可先澄清,也不要悄悄使用服务器日期。
定位异常时还要区分变化率与变化贡献。一个很小的广告位收入下降 90%,对总收入影响可能小于大广告位下降 10%。我们先比较绝对收入差额及其对总变化的贡献,再结合请求量、曝光和 eCPM 判断值得调查的方向。混合流量构成变化也可能影响总体 eCPM,不能直接把下降解释为某个价格策略故障。
结论应关联查询与结果引用,并区分已观察事实、解释和待验证假设。只读参数化查询降低了写入风险,但仍需范围限制、行数与时间预算、数据库只读权限和必要脱敏。当前样例属于受控数据教学工具,尚不等同于完整的生产语义层。
先把指标合同说清楚
同一个 income,可能表示预估收入、结算收入、税前收入,也可能使用不同币种;同一个“昨天”,还可能受到时区和延迟回补影响。Data Agent 如果不知道这些差异,SQL 写得再漂亮,也可能得到一份无法用于决策的答案。
开始查询前,我们至少要拿到下面这些上下文:
指标名称与计算公式
数据粒度和可用维度
业务时区与自然日边界
币种、单位和小数精度
数据更新时间与回补状态
用户可以访问的租户和数据范围
演示项目把这些条件压缩在一张 SQLite 表里,并明确采用 income / impression * 1000 计算 eCPM。真实系统更适合让 Query Tool 连接经过版本管理的语义层,而不是让模型从字段名猜口径。Trace 里还要记录语义层版本和数据快照时间,这样同一结论以后才有机会复算。
Query Policy 不是一句“只读”
课程项目中的 QueryPolicy 现在会逐项检查:
metrics 至少有一个,且不能重复
metric 和 dimension 必须来自白名单
dimension 最多两个,且不能重复
日期必须使用 YYYY-MM-DD,结束日期不能早于开始日期
单次日期范围最多 31 天
filter 只开放 media 和 position,值不能为空
返回结果最多 500 行
SQLite 连接使用 mode=ro 打开数据库,生成的 SQL 使用参数绑定,结果超过上限时会直接失败并要求缩小范围,而不是悄悄截掉后半部分。静默截断尤其危险:Agent 可能把“不完整的 Top N”误解为“全部数据”,最后给出很笃定的结论。
这些限制仍不是数据库隔离的替代品。到了生产环境,数据库账号本身也要只读,并在服务端落实租户过滤、列级权限、查询超时、并发配额和敏感字段脱敏。模型提示词只能帮助选择,不能承担最终授权。
变化率和变化贡献要分开看
假设两个广告位的收入变化如下:
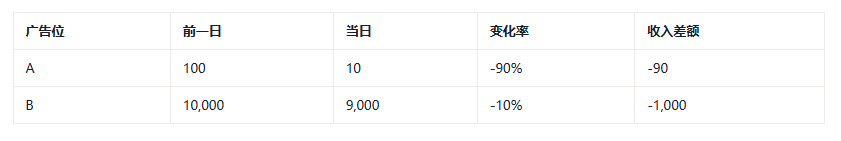
如果按变化率排序,A 更异常;如果要解释整体收入为什么下降,B 的贡献更大。两个视角都可以查,但回答“谁贡献了主要下降”时,优先依据应该是绝对收入差额:
收入差额 = 当日收入 - 基线收入
下降贡献率 = 某维度收入差额 / 整体收入差额
课程项目因此按收入差额选择需要继续下钻的媒体和广告位,再用 request、impression 与 eCPM 的变化描述异常形态。这样能避免一个体量很小、波动率很大的对象抢走全部注意力。变化贡献也不等于因果归因,它只是告诉我们下一步调查哪里更划算。
零基线、空结果和缺失日期不能硬算
当基线是 0 时,(new - old) / old 没有定义。返回 0% 会制造一种“没有变化”的错觉,因此项目会显式报错。根据业务需要,我们可以改成“从 0 增长到 N”这样的文字状态,但不能伪造百分比。
同样,下面几种情况都不应继续输出完整结论:
对比日期只返回了一天
查询结果为空
关键指标出现 NULL 或非法负值
媒体汇总无法与整体结果对账
广告位汇总无法与对应媒体结果对账
数据仍在回补,两个日期成熟度不同
当前项目会验证两个对比日期完整,并检查整体收入是否能与媒体汇总对上、目标媒体是否能与广告位汇总对上。对账失败时 Run 直接失败,让我们先检查数据与口径。生产项目还应给质量检查单独的状态,例如 data_incomplete,不要把它和模型推理失败混成一个模糊错误。
一条证据需要一个稳定引用
每次 query_metrics 都返回 plan_id、query_id、结构化请求、参数化 SQL、行数、耗时和是否截断。plan_id 标识规范化后的查询意图,query_id 同时包含查询结果;相同请求即使只调整指标排列,plan_id 也保持一致,而数据发生变化时 query_id 会随证据快照变化。
最终报告把内容分成四层:
findings:数据直接支持的观察
conclusion:根据观察形成的当前解释
assumptions:分析成立所依赖的前提
unknowns:当前数据无法回答、仍需核验的事项
课程示例会说“收入下降与 eCPM 下降同步,主要下降贡献集中在某媒体/广告位”,同时把“竞价或策略是否变化”保留在 unknowns。除非我们另外查到了实验、发布、竞价和配置变更记录,否则不应写成“已经确认是价格策略导致”。
Live 模式也需要完成门禁
真实模型很容易查完一次总体指标就开始组织答案。针对本节的“为什么”分析,Live 入口要求至少得到两次非空、互不重复的 Query Observation,才接受最终回答;同时通过 RunGuard 限制最多 8 次查询、12 个步骤、180 秒和 80,000 Token。
这只是最低门槛,不是质量认证。两次查询依然可能选错维度,所以最终还要检查:整体异常是否确认、主要贡献项是否定位、结论是否引用 query_id、关键未知项是否保留。更成熟的实现可以把这些条件写成结构化 AnalysisCompletionGate,再交给固定 Benchmark 检验。
这里还有一个容易忽略的坑:同一条查询重复执行两次,不算两份独立证据。完成门禁会按 plan_id 去重;即使两次执行期间数据发生变化、产生了不同 query_id,相同查询意图仍不能用来凑够查询次数。
三种入口分别验证什么
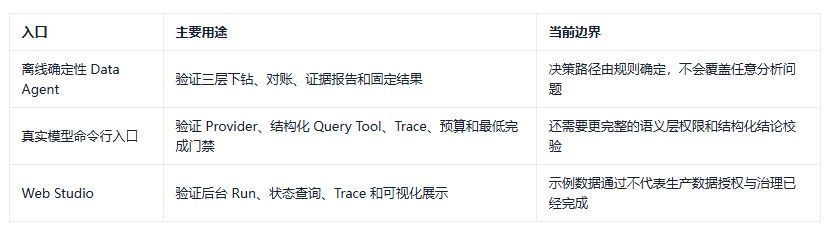
先运行离线模式:
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -r requirements.txt -c constraints-py39.txt
bash start.sh --check
bash start.sh --data
Web Studio 使用 bash start.sh。启动后可以在左侧“模型设置”中填写 DeepSeek API Key,再回到 Data Analysis Agent 页面选择“DeepSeek 真实模型”。Key 只保存在本机服务进程内存中,重启即清除;真实模式会把分析问题、查询计划和必要的 Query Observation 发送到 DeepSeek API,并可能产生费用。
命令行真实模型入口也可以这样运行:
export DEEPSEEK_API_KEY='替换为自己的 Key'
export DEEPSEEK_MODEL='deepseek-flash'  # 可省略,课程默认值
python3 projects/12_final_agents/live_data_demo.py
示例问题已经写明固定日期,避免模型把历史演示数据和当前日期混在一起。这里的数据来自课程生成的本地演示库;换成自己的数据库前,先确认允许哪些字段和聚合结果发送给外部模型服务。
建议补齐的回归场景
正常样例跑通只是起点。我们还要专门准备“会诱导 Agent 犯错”的数据:
整体下降,但某个小广告位变化率最大、贡献很小
基线收入或曝光为 0
其中一天没有数据
媒体汇总与整体结果不一致
查询返回 501 行
相同 Query 被重复调用
eCPM 同步下降,但没有任何策略变更证据
验收不只看结论里的对象名称,还要检查 Query 次数、Query Policy、证据引用、对账结果、未知项和停止原因。这样我们评测的是 Harness 是否可靠,而不是一句答案是否刚好猜中。
动手改写:给结论保留调查余地
把“已确认是广告位价格策略异常”改成“该广告位对收入下降贡献较大,同时观察到 eCPM 下降;接下来需要核对流量构成、竞价和策略变更记录”。再为每个观察附查询来源。参考验收是数值可复算,解释没有超出证据,缺少资料的部分明确列为待验证。
















请登录后查看评论内容