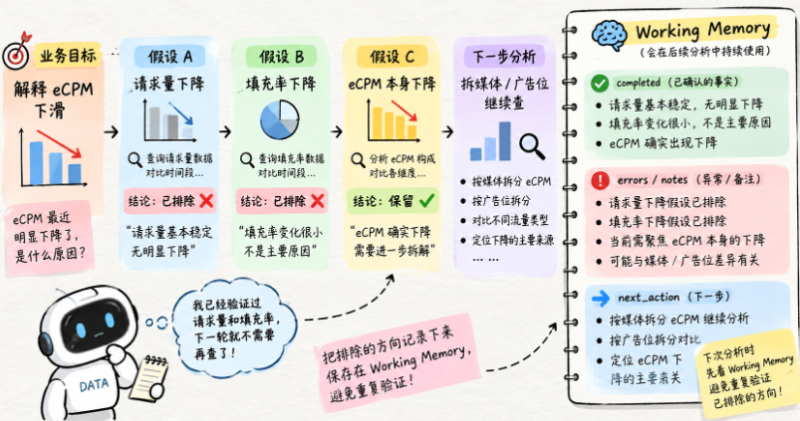


数据分析类任务里,Working Memory 的价值往往更明显。因为分析不是只记“发现了什么”,还要记“哪些方向已经排除了”。下面这张图把一个典型链路拆开:先提出几个假设,再逐个验证,最后把排除项、保留项和下一步动作统一写进 Memory。
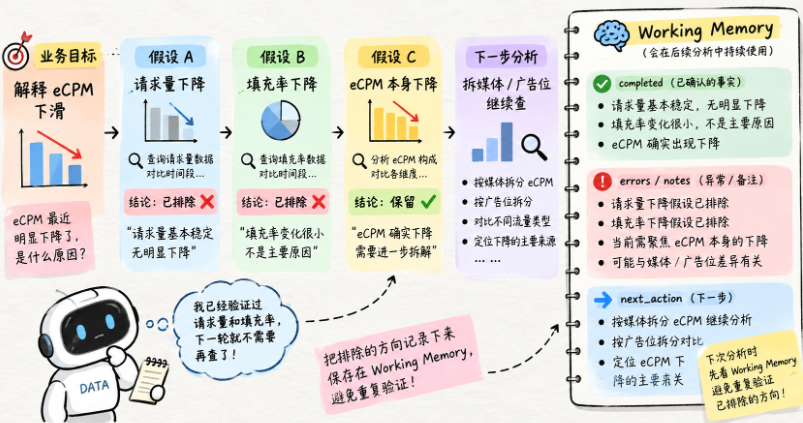
像图里这样,请求量下降和填充率下降已经被排除,那下一轮分析时就不需要再回头重复查一遍了,注意力可以直接集中到 eCPM 本身的下降以及媒体、广告位拆分上。这就是 Working Memory 在分析任务里的另一个核心作用:维持排查进度,避免重复验证。
场景背景
用户问,“为什么昨天广告收入下降?”
Agent 已经查到:
总收入 -20%
请求 +1%
曝光 -3%
eCPM -35%
media_B 降幅最大
这时真正重点已经很明显:
价格 / 变现效率而不是流量。
如果没有 Working Memory
后面再跑十几个 SQL 后,模型可能又:
重新查询 request
重新按媒体拆请求
因为前面“请求稳定”已经埋在历史里。
Working Memory
{
  "goal": "解释昨天广告收入下降原因",
  "plan": [
    "确认整体异常",
    "确定异常维度",
    "下钻异常指标",
    "形成结论"
  ],
  "completed": [
    "已确认收入下降 20%",
    "已确认 media_B 是主要异常来源",
    "已确认请求量基本稳定",
    "已确认 eCPM 下降约 35%"
  ],
  "errors": [],
  "important_files": [],
  "next_action": "继续下钻 media_B 的 eCPM,按广告位定位异常"
}
下一轮
模型不需要重新判断,“到底要查请求还是 eCPM?”
Working Memory 已经明确:
请求方向已基本排除所以直接:
query_by_position(
    media="media_B",
    metric="ecpm"
)
结果
分析更连贯。
也更接近真实分析师的工作方式。
分析师不会每看一张表就忘掉前面的结论。
他们会在脑子里持续维护一个,“当前假设与已排除方向。”
Working Memory 就是在程序里把这件事显式化。
常见误区
误解: Conversation History 已经记录了所有信息,所以 Working Memory 是重复存储。
正解: Conversation History 保存的是完整事件过程,Working Memory 保存的是当前任务认知摘要。前者可能有几十轮 Tool Result 和自然语言交互,后者只保留当前 Goal、Plan、已完成、关键错误、重要文件和下一步。它不是简单复制,而是对 History 的结构化压缩。没有 Working Memory,模型每轮都要重新从历史提炼当前状态。
误解: Working Memory 越详细越好,最好把所有 Tool Result 都复制进去。
正解: 这样会让 Working Memory 失去“短期认知摘要”的意义。完整 Tool Result 应留在 Conversation 或 Trace,Working Memory 只保留会影响下一步的事实与结论,例如“tests/test_api.py 失败”“根因集中在依赖缺失”。它应该帮助模型聚焦,而不是制造第二份历史。
误解: Working Memory 一旦写进去就不能改,因为那是 Agent 之前的结论。
正解: 恰恰相反,Working Memory 表示“当前最好认知”,所以必须允许覆盖和修正。新的 Observation 可能推翻旧假设,已解决错误也应该移除。如果一个已经被证伪的结论永久保留,会持续误导后续决策。历史变化过程可以写入 Trace,当前 Memory 应保持最新。
误解: completed 就是 Tool History,把每个工具调用都记进去。
正解: completed 更适合保存任务层成果,例如“已复现错误”“已确认 requests 未声明”。Tool History 则记录具体调用,例如 read_file("app.py")。前者服务当前认知与规划,后者服务审计、重复检测和 Trace。两者粒度不同,不应混为一谈。
误解: next_action 应该写成下一个必须执行的 Tool Call,这样 Agent 更稳定。
正解: next_action 更适合表达当前焦点,而不是把 Agent 退化成固定 Workflow。例如“确认依赖声明并决定最小修复方式”比“必须执行 read_file(‘requirements.txt’)”更合适。前者保留模型根据新 Observation 调整策略的空间,后者会把 Working Memory 变成死板命令列表。
误解: Working Memory 和 Long-term Memory 都叫 Memory,所以直接共用一个文件或数据库即可。
正解: 两者生命周期不同。Working Memory 服务当前 Run,频繁更新、允许覆盖、任务结束后大部分内容可以丢弃;Long-term Memory 则跨 Session 保留用户偏好、项目长期决策和经验。把两者混在一起,会让短期错误、临时路径、过期计划污染长期知识。后面我们会专门实现 Long-term Memory。
误解: “Agent 当前正在想什么”意味着要保存模型完整的思维过程。
正解: Working Memory 保存的是显式、可审计的工作状态,不是模型的隐式推理文本。我们需要的是“目标是什么、哪些事实有证据、哪些只是待验证假设、下一步做什么”,而不是一份冗长的内心独白。把两者分开,Memory 才容易验证,也更适合进入 Trace 和评测。
















请登录后查看评论内容