

这个案例特别适合看图。左边是“没有 Working Memory”的情况:读 README、读 src/main.py,但没有把关键结论记下来,于是后面又不断重复读取。右边则是“有 Working Memory”的做法:第一次读完就把“入口在 src/main.py”记到 Memory,后面直接进入下一步。
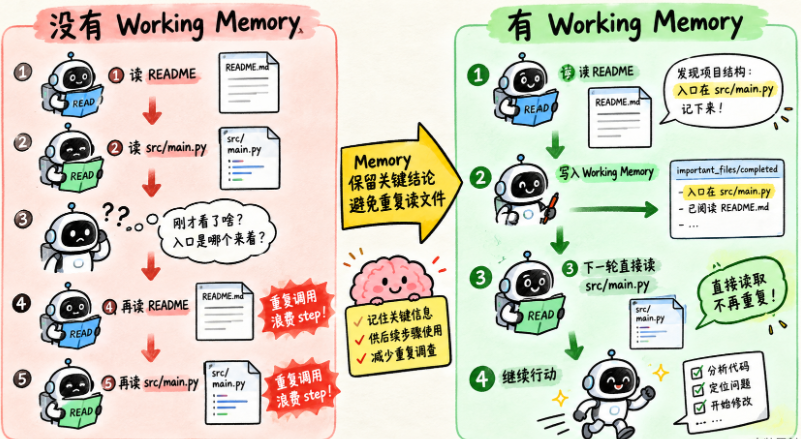
你可以把它理解成一种很实际的节流能力。不是模型不会读文件,而是如果每次都要重新调查同一个问题,step 会被白白浪费掉。Working Memory 在这里最直接的价值,就是让已经确认过的关键结论能被后续步骤复用。
场景背景
用户要求,“修复 API 测试失败。”
Agent 历史已经发生:
Step 1:run pytest
Step 2:read tests/test_api.py
Step 3:read src/api.py
Step 4:search TOKEN
Step 5:read src/config.py
Step 6:read src/api.py
Step 7:read src/api.py
你会发现:
src/api.py连续被读了三次。
问题根因
系统只有 Conversation History。
没有 Working Memory。
每一轮模型都从大量信息里重新找重点。
前一次已经确认的事实:
src/api.py 中 token 校验依赖 API_TOKEN没有被显式保存。
于是模型又读一遍。
改造 Working Memory
在 Step 3 后更新:
completed:
- 已阅读 src/api.py
- 已确认 token 校验读取 API_TOKEN

important_files:
- src/api.py
- src/config.py

next_action:
检查 API_TOKEN 配置来源
Step 5 后:
completed:
- 已确认 src/config.py 未提供默认 API_TOKEN

next_action:
确认测试环境是否设置 API_TOKEN
新行为
下一轮模型看到:
src/api.py 已经读过
当前问题是环境变量
就更容易选择:
search_files("API_TOKEN")而不是重新 read_file。
结果
Tool Call 数量下降。
Context 更稳定。
排障路径更像一个真正“记得自己刚刚做过什么”的工程师。
迁移
这种模式对:
Coding Agent
Research Agent
Data Analysis Agent
Browser Agent
都适用。
任何长任务里,“已完成什么”都值得有显式短期记忆。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容