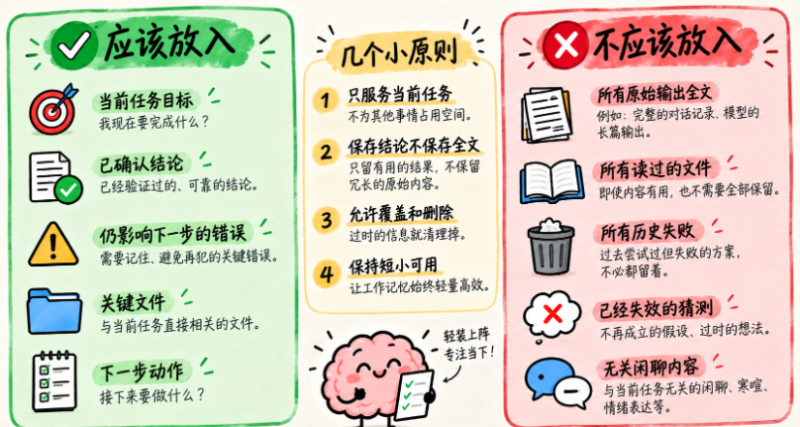


很多同学学到这里会进入另一个极端:既然 Working Memory 这么有用,那是不是多存一点更稳?其实恰恰相反,Memory 一旦没有边界,很快就会变成第二个垃圾桶。下面这张图,左边讲“应该放什么”,右边讲“不应该放什么”,中间是几条特别实用的小原则。
你会发现,真正该留下来的东西并不多:当前任务目标、已经确认的结论、仍影响下一步的错误、关键文件、下一步动作。至于大段原始输出、所有读过的文件、所有历史失败、已经失效的猜测,通常都不该继续堆在里面。
一旦大家意识到 Working Memory 很有用,最容易犯的新错误是,“那我什么都往 Working Memory 里放。”
结果:
最后它又变成另一个大 Context。
所以必须设边界。
第一条:Working Memory 只服务当前任务
它不是永久知识库。
例如:
当前 Run 里确认 app.py 是入口可以放。
任务结束以后未必需要永久保存。
如果这个事实未来 Session 也要用,再考虑写入 Long-term Memory。
第二条:保存结论,不保存完整原始材料
例如 pytest 输出:
500 行Working Memory 不应该塞全部。
更适合:
errors:
tests/test_api.py::test_login failed
root cause suspected: missing requests
完整日志留在 Trace。
第三条:只保存仍然影响下一步的错误
已经解决的错误,可以移出。
否则模型每轮看到:
ModuleNotFoundError即使已经修好,也可能继续围绕它行动。
第四条:important_files 不是“所有读过的文件”
Agent 读过:
README
LICENSE
setup.cfg
app.py
service.py
test_api.py
真正和当前根因强相关的可能只有:
service.py
test_api.py
Working Memory 应该保留后者。
读过什么属于 Tool History。
什么重要属于 Working Memory。
第五条:next_action 应该具体但不能过度死板
差:
继续处理任务太模糊。
也不要:
必须执行 read_file("requirements.txt")过度写死。
更好:
确认依赖声明是否缺少 requests,并决定最小修复方式它给模型方向,但仍保留决策空间。
第六条:Working Memory 要允许重构
任务中途发现原计划错了,可以整体更新。
例如:
原 plan:
查数据库 → 查缓存 → 查依赖

新证据:
启动阶段还没连数据库

新 plan:
查依赖 → 修复 → 验证
Working Memory 应该忠于“当前最好认知”,而不是忠于历史。
一个带限制的 WorkingMemory
可以加:
max_completed
max_errors
max_files
防止无限增长。
Working Memory 要不要版本化?
后面做 Tracing 时很有价值。
例如:
Step 5 Working Memory
Step 6 Working Memory
Step 7 Working Memory
这样可以复盘,Agent 是在哪一步开始认知跑偏的?
但当前 State 只保存最新版本即可。
历史 Snapshot 写 Trace。
这又体现:
Current State
vs
Historical Trace
的边界。
持久化不等于长期记忆
这个边界非常容易被混淆,所以我专门补了一张图。上半部分画的是一个任务从开始、初始化、执行中持续更新,到结束后清理或归档的完整生命周期;下半部分则把 Working Memory、长期记忆 / 持久化知识、Conversation History 三者的职责拆开对照。
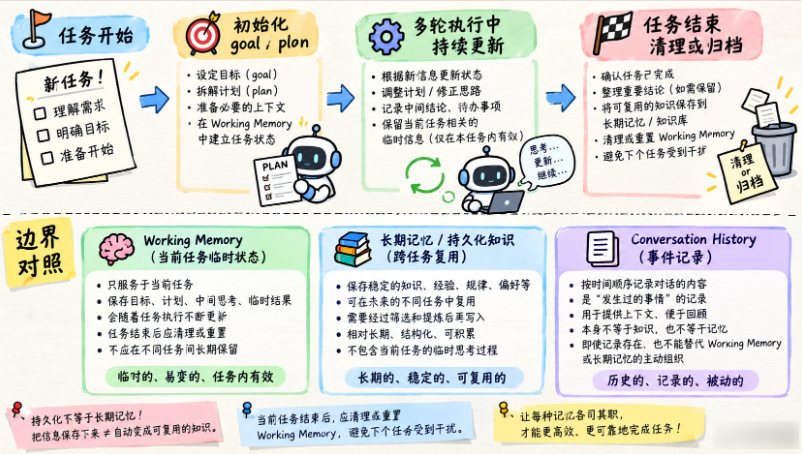
图里最重要的一句话可以直接记住:持久化只是把当前任务状态保存下来,不等于它已经变成可复用的长期知识。 Working Memory 是临时的、易变的、任务内有效;长期记忆则应该是提炼后的稳定知识,两者不能混写。
长任务可能因为进程重启、人工审批或等待外部系统而暂停,所以 Working Memory 可以落盘,供同一个 Run 恢复。这只是在保存当前任务快照,并不会让它自动变成 Long-term Memory。
落盘时有两个容易忽略的小坑。第一,文件名或 Session ID 不能直接拼接未经校验的用户输入,否则 ../ 之类的路径可能把文件写到存储目录之外。第二,直接覆盖 JSON 时如果进程中断,文件可能只写了一半。配套项目中的 FileMemoryStore 会校验简单名称,并先写临时文件再原子替换目标文件。
在配套项目里跑一次完整链路
这一节对应的核心实现位于:
src/agent_harness/context/memory.py
projects/05_context_memory_session/main.py
项目版 WorkingMemory 在最小字段之外,还加入了 findings、facts、hypotheses、open_questions 和 constraints。可以把 facts 理解成附带来源的原子证据,把 findings 理解成根据多条证据整理出的阶段性结论。两者不必互相替代:一个回答“我们观察到了什么”,另一个回答“这些观察目前说明什么”。
进入 agent_harness_course_projects 后运行:
python3 --version
python3 projects/05_context_memory_session/main.py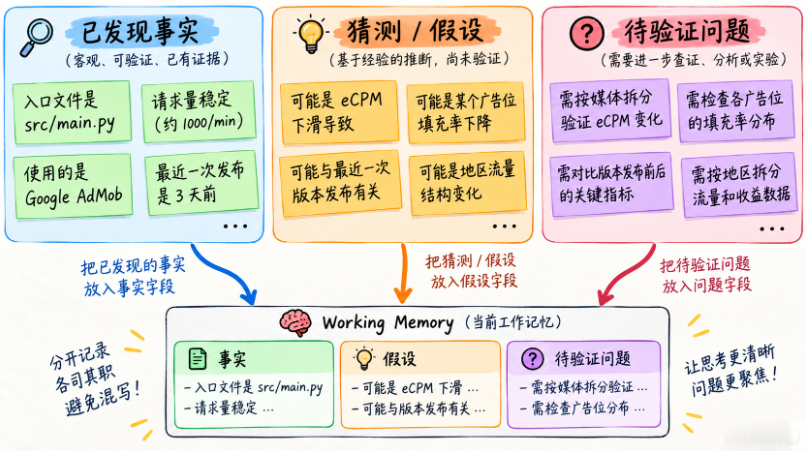
这张图本质上是在提醒我们:事实是事实,假设是假设,待验证问题还是待验证问题。 只要这三类信息分开写,后面模型的判断就会清晰很多,也不容易把自己的推测误当成结论继续往下推。
我们看到收入下降,模型提出“可能是价格变化”。这时只能记录一条假设。等查询确认 eCPM 下降以后,我们才能记录“某日期的 eCPM 较上一日下降”的事实。至于具体是哪项业务策略导致,还需要新的证据。把这三步混在一起,后续模型就可能把自己的猜测当成调查结论。
Working Memory 保存的是显式工作状态,不是读取模型隐藏的思维。可以为事实记录来源、适用时间与验证状态,为假设记录待执行的验证动作,为约束记录来源和适用范围。置信度数字本身也需要含义,模型写下 0.9 并不自动构成统计概率。
还有一个常见混淆:Memory 中出现的文字不等于可信指令。文件内容、网页文本或工具输出里即使写着“忽略之前规则”,也仍然只是外部数据。我们既要记录来源,也要保持权限边界,不能让一条被保存下来的不可信内容在下一轮变成高权限 Prompt。
新的证据可能推翻旧事实的适用范围。我们应把旧记录标为已更正或已失效,留下新的来源,而不是无痕覆盖。这样下一轮看到的是当前结论,复盘时仍能查到判断如何变化。
动手整理:一句话该放在哪里
把“测试返回码为 1”“可能缺少依赖”“用户要求不增加依赖”分别放入事实、假设和约束。参考答案是:第一项附测试输出来源,第二项附检查环境的待办,第三项保持为任务约束。即便后来确认依赖缺失,也不能因此自动忽略用户要求。
















请登录后查看评论内容