

讲到这里,Working Memory 终于不是“概念上很好”,而是要真正接进上下文构建链路里。下面这张图把 ContextBuilder 常见的输入块都摆出来了:System Prompt、用户当前请求、最近几轮 Conversation、Working Memory 渲染块,以及可用 Tool Schemas。
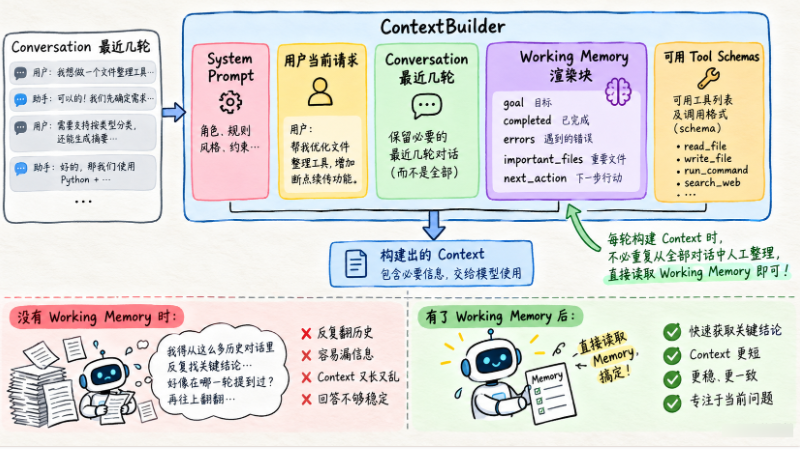
图的下半部分也顺手做了一个对照:没有 Working Memory 时,模型得反复翻历史对话找关键信息;有了它之后,就能直接读当前任务快照。换句话说,它并不是替代 Conversation,而是把真正高频会被后续使用的信息 提前整理好。
上一节我们实现:
ContextBuilder现在就可以把 Working Memory 作为高相关度的 Context Source。这里说的“高优先级”是内容选择上的优先保留,不是消息权限上的提权:Memory 仍然是可能过期、也可能出错的任务状态,不能覆盖 System、项目规则和用户明确约束。
Working Memory 应该放在什么位置?
一个实用顺序可以是:
System Prompt
Agent Rules
Project Rules
Relevant Skills
Working Memory
Conversation
Recent Tool Results
Current Task
为什么 Working Memory 比老 Conversation 更靠前?
因为它代表,当前任务最重要的压缩认知。
格式化 Working Memory
可以转成:
## Working Memory

Goal:
修复 Flask 项目启动失败

Plan:
- 复现错误
- 定位根因
- 修复
- 验证

Completed:
- 已复现 ModuleNotFoundError
- 已确认 requests 未声明

Errors:
- ModuleNotFoundError: requests

Important Files:
- app.py
- requirements.txt

Next Action:
修复 requirements.txt 后重新运行
这对模型非常清晰。
实现 render()
把它接进 ContextBuilder
这里没有把 Working Memory 拼进 system,也没有把脱离原始调用协议的结果伪装成 tool 消息。原因很简单:任务状态和工具输出都是数据,不是更高权限的指令。真正对接模型 API 时,原生 tool 消息通常还必须关联对应的 Tool Call ID;如果这里只保留了摘录,把它作为带清晰标签的普通上下文更稳妥。
这里已经发生一个非常重要的变化。
我们不再依赖:
完整 Conversation才能保持任务连续性。
因为 Working Memory 已经把关键认知提炼出来。
这是不是意味着 Conversation 可以完全不带?
不是。
Working Memory 是摘要。
Conversation 保留细节。
模型有时需要用户原话。
例如用户说,“只修改业务代码,不要碰测试。”
如果 Working Memory 只摘要成:
用户希望谨慎修改信息可能失真。
所以高价值原始指令仍然应该保留。
更合理是:
Working Memory:
当前认知主干

Conversation:
最近几轮原始上下文

Tool Results:
最近关键环境反馈
三者配合。
为什么 Working Memory 会降低重复 Tool Call?
因为模型每轮都看到:
Completed:
- 已读取 app.py
- 已检查 requirements.txt
它更不容易:
再次 read app.py
再次 read requirements.txt
当然这不能 100% 保证。
Harness 仍然要做重复 Tool Call 检测。
但 Working Memory 会明显改善。
为什么 Working Memory 会降低 Context 压力?
假设前 30 步历史共:
30000 字Working Memory 可能只需要:
1200 字如果我们只保留:
Working Memory
+
最近 4 轮 Conversation
+
最近 3 个 Tool Result
下一轮 Context 就能小很多。
这也是后面 Context Compaction 的基础。
















请登录后查看评论内容