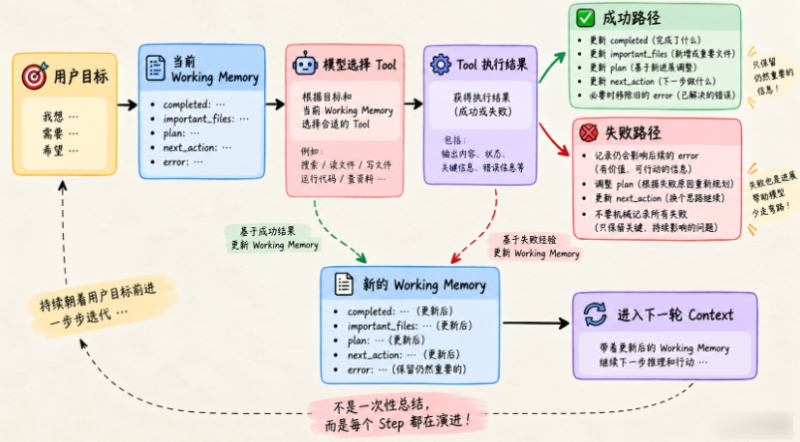


这一部分建议先配合流程图理解。图里把“用户目标 → 当前 Memory → 选 Tool → 执行结果 → 更新 Memory → 进入下一轮 Context”这条链路串了起来,能很清楚地看到:Working Memory 不是任务开头写一次就不管了,而是每个 Step 都在演进。
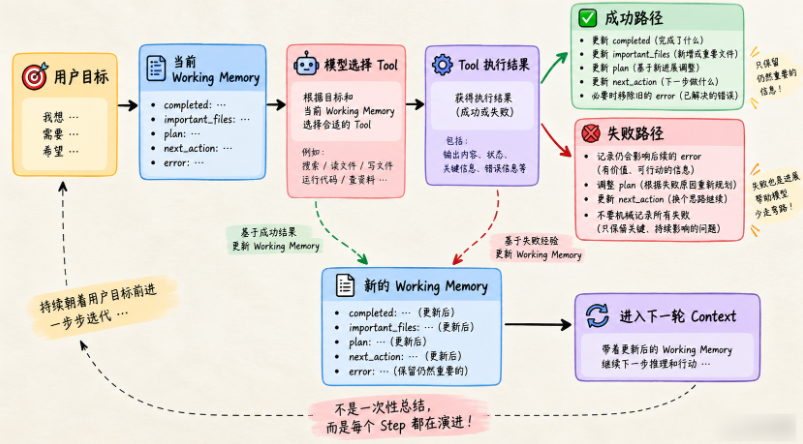
尤其是右侧分成了成功路径和失败路径,这一点很关键。成功不只是记“完成了什么”,失败也不是一股脑全记下来,而是保留那些仍然影响后续动作 的信息。这样更新出来的 Memory 才是有用的,而不是流水账。
Working Memory 如果只在任务开始时创建一次,然后不再更新,就失去意义。
真正正确的理解是,它和 Agent State 一样,会随着 Main Loop 不断变化。
Tool 成功后更新什么?
例如:
read_file("requirements.txt")成功。
Tool Result:
Flask==3.0.0Agent 得出:
requests 未声明那么 Working Memory 可以更新:
completed:
+ 已检查 requirements.txt

errors:
保留 ModuleNotFoundError: requests

important_files:
确保 requirements.txt 存在

next_action:
决定是否修改依赖文件并重新验证
Tool 失败后怎么更新?
例如:
read_file("config.py")失败:
FileNotFoundErrorWorking Memory 可以:
errors:
+ config.py 不存在

completed:
不新增“读取 config.py”

next_action:
先 list_files 查找真实配置文件
这和前面第 10 节讲过的 Tool Error Recovery 完全接上。
Working Memory 不应该机械记录所有动作
例如 Agent 调了:
list_files没必要一定写:
completed:
已执行 list_files
更有价值的是写:
completed:
已确认项目入口位于 src/main.py
也就是说,Working Memory 记录“认知结果”,不是“函数调用日志”。
调用日志属于 Trace。
这是一个特别重要的边界。
一个简单 WorkingMemoryManager
如果前面说的是“原则”,那这里就更像“怎么落地”。下面这张图把 WorkingMemoryManager 常做的四类整理动作都画出来了:去重、覆盖更新、删除、重构。这样看一眼,你会更明白为什么 Memory 不能只会追加,还必须会整理。
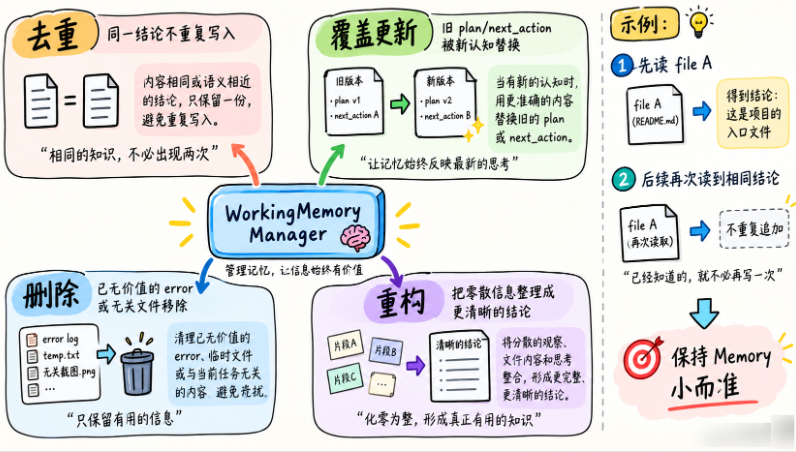
图右侧还给了一个小例子:先读到 file A,得到“这是项目入口文件”这个结论;后面再读到同样结论时,就没必要重复写入了。保持 Memory 小而准,其实靠的就是这种管理动作长期发挥作用。
为什么要去重?
如果 Agent 连续几轮都确认:
app.py 很重要Working Memory 不应该变成:
app.py
app.py
app.py
去重能减少噪声。
Working Memory 需要删除吗?
需要。
这也是它和 History 最大区别之一。
Conversation History 通常是:
发生过就存在Working Memory 则允许:
覆盖
更新
删除
例如:
errors:
ModuleNotFoundError: requests
修复并验证成功后,这个错误不应该永久占据当前 Memory。
可以:
resolved_errors:
...
或者直接从当前 errors 移除。
本节先采用简单移除。
Plan 也可以更新
原计划:
1. 检查数据库
2. 检查依赖
3. 验证
但第一轮发现:
数据库根本没参与启动可以调整:
plan:
1. 检查依赖
2. 修复依赖声明
3. 验证
Working Memory 是当前认知,不是历史文档。
所以允许重写。
让模型负责更新还是 Harness 负责更新?
这是一个非常关键的问题。
有两类信息。
第一类,Harness 可以确定。
例如:
Tool 成功
Tool 失败
调用了哪个文件
这些可以程序化更新。
第二类,需要语义判断。
例如:
根因是依赖缺失
数据库方向已排除
下一步应该检查依赖声明
这些更适合让模型生成结构化 Memory Update。
因此真实系统很常见的是:
Harness 自动更新客观状态
+
LLM 更新语义摘要
后面我们可以设计:
{
  "completed_add": [
    "已确认缺失 requests"
  ],
  "important_files_add": [
    "requirements.txt"
  ],
  "next_action": "修复依赖声明"
}
再由 Harness 合并。
这样不会让模型直接随意覆盖整个 State。
这里还要再加一道合并边界。LLM 给出的 Memory Update 只是“候选补丁”,Harness 至少要检查:字段是否在白名单中、数据类型是否正确、列表是否超出容量、事实有没有来源、用户约束是否被悄悄删除。尤其是 goal 和 constraints,不能因为模型生成了一份新摘要就被无声改写。
如果同时有多个工具返回结果,也不要让它们各自拿旧 Memory 整体覆盖。更稳妥的方式是按 Step 或版本合并增量,并把每次合并后的快照写进 Trace。这样遇到并行结果时,我们知道谁更新了什么,也能看出某条结论从哪一步开始偏离证据。
















请登录后查看评论内容