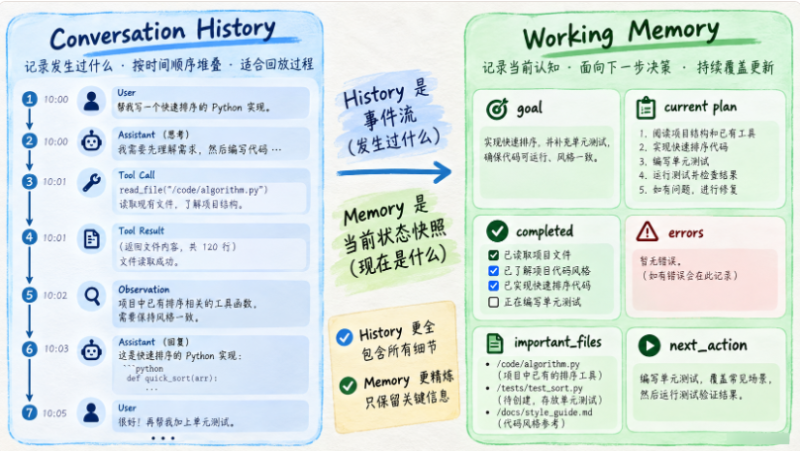


先看一张对照图,很多同学看到这里一下就能把两个概念分开了。左边是按时间顺序堆起来的 History,适合回放“发生过什么”;右边是面向下一步决策的 Working Memory,更像当前任务状态的摘要面板。
这张图最值得注意的一点,是 History 更全,但 Memory 更聚焦。也就是说,History 负责保留过程,Memory 负责提炼出“现在到底知道了什么、下一步该干什么”。后面你再看字段设计、更新策略和 Context 拼接时,都会更顺畅。
这一节最重要的第一句话就是,Conversation History 和 Working Memory 并不是一回事。
如果这一点没分清,后面 Agent 长任务很容易失控。
Conversation History 是“事件流”
例如:
User:
修复项目启动错误。

Assistant:
我先看项目目录。

Tool:
["README.md", "app.py", "requirements.txt"]

Assistant:
我先运行项目。

Tool:
ModuleNotFoundError: requests

Assistant:
我检查 requirements.txt。

Tool:
Flask==3.0.0
它非常完整。
但也非常冗长。
Working Memory 是“当前认知”
从上面历史里,我们可以提炼:
goal:
修复项目启动错误

completed:
- 已查看项目目录
- 已复现启动错误

errors:
- ModuleNotFoundError: requests

important_files:
- app.py
- requirements.txt

next_action:
确认 requirements.txt 缺少 requests,并决定修复方式
它不关心每句 Assistant 原话。
也不关心 Tool Result 的所有细节。
它关心,哪些信息会直接影响下一步。
为什么不能每轮都让模型自己总结历史?
理论上可以。
例如每轮:
请阅读以上 30 条历史,并判断当前任务状态。问题有三个。
第一,浪费 Token。
第二,重复推理。
第三,结果不稳定。
同样 30 条历史,模型不同轮可能总结出不同重点。
Working Memory 的价值就在于,把“当前认知”显式保存,而不是每次重新计算。
Working Memory 是“状态的一部分”还是“Context 的一部分”?
两者都是。
从 Agent State 角度:
Working Memory 是当前 Run 状态的一部分。从 ContextBuilder 角度:
Working Memory 是下一轮模型的重要上下文来源。所以结构可以是:
@dataclass
class AgentState:
    ...
    working_memory: WorkingMemory
然后:
context_builder.build(
    state=state
)
自动加入。
Working Memory 最基础字段
如果把 Working Memory 想成一个“当前任务状态卡片”,下面这张图会特别直观。它把最小可用版本拆成 6 个常见字段:目标、计划、已完成、错误、关键文件和下一步动作,最后共同汇成当前任务状态。
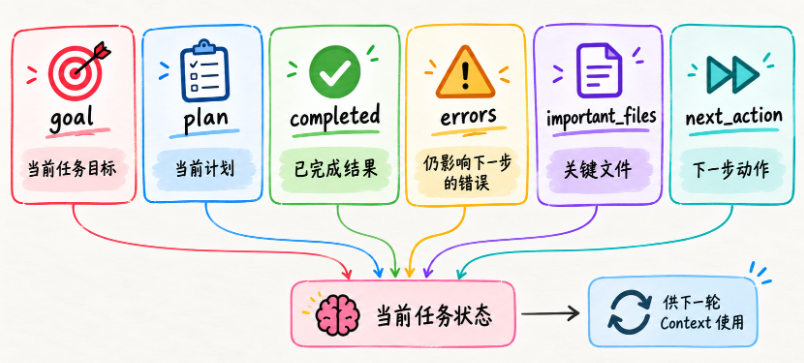
你可以把它理解成:模型每走一步,都在给这张状态卡片补充或修正内容。这样后面的每一轮推理,不是重新从一大堆对话里“翻旧账”,而是先读取这一份更短、更清晰的任务快照。
我们先采用一套最小结构:
{
    "goal": "",
    "plan": [],
    "completed": [],
    "errors": [],
    "important_files": [],
    "next_action": ""
}
逐个来看。
goal
当前 Run 的总目标。
例如:
修复项目启动失败它通常不会每一轮改变。
但可能被用户澄清。
例如原本:
修复所有测试用户后来补充:
只修 API 模块,不动数据库模块。Working Memory 中的 Goal 就应该更新。
plan
当前工作计划。
注意,plan 不是必须一次生成完整。
可以很简单:
1. 复现错误
2. 定位根因
3. 修改
4. 验证
后面 Planner 章节再系统设计。
本节只把它作为短期工作记忆字段。
completed
已经明确完成的事项。
例如:
已读取 README
已复现错误
已排除数据库问题
它非常重要。
因为 Agent 重复动作,很多时候就是不知道自己已经做过。
errors
不是完整异常日志。
而是当前仍有决策价值的错误。
例如:
ModuleNotFoundError: requests后面错误修复并验证通过后,可以把它标记为 resolved,或者从当前 errors 移出。
important_files
当前任务真正关键的文件。
例如:
app.py
requirements.txt
tests/test_api.py
这样 ContextBuilder 可以优先保留这些文件相关信息。
next_action
当前最应该推进的动作。
例如:
检查 requirements.txt 是否缺少 requests它不是强制命令。
只是 Agent 当前认知中的“下一步焦点”。
下一轮模型仍可以根据新上下文调整。
一个最小 WorkingMemory 数据类
from dataclasses import dataclass, field


@dataclass
class WorkingMemory:
    goal: str
    plan: list[str] = field(
        default_factory=list
    )
    completed: list[str] = field(
        default_factory=list
    )
    errors: list[str] = field(
        default_factory=list
    )
    important_files: list[str] = field(
        default_factory=list
    )
    next_action: str = ""


if __name__ == "__main__":
    memory = WorkingMemory(
        goal="修复 Flask 项目启动失败"
    )

    memory.plan = [
        "复现错误",
        "定位根因",
        "修复",
        "重新验证",
    ]

    memory.completed.append(
        "已复现错误"
    )

    memory.errors.append(
        "ModuleNotFoundError: requests"
    )

    memory.important_files.extend([
        "app.py",
        "requirements.txt",
    ])

    memory.next_action = (
        "检查 requirements.txt "
        "是否缺少 requests"
    )

    print(memory)
这段代码已经具备最基础结构。
















请登录后查看评论内容