


3.5 数据清洗与预处理
章节核心内容关键知识点1. 缺失值处理检测、删除和填充缺失值的方法isna(), dropna(), fillna(), 前向/后向填充, 均值/中位数填充2. 重复数据处理识别和删除重复行 duplicated(), drop_dup...
2. 重复数据处理
方法/操作语法示例描述检测重复行df.duplicated() 返回布尔序列标记重复行(首次出现的行标记为False)删除重复行df.drop_duplicates() 保留首次出现的行(默认检查所有列) df....
3. 数据类型转换
方法/操作语法示例描述查看数据类型df.dtypes显示每列的数据类型强制类型转换df['col'].astype('int')将列转换为指定类型(如int, float, str, datetime)转换为日期时间pd.to_datetime(df['col...
4. 数据重塑与变形
方法/操作语法示例描述行列转置df.T转置DataFrame(行变列,列变行)宽表转长表pd.melt(df, id_vars=['id'])将多列合并为键值对形式(variable和value列)长表转宽表df.pivot(index='id', colum...
6. 数据分箱与离散化
方法/操作语法示例描述等宽分箱pd.cut(df['col'], bins=3)将数值列分为等宽区间(如分为低/中/高)等频分箱pd.qcut(df['col'], q=4)将数值列分为等频区间(每箱数据量相同) cut() pandas.cut()...
3.4 数据的导入与导出
导出数据 方法说明to_csv() 将数据保存为csv格式文件,数据之间以逗号分隔,可通过sep参数设置使用其他分隔符,可通过index参数设置是否保存行标签,可通过header参数设置是否保存列标签。...

3.6 时间数据的处理
Timestamp 是 pandas 对 datetime64 数据类型的一个封装。datetime64 是 NumPy 中的一种数据类型,用于表示日期和时间,而 pandas 基于 datetime64 构建了 Timestamp 类,以便更方便地在...
3.6 时间数据的处理
Timestamp 是 pandas 对 datetime64 数据类型的一个封装。datetime64 是 NumPy 中的一种数据类型,用于表示日期和时间,而 pandas 基于 datetime64 构建了 Times...
3.7 数据分析与统计
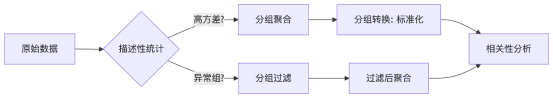
分类依赖关系协同应用场景示例描述性统计所有分析的基础初步了解数据分布,指导后续分组策略df.describe() 发现某列标准差大 → 触发分组过滤分组聚合基于描述性统计或分组过滤结果按...
3. 一次计算多个统计值
可以通过agg()或aggregate()进行更复杂的操作,如一次计算多个统计值。 df = pd.read_csv('data/employees.csv') # 读取员工数据 # 按department_id分组,计算salary的最小值,中位数,最...

