




7.5. 集合的数学运算
集合的数学运算如下: s1 = {10, 20, 30, 40, 50, 60} s2 = {40, 50, 60, 70, 80, 90} # 并集 result = s1 | s2 print(result) # 交集 result = s1 & s2 print(result) # 差集 result = s1 ...
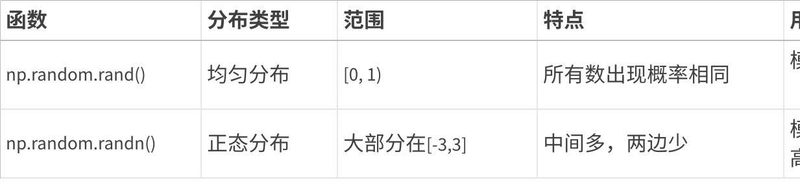
2.2.3.5 随机数组
(1) 均匀分布随机数 (np.random.rand) 返回给定形状的数组,用 [0, 1) 上均匀分布的随机样本填充。 rand_arr = np.random.rand(2, 2) # [0,1) 均匀分布 # 输出示例: [[0....
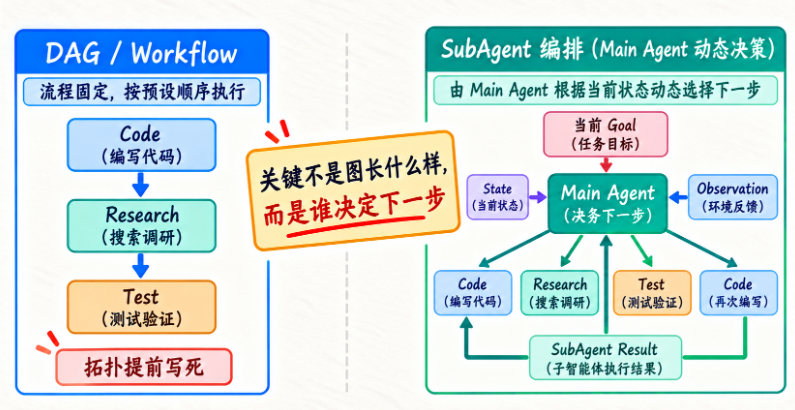
小节四:Main Agent 如何做动态分派——真正的 Agentic Orchestration 在这里
这一节最核心的地方,不是“有多少个 Agent”,而是“下一步由谁来决定”。如果 Main Agent 能根据 Goal、State 和 Observation 动态改变调用顺序,那才是真正的 Agentic Orchestration。下面这...
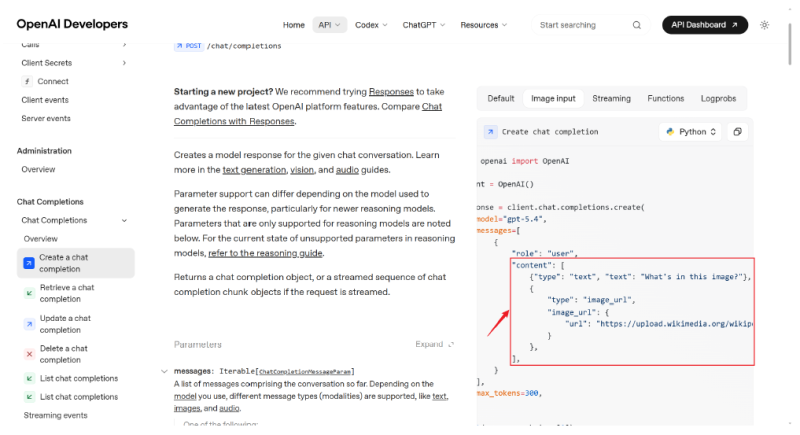
1.6 实战
1.6.1 对话历史管理关键规则:每次调用必须传递完整的对话历史!也就是说: 第 1 轮: [system, user] → AI回复 → 保存回复 第 2 轮: [system, user, assistant, user] → AI回复 →...
人工智能行业缺人
人工智能行业缺人!这是一个 容量巨大、上不封顶的赛道!随着人工智能大模型的应用逐渐成为各行业发展新的重要推动力,市场 规模呈现爆发式增长。 人工智能的发展,数据是基础,芯片是高地,算...
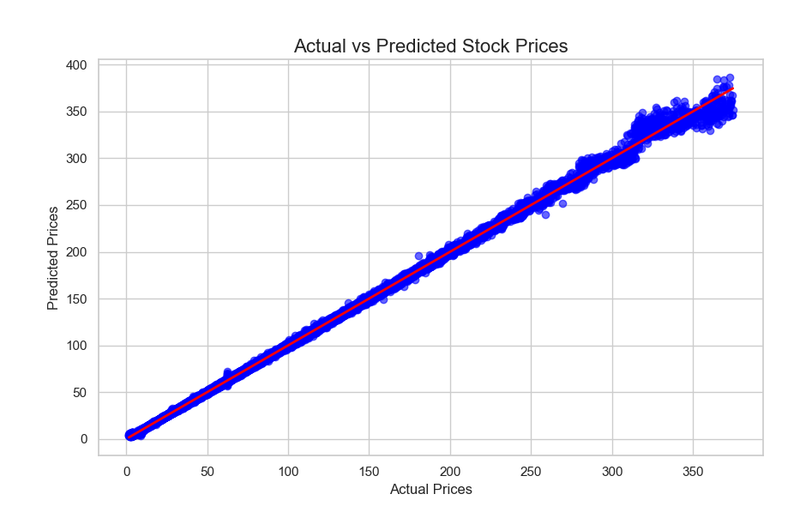
6. 结果分析与解读
在前面的步骤中,我们使用 XGBoost 模型对股票市场数据进行了训练,并使用均方误差(MSE)、均方根误差(RMSE)和决定系数(R²) 对模型性能进行了评估。 现在,我们将详细分析...
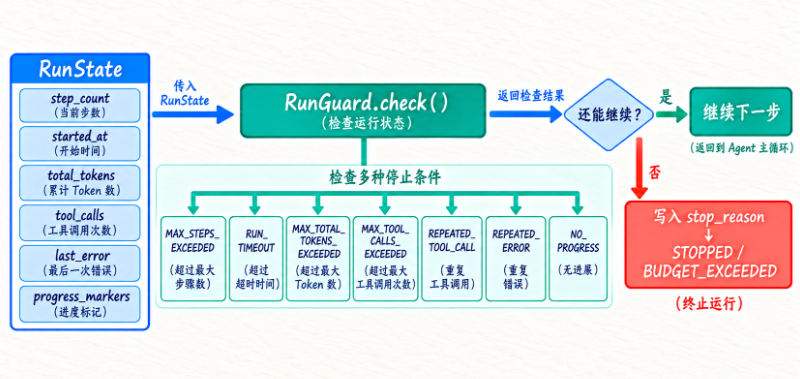
小节五:比 MAX_STEPS 更聪明的停止条件——重复 Tool、重复 Error、No Progress
有了硬预算之后,系统已经不会彻底失控了。但如果每次都非得等到第 30 步、第 300 秒或者第 50,000 Token 才停,那依然会浪费很多资源。所以更成熟的做法,是尽早识别出“虽然还没超预算,但已...
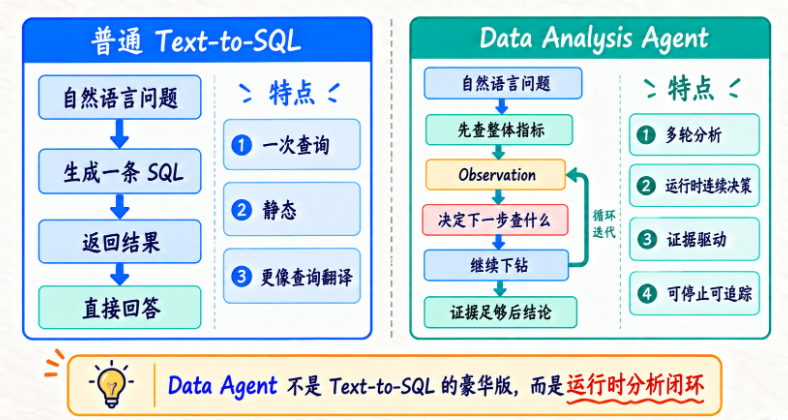
小节一:为什么 Data Agent 不是 Text-to-SQL 的“豪华版”——最大的区别是运行时连续决策
把普通 Text-to-SQL 与 Data Analysis Agent 并排看,会更容易理解这一节讨论的并不是模型能不能生成 SQL,而是查询结果是否会改变后续决策。 左边完成单次翻译、执行和回答;右边根据本轮结果...
章末自测
题目 1:为什么“LLM + 三个工具”不一定是 Agent? 某系统接入了一个大模型,并提供“查天气”“计算器”“网页搜索”三个工具。程序固定规定:每次请求都先搜索网页,再查天气,最后调用计算...
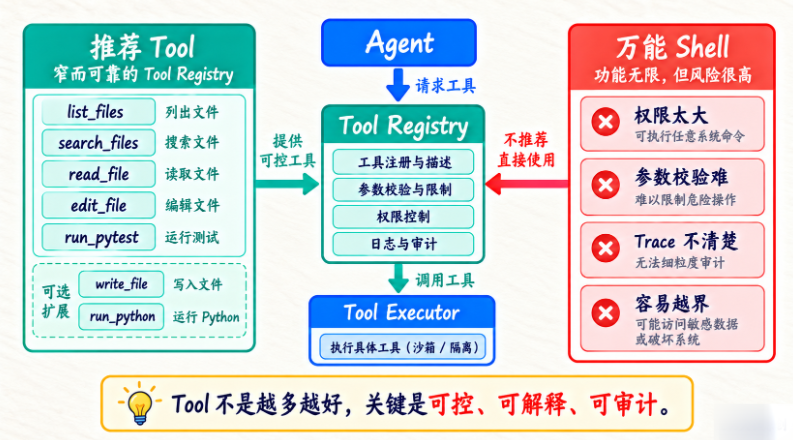
小节二:Tool Registry 怎么设计——Coding Agent 需要的是“窄而可靠”的 Tool,而不是万能 Shell
这里建议大家把重点放在“可控”两个字上。Tool 不是越多越好,也不是给一个万能 Shell 就算完事。真正好用的 Tool Registry,一定是参数可校验、权限可限制、执行可审计。下面这张图把“窄而可...

