

把普通 Text-to-SQL 与 Data Analysis Agent 并排看,会更容易理解这一节讨论的并不是模型能不能生成 SQL,而是查询结果是否会改变后续决策。
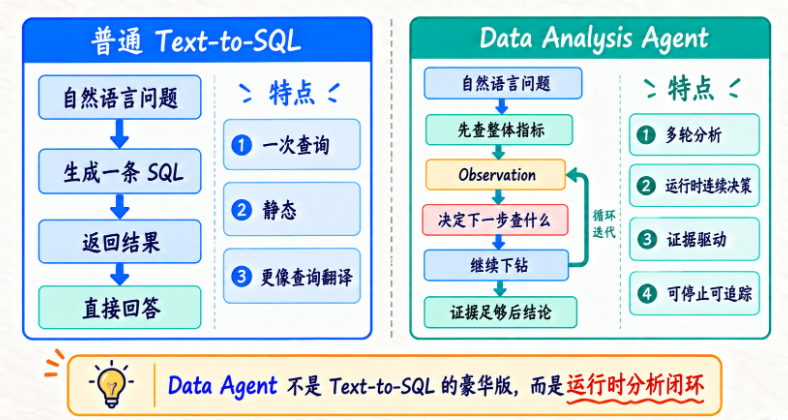
左边完成单次翻译、执行和回答;右边根据本轮结果选择下一轮验证方向。并不是每个问题都需要多轮分析,范围明确的简单查询仍然适合直接执行。
先把两个系统彻底分开。
普通 Text-to-SQL
最典型流程:
Question
 ↓
SQL Generation
 ↓
Execute SQL
 ↓
Result
 ↓
Answer
例如:
“昨天收入多少?”非常适合。
因为用户的问题本身就是:
一次查询可回答。Data Analysis Agent
用户问:
“为什么昨天收入下降?”这个问题不是一个单一 SQL 问题。
而是:
一个分析目标。第一轮 SQL 只负责:
建立事实。第二轮 SQL:
验证某个假设。第三轮 SQL:
进一步定位异常范围。所以 Data Agent 更像:
Goal
 ↓
Hypothesis
 ↓
Query
 ↓
Observation
 ↓
Update Hypothesis
 ↓
Next Query
关键公式
传统 Text-to-SQL 可以抽象成:
SQL = LLM(Question)Data Agent 更像:
NextQuery
=
LLM(
    Goal,
    AnalysisState,
    PreviousObservations
)
这是两者本质差异。
为什么一条“超级 SQL”也不够?
有人可能说,“那我一次 SQL 把媒体、广告位、请求、曝光、点击全部查出来不就行了?”
理论上有时可以。
但问题是:
你一开始并不知道哪些维度值得查。如果每次都:
全维度
全指标
全明细
会导致:
扫描量巨大
返回数据巨大
Context 巨大
分析噪声巨大所以成熟分析更像,先整体,再定位,再下钻。
这和经验丰富的数据分析师工作方式非常像。
Agent 的价值不是“多查几次”
真正价值是:
每次查询以后,
根据 Observation 决定下一次最有价值的查询。
不是机械:
总指标
→ 媒体
→ 广告位
→ 小时
→ 地域
全部查一遍。
如果总指标发现:
请求量 -40%
eCPM 稳定
那下一步就应该优先查:
流量来源
请求维度
而不是继续查:
价格。这就是动态决策。
什么时候仍然适合 Text-to-SQL?
非常重要。
并不是有了 Data Agent,就不要 Text-to-SQL。
例如:
昨天收入多少?
上周点击率多少?
媒体 A 本月曝光量是多少?
这些问题:
单次查询就能回答。直接 Text-to-SQL 更快、更便宜、更稳定。
只有:
为什么
异常在哪里
主要原因是什么
继续帮我定位
这种开放分析问题,Agent 才真正有价值。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END















请登录后查看评论内容