

- 为什么质量不合格时仍可能得到 completed?区分运行生命周期与业务结论。
- 为什么不能直接平均每行 eCPM?说明曝光量权重。
- 为什么两个非空查询不够?它们可能缺乏比较窗口、分组或有效引用。
- 为什么三项分解对账成功仍不代表因果?计算恒等式与业务机制证据不同。
- 为什么多个维度的贡献不能直接相加?它们包含重叠的同一批收入。
- 什么情况下应停止?质量不足、证据已足够、预算耗尽或用户取消,需要分别记录原因。
基础机制与最小演示(保留原有讲解)
下面的两日数据、简化分析循环与服务片段用于理解基础机制。增强版的数据规模、完成门禁和项目入口以本节前面的 capstone/ 实现为准。
这一节,是整门课程最后一个正式实战。
上一节我们已经做出了一个 Coding Agent:
用户任务
 ↓
扫描项目
 ↓
读取 AGENTS.md
 ↓
查找相关文件
 ↓
读取代码
 ↓
运行测试
 ↓
分析报错
 ↓
修改代码
 ↓
再次测试
 ↓
输出修改报告这条链路的核心是,代码世界里的 Observation 会不断改变 Agent 的下一步动作。
例如:
pytest 失败
→ 读取 traceback

错误类型变化
→ 重新定位问题

测试通过
→ 进入 Completion Gate
现在,我们把同一个思想搬到数据分析场景。
用户不再问,“这个文件为什么报错?”
而是问,“为什么昨天收入突然下降?”
这句话看起来很简单。
但真正有经验的数据分析过程,绝对不是:
问题
 ↓
SQL
 ↓
答案
因为第一条 SQL 通常只能告诉我们:
收入确实下降了。接下来还要继续问:
是流量下降还是变现效率下降?
请求有没有降?
曝光有没有降?
点击有没有降?
eCPM 有没有变?
哪个媒体最异常?
哪个广告位贡献最大?
异常集中在哪个时间段?
所以真正 Data Agent 的流程应该是:
问题
 ↓
SQL
 ↓
观察结果
 ↓
决定下一步查什么
 ↓
SQL
 ↓
继续观察
 ↓
继续分析
这才是真正的 Data Analysis Agent。
这一章我们会完整实现:
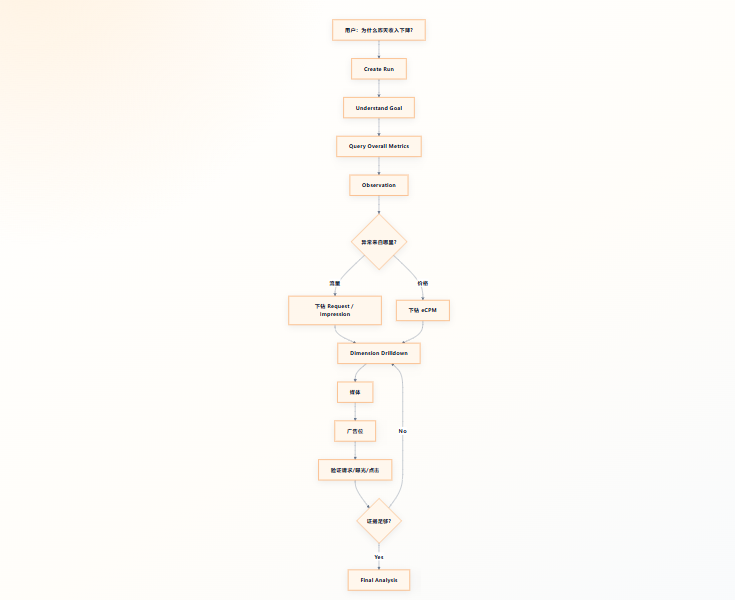
用户提出异常问题
 ↓
Agent 理解目标
 ↓
选择 Query Tool
 ↓
查询总指标
 ↓
发现异常指标
 ↓
继续拆维度
 ↓
查询媒体
 ↓
查询广告位
 ↓
查询请求 / 曝光 / 点击
 ↓
定位异常来源
 ↓
验证结论
 ↓
输出分析报告
最终使用:
Python
+
Flask
+
LLM
+
Tool Registry
+
Working Memory
+
Tracing
+
Query Policy
完成一个真正可运行的数据分析 Agent。
开场引入
我们先看一个最普通的 Text-to-SQL 系统。
用户问,“为什么昨天收入下降?”
系统可能生成:
SELECT
    date,
    SUM(income) AS income
FROM ad_daily
WHERE date IN ('2026-09-05', '2026-09-06')
GROUP BY date;
得到:
2026-09-05  income = 1,000,000
2026-09-06  income =   760,000
然后系统回答:
昨天收入下降了 24%。这个答案没有错。
但用户问的是,为什么?
这条 SQL 只确认了:
发生了下降。它没有解释:
原因。于是一个真正的数据分析人员会继续查。
先做指标分解:
收入
≈
请求量
×
填充效率
×
曝光效率
×
点击或变现效率
×
价格
在广告场景里,我们可能至少看:
request
impression
click
income
ecpm
然后发现:
request -1.2%
impression -2.0%
click -3.1%
income -24.0%
ecpm -29.4%这时候方向就很清楚,不是流量大幅下降,而是 eCPM 明显下降。
下一步应该下钻:
哪个媒体的 eCPM 异常?查询媒体以后:
Media A:
eCPM -41%
贡献收入下降的 73%

Media B:
eCPM -3%

Media C:
eCPM +2%
这时再继续查:
Media A 的哪个广告位异常?然后发现:
position_102
eCPM -55%
贡献 Media A 异常的 82%
最后再看:
request / impression / click确认:
请求正常
曝光正常
点击略降
价格明显下降
这时候我们可以给出更克制的回答,“现有数据表明收入下降与 eCPM 下滑同步,主要下降贡献集中在 Media A 的 position_102;是否由价格、竞价或策略变更引起,还要继续核对外部记录。”
注意整个过程。
没有任何人一开始就知道最终要查:
position_102。它是经过:
总指标
→ 指标分解
→ 媒体
→ 广告位
一步步从 Observation 推出来的。
这就是 Data Agent 与普通 Text-to-SQL 最大的区别。
知识地图
先把本章主线串起来:用户提出业务问题之后,Agent 不会在第一条查询返回时就直接给答案,而是根据 Observation 更新状态、确定下一步需要验证的问题。
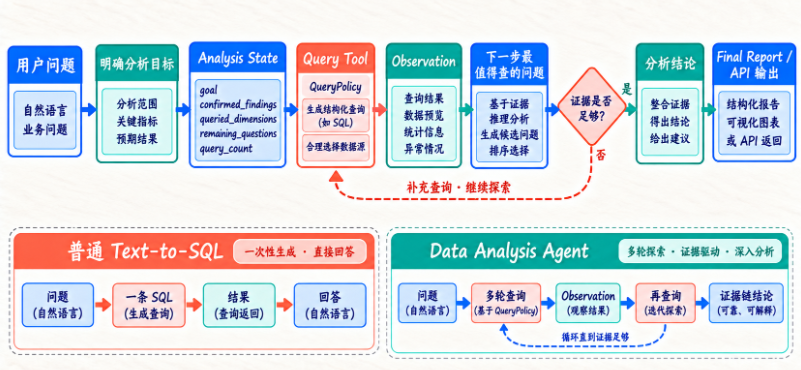
这里要看清楚两条路径:普通查询回答一次问题,持续分析则要在证据不足时继续下钻,并在满足完成条件后停止。
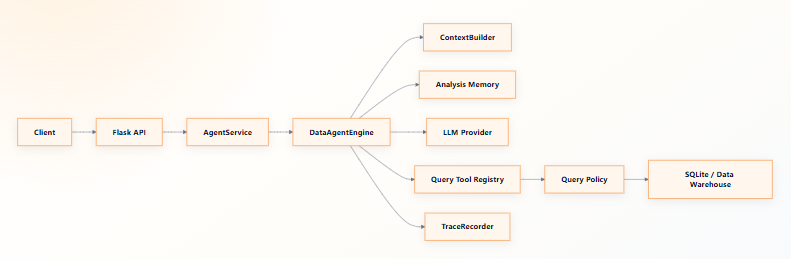
Data Agent 在整个 Harness 中的位置:
















请登录后查看评论内容