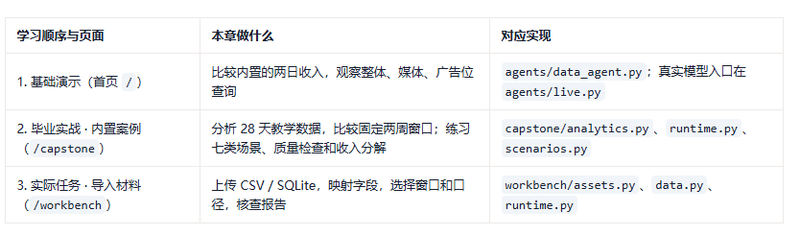


本章定位:从基础演示到收入分析毕业实战
本章讲 Data Analysis Agent。先用两日收入数据理解多轮查询,再用固定的多维案例检查分析证据,最后导入自己的 CSV 或 SQLite。三个页面复用同一服务与通用 Harness,但数据来源、决策策略和完成门禁不同。
表中的源码均位于 src/agent_harness/ 下;projects/12_final_agents/ 保存运行入口。第一次学习按表格顺序操作,本章前半段详解毕业实战,后半段保留两日数据与简化循环,便于对照机制。真实模型是各页面可选的决策方式,不是另一个项目。
启动后怎样完成第一次练习
所有命令都在 agent_harness_course_projects/ 目录执行,使用 Python 3.9。首次环境安装见 项目 README。准备好后运行:
bash start.sh --check
bash start.sh
访问 http://127.0.0.1:5000/,先运行基础 Data 演示;这里的“昨天”对应教学数据中的固定日期,不会查询你当天的业务数据。再进入 /capstone,依次尝试 price、offset、missing,分别观察 eCPM 变化、增长抵消下降,以及证据不足时停止归因。
导入自己的数据:规则分析与真实模型的区别
/workbench 支持 CSV / SQLite 物理表,最大 8 MiB、50000 行。需要映射日期、请求、曝光、点击、收入及 1–4 个维度,选择两个等长、不重叠的 1–90 天窗口。可先导入 收入分析 CSV 示例,比较 2026-09-15 至 09-21 与 09-22 至 09-28;默认字段映射即可使用。
规则分析无需 Key,按“质量检查 → 趋势 → 整体 → 全部边际维度 → 有限分组下钻”的固定流程筛查。它不解读任意自然语言任务来改变分析流程;字段映射、日期窗口和数据合同决定分析范围。改变任务目标文字,不会让规则模式自动支持新的指标或分析方法。它和毕业实战的已知案例脚本也不同:规则分析读取导入数据的数值,不知道预设答案。
真实模型模式由模型选择受控工具,但仍受相同数据与证据门禁限制。需在基础演示首页的“模型设置”中配置 Key;任务与查询观察会发送到模型服务,并可能产生费用。请求量、填充率、eCPM 的收入变化贡献属于算术解释,不能据此确认业务因果。
收入单位只作标签,时区声明不重新聚合数据;缺失日期、空指标、预期分组等口径,以及导入预览、检查点恢复和报告导出步骤,见 实际任务工作台手册。该手册中的 Python 项目与真实 Coding 验收属于第 36 节,可在完成本节数据练习后按需阅读。
本章可在不调用真实模型的情况下检查课程与独立数据评测:
python3 scripts/verify_course.py
python3 scripts/evaluate_workbench.py --repeats 2
增强版实战:有证据门禁的收入分析工作台
本次升级保留后面的两日 SQLite 入门案例,在它之上增加 28 天、多维度、七种情境的毕业项目。完成基础演示后,再用毕业实战观察数据完整性、趋势、整体变化和分组变化,并对照后面的最小分析循环。
分析的终点是可检查的结论,也可以是“当前证据不足”。 不能要求 Agent 每次都找到一个异常,更不能把收入与 eCPM 同时变化写成已经证明的业务因果。
1. 从七类情境认识分析任务
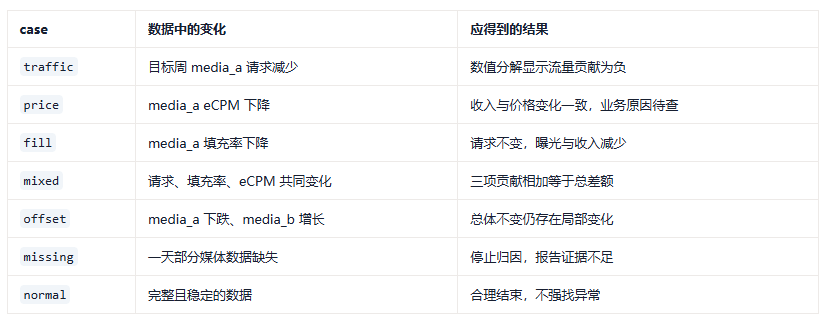
这些数据都是可复现的教学数据,并非实际广告系统导出的数据。场景生成器明确注入变化,便于自动核对预期结果。

2. 运行与源码导航
在 agent_harness_course_projects 中使用已安装依赖的 Python 3.9:
这些数据都是可复现的教学数据,并非实际广告系统导出的数据。场景生成器明确注入变化,便于自动核对预期结果。
2. 运行与源码导航
在 agent_harness_course_projects 中使用已安装依赖的 Python 3.9:运行目录位于 .runtime/capstone/,保存本次独立的 metrics.db 与 report.json。每次重新生成数据,不会覆盖前一次报告。
bash start.sh访问 http://127.0.0.1:5000/capstone,选择 Data Analysis,再选择场景。页面显示查询过程、收入趋势、数值分解、各维度变化、完整证据和导出入口。
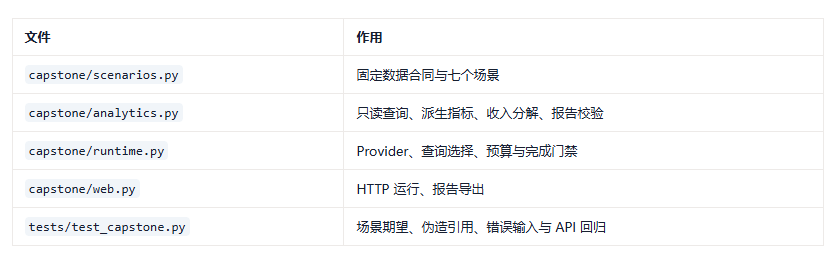
以上 capstone/ 位于 src/agent_harness/ 下。
3. 先固定口径,才能谈变化
数据包含 2026-09-01 至 09-28 共 28 天。每一天有 2 个媒体、2 个广告位、2 个渠道、2 个版本的组合,完整数据共 448 行。
比较窗口固定为:
- 基线周:2026-09-15 至 09-21。
- 目标周:2026-09-22 至 09-28。
- 前两周用于展示趋势,不混入对比指标。
这些都是已定义的自然日分区,没有把运行当天解释成“昨天”,也没有从系统时间推断业务时区。实际接入时需要先约定分区时区、数据到齐时间与节假日处理。本版 UI 不开放任意日期选择,避免让固定场景与任意时间范围混用。
4. 派生指标必须先聚合再相除
底层存储四个可加指标:请求、曝光、点击、收入。填充率、CTR 与 eCPM 由聚合结果计算:
填充率 = SUM(impression) / SUM(request)
CTR    = SUM(click) / SUM(impression)
eCPM   = SUM(income) / SUM(impression) × 1000
为什么不能平均每行的 eCPM?一行只有 10 次曝光,另一行有 10 万次曝光,二者不应获得同等权重。先求总收入与总曝光再相除,才能保持整体与分组口径一致。
分母为零时返回 None,不能强行把未知值写成 0。零基线收入的变化率同样保持未知;绝对差额仍可计算。维度成员仅在一侧存在时,报告标注 new 或 removed,不悄悄忽略该成员。
5. 数据质量检查应发生在归因之前
inspect_data 检查预期组合数量、重复键和基础指标关系。对这个固定教学合同,完整组合数是已知的,因此可以识别缺失。
日期 × media × position × channel × version
                      ↓
             唯一键、完整性与指标关系
                      ↓
          允许分析 / 证据不足并停止归因
missing 刻意删除目标周某一天 media_a 的记录。直接聚合会看到收入下降,但这可能只是采集缺失。正确流程是在质量检查后生成 insufficient_evidence 报告,不再进行收入归因。
这里 status=completed 表示分析流程完成,report.outcome=insufficient_evidence 表示业务结论不足。不能只看运行成功状态就说“已定位根因”。生产数据的缺失检测还需要分区元数据、到齐状态或外部对账,不能照搬教学数据的固定行数。
6. 从整体变化走向可核对的数值分解
收入可以写成:
income = request × fill_rate × ecpm / 1000设基线为 R0, F0, P0,目标为 R1, F1, P1,其中 P 使用每次曝光收入。程序采用明确顺序的替代法:
流量贡献 = (R1 - R0) × F0 × P0
填充贡献 = R1 × (F1 - F0) × P0
价格贡献 = R1 × F1 × (P1 - P0)
三项之和恰好等于目标收入减基线收入,报告保存残差并要求接近零。
顺序会影响交互项归属。 本版固定“请求→填充率→eCPM”,交互影响归入后替换的因素。这是可复核的计算约定,不是唯一归因答案,更不是因果推断。若后续引入对称分解或 Shapley 方法,应同时更新算法、说明和基准测试。
mixed 是最重要的练习:多个因素同时改变,不能只比较各自百分比,就断言谁“造成最多”。应先在收入单位上计算贡献,再检查贡献和能否对账。
7. 总体正常也需要看分组
offset 的整体收入差额为零,但 media_a 的下降恰好被 media_b 的增长抵消。如果 Agent 只看整体就停止,会遗漏重要变化。
因此离线策略即使看到整体变化为零,也查询媒体维度。报告分别保存下降合计、增长合计与净差额;净差额为零时不计算“占净下降百分比”,因为分母为零,这种比例没有解释意义。
当媒体存在下降时,脚本选择收入差额最小的媒体,带着 media 筛选查询广告位;随后选择下降最大的广告位,在既有筛选上增加 position,再查询渠道,最后查询版本。每个查询都带 parent_query_id,形成可追溯的父子证据链。同一收入损失可能出现在多个层级,不能把父节点与子节点贡献相加。
筛选键和取值均在白名单内;子查询只能在父查询的筛选基础上新增一个维度成员。报告逐项核对请求、曝光、点击与收入的基线及目标值,确保子项汇总等于父级选中成员。发布报告时必须同时引用父证据,不能只引用孤立的叶子结果。
整体正常且媒体没有变化时,脚本会继续检查其他三个维度的边际汇总。下钻只覆盖当前最大下降路径;并列分组按稳定顺序选择,报告明确说明未排除其他路径。正常结果只表示已查范围内未发现异常,不代表穷尽所有维度交叉组合。
本版离线策略是明确的教学分支,尚未实现信息增益排序。真实 Provider 可以选择工具暴露的维度,但仍必须满足证据门禁。增加一个下钻算法,应通过“减少无效查询且保持证据充分”的评测验证价值。
8. 受控查询工具不接受任意 SQL
模型只看到以下工具:
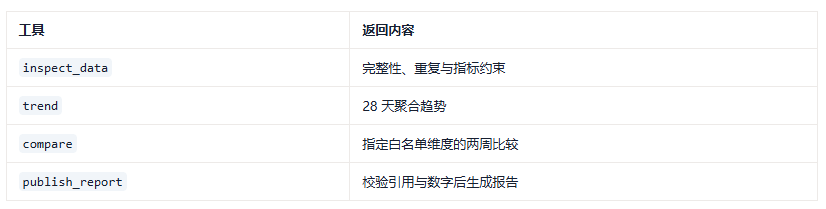
compare 只接受 overall、media、position、channel、version,以及可选 filters、parent_query_id。维度和筛选键经白名单验证后才拼接,日期与筛选值均通过绑定参数传入,SQLite 使用只读连接。工具不会接受用户提供的 SQL 文本。
每次新查询都会使已有报告失效,需要重新发布。质量门禁必须引用最近一次质量检查,不能在出现缺失后继续引用旧的合格证据。
每个观察保存稳定 query_id。相同结果生成相同标识,不能靠重复查询伪造新的证据。这个标识用于单次运行内的引用校验,不替代跨数据库的数据版本管理。
9. 完成门禁从“查过两次”升级为“证据足够”
后面的最小真实模型案例要求两次不同的非空查询,只能拦截明显的一查就答。增强版通过 publish_report 进一步要求:
- 所有引用真实存在于本次运行。
- 已检查数据质量。
- 数据合格时,具备趋势、整体与至少一个分组比较。
- 无筛选分组与整体对账;有筛选分组与其父级成员对账,分别检查两期四个可加指标。
- 收入分解存在,且残差通过校验。
- 数据不合格时,报告明确停止归因。
正式报告的数字由程序从已选证据计算,不采信模型随意填写的金额。模型负责选择下一步查询;程序负责保证引用有效和数值一致。模型的最终聊天文字不是报告事实来源。
10. 事实、假设和未知项分别放在哪里
报告包含:
comparison:整体基线、目标、差额和变化率。breakdowns:各维度的分组变化。decomposition:方法、贡献、残差。hypotheses:带引用的数值因素说明,标记为 numerical_evidence。unknowns:尚不能确认的业务原因。citations:本次分析使用的查询编号。
当前 hypotheses 保存的是受证据支持的数值解释,尚未实现任意假设的反证搜索。不能把它宣传成完整的因果发现系统。策略变更、竞价环境与发布事件不在教学数据中,因此报告明确要求继续核查。
11. 真实模型与离线对照
export DEEPSEEK_API_KEY='替换为自己的 Key'
python3 projects/12_final_agents/capstone_demo.py data mixed --live
比较两种模式的工具顺序、查询数量、失败观察与最终报告。它们可以有不同的查询路线,但都必须满足相同门禁。
调用真实 API 可能发生限流、工具参数错误或预算耗尽。增强版允许把工具错误返回给模型继续纠正,同时限制总步骤、工具次数、时间和 Token。没有报告时返回 unverified,不能把模型最后一段流畅文字当成验证完成。
12. 工作台与报告交付
趋势图展示收入变化形状,精确值保存在查询证据。JSON 下载包含工具参数、观察与报告;Markdown 下载适合人工复核。历史运行可以重新打开查看,不会因为切换场景丢失旧结果。
工作台采用轮询读取运行与 Trace;共用服务另有 SSE 接口,但本版页面没有把轮询描述为 SSE 实时订阅。取消在调用边界检查,已经开始的外部模型请求不保证立即终止。
13. 毕业作业
证据作业: 跑完七类场景,分别提交结论与一条最关键的证据。对 missing 说明为何停止;对 normal 说明为何不继续寻找异常;对 offset 说明为什么净额会误导。
计算作业: 手工复算 mixed 的三项贡献,比较交换替代顺序后的结果,解释为何总差额不变而单项贡献改变。
工程作业: 增加一种异常场景,先写预期输出与边界测试,再修改生成器。不能只写“应该成功”的断言,应检查数值、引用、对账或停止条件。
扩展作业: 接入任意日期范围前,先实现相等窗口校验、时区与数据到齐规则;扩展组合过滤时,应继续保持父子证据链、过滤白名单与同口径对账。把这些当作显式功能开发,不把当前固定场景的能力无限外推。
python3 scripts/verify_course.py















请登录后查看评论内容