

在连续分析中,真正需要承接的不是逐句聊天记录,而是已经回答了什么、哪些结论有证据支持、查过哪些维度,以及还剩哪些问题。下面这张图把这些字段与中心状态放在了一起。
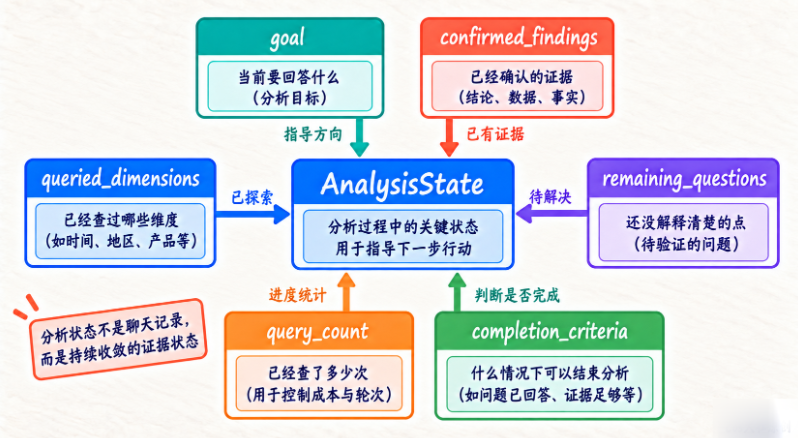
confirmed_findings 记录已确认的发现,remaining_questions 用来确定仍需验证的内容;query_count 和 completion_criteria 则分别帮助管理分析资源与结束条件。
Coding Agent 有:
modified_files
current_error
test_status
Data Agent 也需要自己的 State。
至少包括:
goal
baseline
current_hypothesis
confirmed_findings
queried_dimensions
important_metrics
remaining_questions
status
为什么不能只靠 Conversation History?
因为聊天历史只是:
发生过什么。它不一定能清晰回答:
目前已经确认了什么?
哪些假设被否定?
接下来还需要查什么?
所以需要:
AnalysisMemory。一个基础 AnalysisState
confirmed_findings 为什么重要?
比如已经确认:
request 基本稳定
eCPM 明显下降
这两条应该进入:
confirmed_findings。后面 Context Compaction 即使发生,也不能丢。
queried_dimensions 为什么重要?
防止:
媒体查过一次
后面忘记
又查一遍媒体
这对防止:
重复查询很重要。
remaining_questions
例如:
哪个媒体贡献最大?
Media A 内哪个广告位异常?
请求和曝光是否同步变化?
当这些问题都关闭。
并且核心结论有证据。
就可以结束。
数据分析也要有 Completion Criteria
不能让模型说:
“我觉得分析得差不多了。”更合理:
异常已确认
+
主要异常指标已定位
+
至少一个主要贡献维度已定位
+
最终结论有 Query Result 支撑
+
没有关键未回答问题
→ COMPLETED
这正好解决前面讲的:
提前结束
过度调用 Tool
两个问题。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容