

接下来把模型提出查询意图、后端检查策略与真正执行分开看。模型应提出结构化请求,而不是因为能写出 SQL 就自动获得数据库执行权。
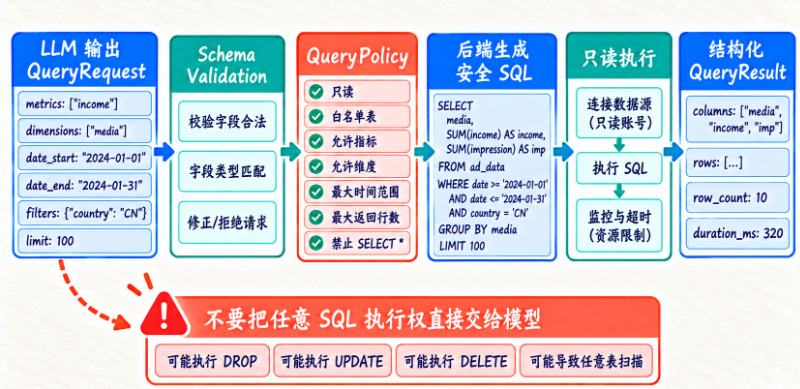
图里的 Schema Validation、Query Policy 和只读执行是不同环节:字段有效不代表查询范围合理,执行只读也不等于可以访问任意表。
Data Agent 最危险的设计之一:
LLM 生成 SQL
↓
数据库直接执行
尤其生产环境。
更稳的思路是,给 Agent 一个受控 Query Tool,而不是数据库超级权限。
第一版 Query Tool 可以接收结构化参数
例如:
{
  "date_start": "2026-09-05",
  "date_end": "2026-09-06",
  "metrics": ["income", "request", "impression", "click"],
  "dimensions": ["date"],
  "filters": {}
}
然后 Tool 自己:
校验指标
校验维度
校验时间范围
生成安全 SQL
执行
返回结构化结果
为什么比自由 SQL 更安全?
因为模型不能直接:
DROP TABLE
UPDATE
DELETE
也不能:
随意查任何表。QueryPolicy
这里把 QueryPolicy 单独展开,是为了说明“只读”远远不是完整的安全策略。除了禁止修改数据,还要限制允许访问的表、指标、维度、日期跨度和结果规模。
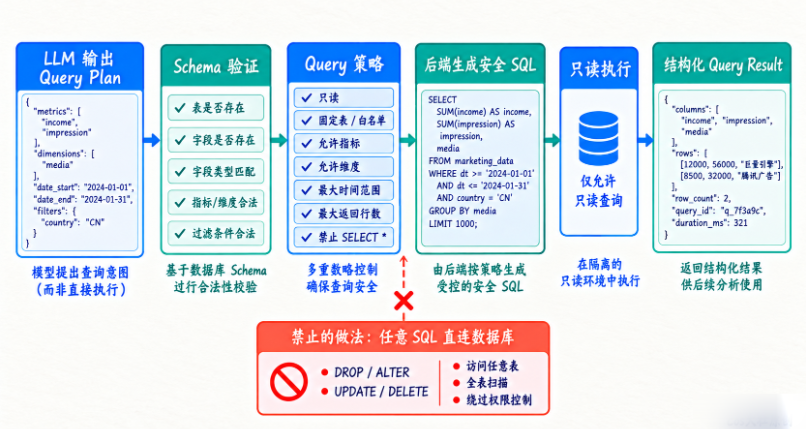
图中由后端根据合规 Query Plan 生成 SQL 并返回结构化结果;具体规则仍以本节的代码和字段合同为准,不应直接把配图里的演示表名当成实际生产配置。
第一版至少限制:
只读
固定表
允许指标
允许维度
最大时间范围
最大 limit
禁止 SELECT *
一个最小 QueryRequest
from dataclasses import dataclass, field


@dataclass
class QueryRequest:
    metrics: list[str]
    dimensions: list[str]
    date_start: str
    date_end: str
    filters: dict[str, str] = field(
        default_factory=dict
    )
一个教学版 QueryPolicy
class QueryPolicy:

    ALLOWED_METRICS = {
        "income",
        "request",
        "impression",
        "click",
        "ecpm",
    }

    ALLOWED_DIMENSIONS = {
        "date",
        "media",
        "position",
    }

    MAX_DATE_DAYS = 31
    MAX_ROWS = 500

    def validate(
        self,
        request,
    ) -> None:
        unknown_metrics = (
            set(request.metrics)
            - self.ALLOWED_METRICS
        )

        if unknown_metrics:
            raise ValueError(
                (
                    "unsupported metrics: "
                    + str(
                        unknown_metrics
                    )
                )
            )

        unknown_dimensions = (
            set(request.dimensions)
            - self.ALLOWED_DIMENSIONS
        )

        if unknown_dimensions:
            raise ValueError(
                (
                    "unsupported dimensions: "
                    + str(
                        unknown_dimensions
                    )
                )
            )

        if not request.metrics:
            raise ValueError(
                "at least one metric is required"
            )

        if len(request.dimensions) > 2:
            raise ValueError(
                "too many dimensions"
            )

        # 实际项目还会使用 date.fromisoformat 校验格式、
        # 起止顺序和最大 31 天范围,并拒绝重复字段。
真实系统还要:
时间范围限制
用户权限
表白名单
SQL Parser
超时
返回行数
Query Result 应该返回什么?
不建议只返回:
大段字符串。而应该结构化:
{
  "columns": ["date", "income", "request", "ecpm"],
  "rows": [...],
  "row_count": 2,
  "query_id": "query_xxx",
  "duration_ms": 120
}
这样模型更容易分析。
Trace 也更容易记录。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容