排序
第 5 章 学习的技巧
5.1 深度神经网络及其问题 5.1.1 深度学习 当神经网络的层数加深时,往往可以有效地提高识别精度;特别是对于大规模的复杂问题,通常都需要用更多的层来分层次传递信息,而且可以有效减少网络的...
 3小时前

4.7 反向传播的综合代码实现
现在可以在之前手写数字识别案例的基础上,对SGD的计算过程进行优化。核心就是使用误差的反向传播法来计算梯度,而不是使用差分数值计算;这将大大提升学习的效率。 对于二层网络TwoLayerNet,...
3小时前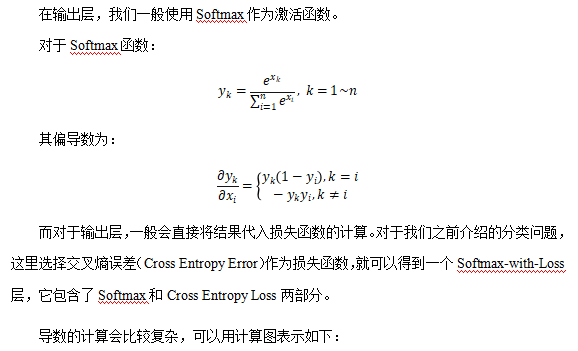
4.6 输出层的反向传播和实现
简化得: 在代码中可以实现为一个类SoftmaxWithLoss: class SoftmaxWithLoss: def __init__(self): self.loss = None self.y = None # softmax的输出 self.t = None # 监督数据 def forward(se...
3小时前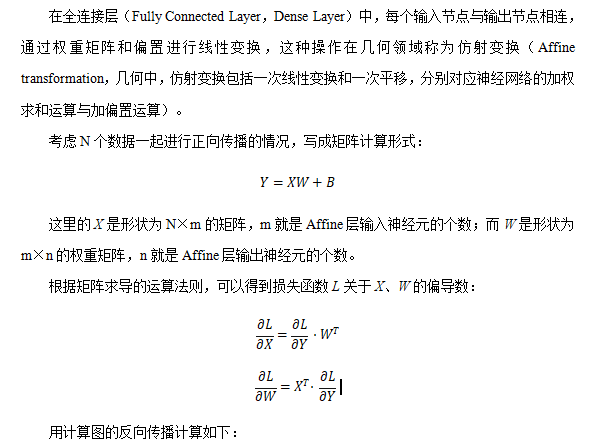
4.5 Affine的反向传播和实现
class Affine: def __init__(self, W, b): self.W =W self.b = b self.x = None self.original_x_shape = None # 权重和偏置参数的导数 self.dW = None self.db = None def forward(self, x): #...
3小时前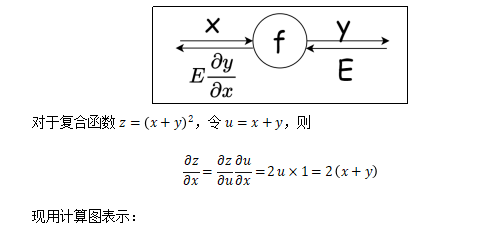
4.2 链式法则
反向传播将局部导数向反方向传递,传递的原理基于链式法则。反向传播时将信号乘以节点的局部导数然后传递给下一个节点。 4.3 反向传播 利用计算图的反向传播,可以很容易地计算出输出关于输入的...
3小时前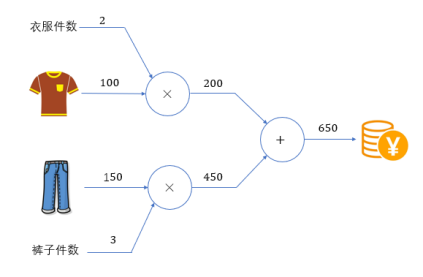
第 4 章 反向传播算法
反向传播(Backward Propagation或Back Propagation,BP算法)指的是计算神经网络参数梯度的方法。简言之,该方法根据微积分中的链式法则,按相反的顺序从输出层到输入层遍历网络。该算法存储了...
3小时前3.4.3 SGD
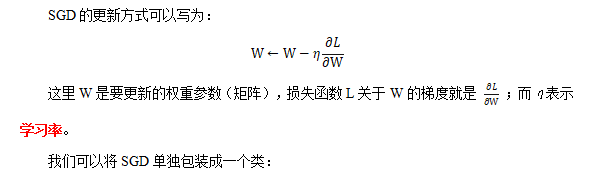
在神经网络的学习过程中,可以使用梯度下降法来更新参数,目标就是减小损失函数的值。 实际操作时,一般会从训练数据中随机选择一个小批量数据(mini-batch),然后用梯度下降法迭代多个轮次(i...
3小时前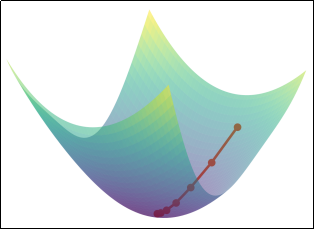
3.4 随机梯度下降法(SGD)
3.4.1 梯度下降法 梯度下降法(Gradient Descent)是一种用于最小化目标函数的迭代优化算法。核心是沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。梯度方向指示...
4小时前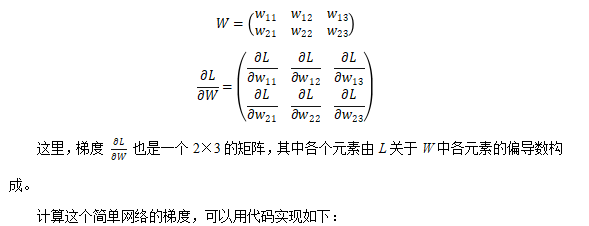
3.3 神经网络的梯度计算
在神经网络的学习中,梯度的计算非常重要。神经网络中的梯度,指的就是损失函数关于权重参数的梯度。 我们以一个单层的简单网络为例,形状为2×3,权重参数为W,损失函数记为L。那么它的权重参...
4小时前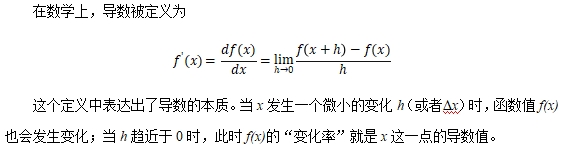
3.2 数值微分
损失函数的值越小,代表我们选取的参数越适合;想要求得损失函数的最小值,最基本的想法就是对函数求导,解出导数值为0的点,并判断它是否为极小值/最小值。 然而,实际的函数直接求导,不容易...
4小时前
