排序
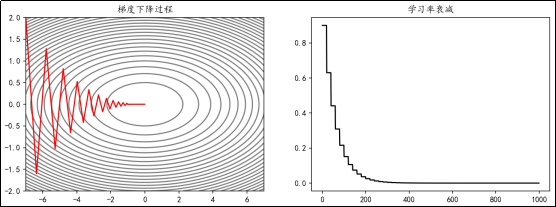
5.2.3 学习率衰减
深度学习模型训练中调整最频繁的当属学习率,好的学习率可以使模型逐渐收敛并获得更好的精度。较大的学习率可以加快收敛速度,但可能在最优解附近震荡或不收敛;较小的学习率可以提高收敛的精度...
 2小时前
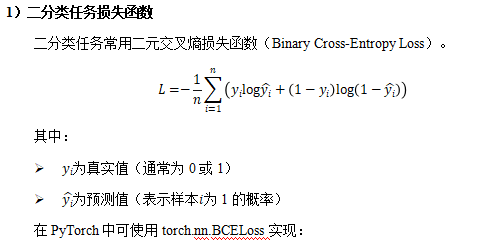
7.4 损失函数
7.4.1 分类任务损失函数 import torch import torch.nn as nn # 真实值 target = torch.tensor([[1], [0], [0]], dtype=torch.float32) # 预测值 input = torch.randn((3, 1)) ...
1小时前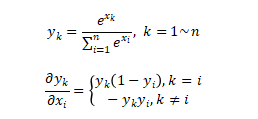
2.2.6 Softmax函数
Softmax将一个任意的实数向量转换为一个概率分布,确保输出值的总和为1,是二分类激活函数Sigmoid在多分类上的推广。Softmax常用于多分类问题的输出层,用来表示类别的预测概率。 Softmax会放大...
3小时前
4.7 反向传播的综合代码实现
现在可以在之前手写数字识别案例的基础上,对SGD的计算过程进行优化。核心就是使用误差的反向传播法来计算梯度,而不是使用差分数值计算;这将大大提升学习的效率。 对于二层网络TwoLayerNet,...
2小时前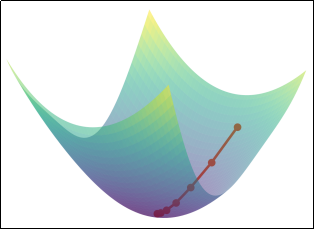
3.4 随机梯度下降法(SGD)
3.4.1 梯度下降法 梯度下降法(Gradient Descent)是一种用于最小化目标函数的迭代优化算法。核心是沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。梯度方向指示...
3小时前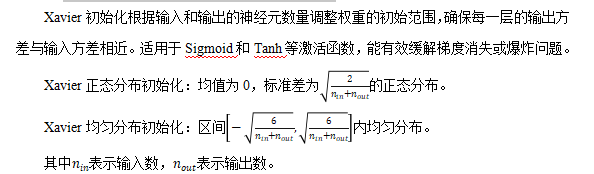
7.2 参数初始化和正则化
7.2.1 全连接层(nn.Linear) 在神经网络中,参数主要位于全连接层(仿射层Affine)中。 PyTorch提供了torch.nn模块,专门用于神经网络的构建和训练。其中全连接层被实现为Linear类,内部有两个...
1小时前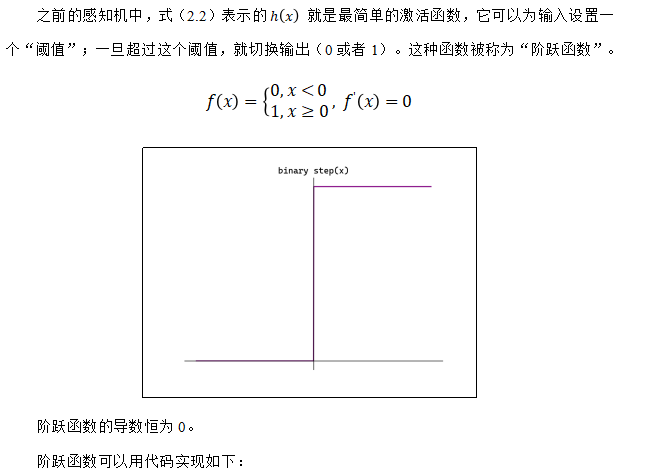
2.2 激活函数
2.2.1 激活函数的作用 激活函数是连接感知机和神经网络的桥梁,在神经网络中起着至关重要的作用。 如果没有激活函数,整个神经网络就等效于单层线性变换,不论如何加深层数,总是存在与之等效的...
3小时前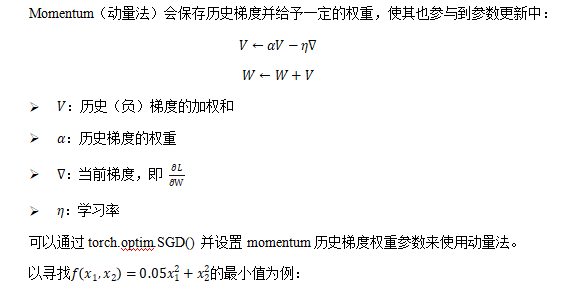
7.5 参数更新方法
7.5.1 Momentum import torch import numpy as np import matplotlib.pyplot as plt def gradient_descent(X, optimizer, n_iters): X_arr = X.detach().numpy().copy() # 拷贝,用于记...
1小时前6.6 张量运算函数
常见运算函数: sum()求和 mean()求均值 max()/min()求最大/最小值及其索引 argmax()/argmin()求最大值/最小值的索引 std()求标准差 unique()去重 sort()排序 import torch tensor1 = torch.ran...
2小时前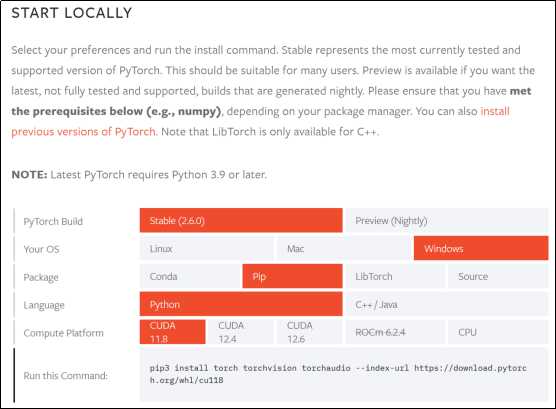
第 6 章 PyTorch简介
6.1 什么是PyTorch PyTorch是一个开源的Python机器学习库,基于Torch库(一个有大量机器学习算法支持的科学计算框架,有着与Numpy类似的张量(Tensor)操作,采用的编程语言是Lua),底层由C++...
2小时前
