

3.4.1 梯度下降法
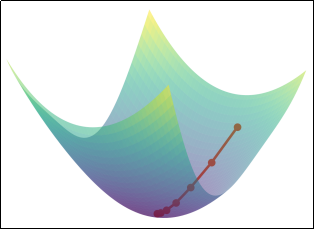
梯度下降法(Gradient Descent)是一种用于最小化目标函数的迭代优化算法。核心是沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。梯度方向指示了函数增长最快的方向,因此负梯度方向是函数下降最快的方向。
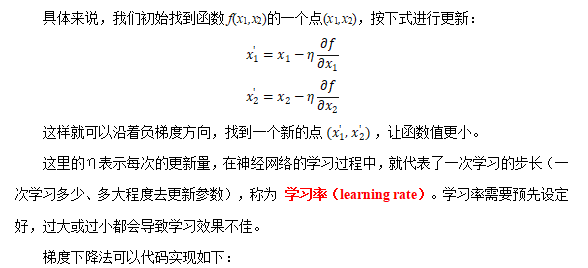
def gradient_descent(f, init_x, lr=0.01, step_num=100):
    x = init_x
    x_history = []

    for i in range(step_num):
        x_history.append( x.copy() )

        grad = numerical_gradient(f, x)
        x -= lr * grad

    return x, np.array(x_history)
3.4.2 模型训练相关概念
- Epoch
1个Epoch表示模型完整遍历一次整个训练数据集的过程。例如,训练10个Epoch表示模型将整个数据集反复学习10次。
模型需要多次遍历数据集(多个Epoch)才能逐步学习数据中的模式,单次遍历数据集(1个Epoch)通常不足以让模型收敛,多次遍历可以逐步优化模型参数。
- Batch Size
Batch Size是每次训练时输入的样本数量。例如,Batch Size=32 表示每次用32个样本计算一次梯度并更新模型参数。
小批量数据计算梯度比单样本(Batch Size=1)更稳定,比全批量(Batch Size=全体数据)更高效。并且较小的Batch Size可能带来更多噪声,有助于模型泛化。
- Iteration
一次Iteration表示完成一个Batch数据的正向传播(预测)和反向传播(更新参数)的过程。
例如,数据集现有2000个样本,对其训练10个Epoch,选择Batch Size=64:
Batch个数为2000//64+1=31+1=32个(最后一个Batch仅有16个样本)。
每个Epoch中迭代次数Itreation=32次。
总迭代次数为10×32=320次。
总训练样本数为10×2000=20000。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容