

3.3.1 创建与访问
什么是 DataFrame?
DataFrame 是 Pandas 中的核心数据结构之一,多行多列表格数据,类似于 Excel 表格 或 SQL 查询结果。
它是一个 二维表格结构,具有行索引(index)和列标签(columns)。
df = pd.DataFrame({
    "name": ["Alice", "Bob"],
    "score": [90, 80]
})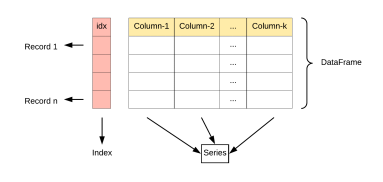
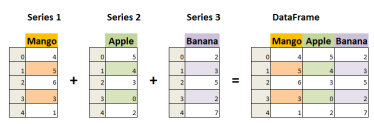
DataFrame中的数据是以一个或多个二维块存放的(而不是列表、字典或别的一维数据结构)。它可以被看做由Series组成的字典(共同用一个索引)。提供了各种功能来进行数据访问、筛选、分割、合并、重塑、聚合以及转换等操作,广泛用于数据分析、清洗、转换、可视化等任务。
DataFrame的创建
# 通过series来创建
import pandas as pd
import numpy as np
np.random.seed(42)
s1 = pd.Series(np.random.randint(0,10,6))
np.random.seed(41)
s2 = pd.Series(np.random.randint(0,20,6))
df = pd.DataFrame({"s1":s1,"s2":s2})
直接通过字典创建DataFrame
import pandas as pd
df = pd.DataFrame({    "name": ["Alice", "Bob"],    "score": [90, 80]})
print(df)
df = pd.DataFrame({"id": [101, 102, 103],
"name": ["张三", "李四", "王五"], "age": [20, 30, 40]})
print(df)
#     id name  age
# 0  101   张三   20
# 1  102   李四   30
# 2  103   王五   40
通过字典创建时指定列的顺序和行索引
df = pd.DataFrame(
    data={"age": [20, 30, 40],
    "name": ["张三", "李四", "王五"]},
    columns=["name", "age"], index=[101, 102, 103]
)
print(df)
#     name  age
# 101   张三   20
# 102   李四   30
# 103   王五   40
获取DataFrame数据
| 方法分类 | 语法示例 | 描述 | 返回值类型 | 是否支持切片/条件索引 |
| 列选择 | df[‘col’] | 选择单列(返回Series) | Series | ❌ |
| df[[‘col1’, ‘col2’]] | 选择多列(返回DataFrame) | DataFrame | ||
| 行选择 | df.loc[row_label] | 通过行标签选择单行(返回Series) | Series | ✅(标签切片) |
| df.loc[start:end] | 通过标签切片选择多行(闭区间) | DataFrame | ||
| df.iloc[row_index] | 通过行位置选择单行(从0开始) | Series | ✅(位置切片) | |
| df.iloc[start:end] | 通过位置切片选择多行(左闭右开) | DataFrame | ||
| 行列组合选择 | df.loc[row_labels, col_labels] | 通过标签选择行和列(如df.loc[‘a’:’b’, [‘col1′,’col2’]]) | Series/DataFrame | ✅ |
| df.iloc[row_idx, col_idx] | 通过位置选择行和列(如df.iloc[0:2, [1,3]]) | Series/DataFrame | ||
| 条件筛选 | df[df[‘col’] > 3] | 通过布尔条件筛选行 | DataFrame | ✅ |
| df.query(“col1 > 3 & col2 < 10”) | 使用表达式筛选(需字符串表达式) | DataFrame | ||
| 快速访问 | df.at[row_label, ‘col’] | 快速访问单个值(标签索引,高效) | 标量值 | ❌ |
| df.iat[row_idx, col_idx] | 快速访问单个值(位置索引,高效) | 标量值 | ||
| 头部/尾部 | df.head(n) | 返回前n行(默认5) | DataFrame | ❌ |
| df.tail(n) | 返回后n行(默认5) | DataFrame | ||
| 样本抽样 | df.sample(n=3) | 随机抽取n行 | DataFrame | |
| 索引重置 | df.reset_index() | 重置索引(原索引变为列) | DataFrame | |
| 设置索引 | df.set_index(‘col’) | 指定某列作为新索引 | DataFrame |
- loc** vs ****iloc**
- loc:基于**标签**(index/column names),切片为**闭区间**(如df.loc[‘a’:’c’]包含’c’)。
- iloc:基于**整数位置**(从0开始),切片为**左闭右开**(如df.iloc[0:2]不包含索引2)。
- 布尔条件筛选
- 支持组合条件(需用&、|,并用括号分隔条件):
df[(df['col1'] > 3) & (df['col2'] == 'A')]- at**/****iat**** vs ****loc****/****iloc**
- at/iat:仅用于**访问单个值**,速度更快。
- loc/iloc:支持多行/列选择,功能更灵活。
获取一列数据
# 访问数据
print(df['name'])  #访问某列数据
print(df.score)
 # df["col"] / df.col
df["name"]       # 返回 Series
df.name
df[["name"]]     # 返回 DataFrame
获取多列数据
df[["date", "temp_max", "temp_min"]]  # 获取多列数据
print(df[['name','score']]) # 访问多列数据
获取行数据
loc:通过行标签获取数据
df.loc[1]  # 获取行标签为1的数据
df.loc[[1, 10, 100]] # 获取行标签分别为1、10、100的数据iloc:通过行位置获取数据
df.iloc[0]  # 获取行位置为0的数据
df.iloc[-1]  # 获取行位置为最后一位的数据
获取指定单元格
df.loc[101, "name"]    # 标签访问
df.iloc[0, 1]          # 位置访问
df.loc[1, "precipitation"]  # 获取行标签为1,列标签为precipitation的数据
df.loc[:, "precipitation"]  # 获取所有行,列标签为precipitation的数据
df.iloc[:, [3, 5, -1]]  # 获取所有行,列位置为3,5,最后一位的数据
df.iloc[:10, 2:6]  # 获取前10行,列位置为2、3、4、5的数据
df.loc[:10, ["date", "precipitation", "temp_max", "temp_min"]]  # 通过行列标签获取数据
查看部分数据
通过head()、tail()获取前n行或后n行
print(df.head())
print(df.tail(10))
使用布尔索引筛选数据
# 条件筛选
df['score']>70
print(df[df.score>70])
print(df[(df['score']>70) & (df['age']<20)])
# 随机抽样
df.sample(2)
常用属性
| 属性 | 说明 |
| index | DataFrame的行索引 |
| columns | DataFrame的列标签 |
| values | DataFrame的值 |
| ndim | DataFrame的维度 |
| shape | DataFrame的形状 |
| size | DataFrame的元素个数 |
| dtypes | DataFrame的元素类型 |
| T | 行列转置 |
| loc[] | 显式索引,按行列标签索引或切片 |
| iloc[] | 隐式索引,按行列位置索引或切片 |
| at[] | 使用行列标签访问单个元素 |
| iat[] | 使用行列位置访问单个元素 |
import pandas as pd
df = pd.DataFrame(data={"id": [101, 102, 103], "name": ["张三", "李四", "王五"], "age": [20, 30, 40]},index=["aa", "bb", "cc"])
# index DataFrame的行索引
print(df.index)
# columns   DataFrame的列标签
print(df.columns)
# values    DataFrame的值
print(df.values)
# ndim  DataFrame的维度
print(df.ndim)
# shape DataFrame的形状
print(df.shape)
# size  DataFrame的元素个数
print(df.size)
# dtypes    DataFrame的元素类型
print(df.dtypes)
# T 行列转置
print(df.T)
# loc[] 显式索引,按行列标签索引或切片 逗号前是行切片规则,后是列切片规则
print(df.loc["aa":"cc"])
print(df.loc[:,["id","name"]])
# iloc[]    隐式索引,按行列位置索引或切片
print(df.iloc[0:1])
print(df.iloc[0:3,2])
print("----------")
# at[]  使用行列标签访问单个元素
print(df.at["aa","name"])
# iat[] 使用行列位置访问单个元素
print(df.iat[0,1])
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容