

6.1 介绍
峰度用来观察分布的尾部厚度和极端值倾向。很多资料会说“峰度衡量尖不尖”,这个说法容易让人误会;更稳妥的理解是:峰度越高,分布越容易出现远离均值的极端值。
峰度有两种常见口径:
- Pearson 峰度: 正态分布为 3。
- 超额峰度(excess kurtosis): 在 Pearson 峰度基础上减去 3,所以正态分布为 0。
后面代码使用超额峰度,因为它更方便我们和正态分布比较:大于 0 表示尾部比正态更厚,小于 0 表示尾部比正态更薄。
6.2 原理
峰度会把每个数据点先标准化,再取四次方。标准化是为了去掉单位影响,四次方会明显放大离均值很远的点。
Pearson 峰度可以写成:
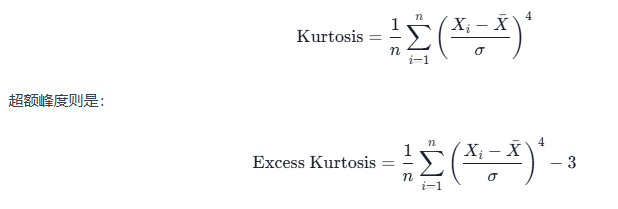
6.3 重点和注意事项
- 重点: 峰度提供了关于数据分布形状的信息,是了解数据尖峭程度的重要指标。
- 注意事项:
- 如果使用 Pearson 峰度,正态分布的基准是 3。
- 如果使用超额峰度,正态分布的基准是 0。看资料或代码参数时,先确认用的是哪一种口径。
6.4 完整案例
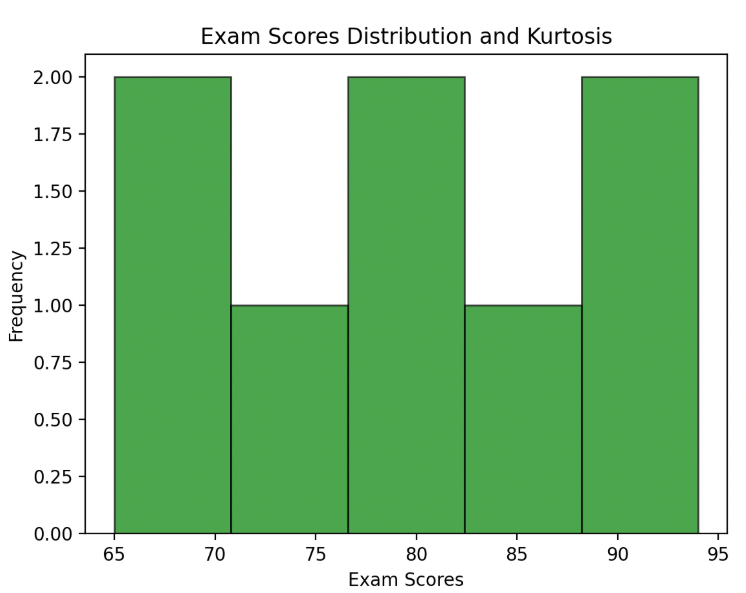
考虑一个案例:某班级学生的考试成绩。我们想计算学生们的考试成绩的峰度,并绘制直方图以展示数据分布情况。
数据:
考试成绩数据:[75, 82, 90, 65, 88, 78, 94, 70]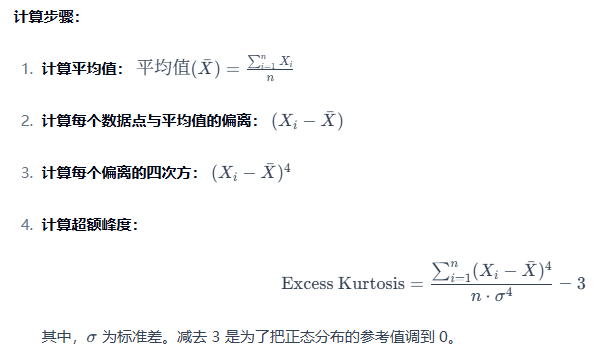
Python代码:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import kurtosis

# 考试成绩数据
exam_scores = np.array([75, 82, 90, 65, 88, 78, 94, 70])

# 计算超额峰度。fisher=True 表示返回 Pearson 峰度减 3 后的结果。
excess_kurtosis = kurtosis(exam_scores, fisher=True, bias=False)

# 绘制直方图
plt.hist(exam_scores, bins=5, alpha=0.7, color='green', edgecolor='black', label='Exam Scores Distribution')

# 添加标题和标签
plt.title('Exam Scores Distribution and Kurtosis')
plt.xlabel('Exam Scores')
plt.ylabel('Frequency')

# 显示图表
plt.show()

print("Excess kurtosis of exam scores:", excess_kurtosis)
以上代码计算的是超额峰度,并绘制了直方图。读峰度时不要只看“尖不尖”,更要想到它对极端值非常敏感。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容