

1. 定义与测度
1.1 介绍
偏态是统计学中用于描述数据分布偏离对称性的指标。一个分布的偏态可以是正偏(右偏)或负偏(左偏),分别表示分布尾部在右侧或左侧拉得更长。偏态的测度可以通过偏态系数等统计量来衡量。
1.2 原理
偏态系数先把每个值减去均值,再除以标准差做标准化,最后取三次方并求平均。三次方会保留正负方向:右侧尾巴更长时,较大的正偏差会把结果推成正数;左侧尾巴更长时,较大的负偏差会把结果推成负数。
常见的样本偏态系数写法之一是:
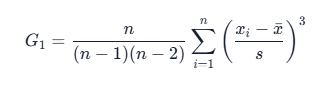
其中 s 是样本标准差。这个校正版更适合用样本估计总体偏态。
1.3 重点和注意事项
- 重点: 偏态提供了关于数据分布偏斜程度的信息,有助于理解数据的特征。
- 注意事项:
- 正偏(右偏)表示数据分布的右尾较长,负偏(左偏)表示左尾较长。
- 偏态系数的绝对值越大,偏斜程度越大。
1.4 完整案例
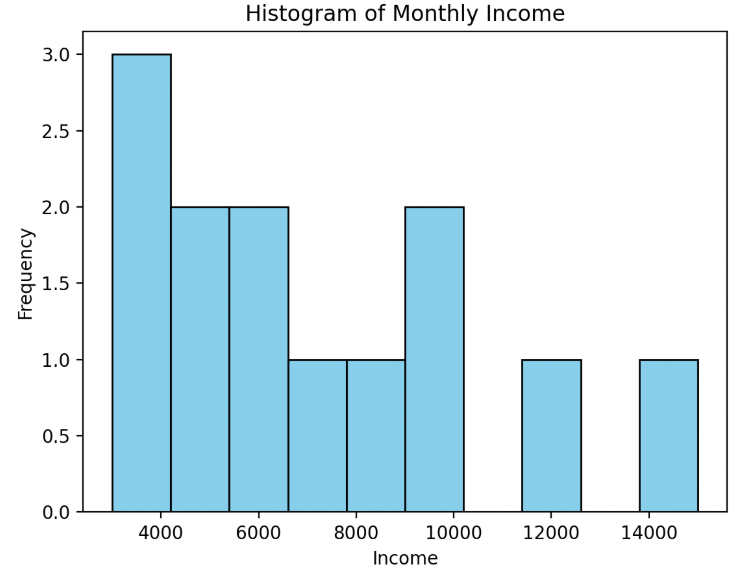
考虑一个案例:某城市居民月收入数据。我们想计算收入数据的偏态,并绘制直方图以展示数据分布情况。
数据:
月收入数据:[3000, 3500, 4000, 4500, 5000, 5500, 6000, 7000, 8000, 9000, 10000, 12000, 15000]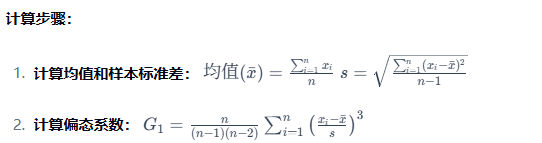
Python代码:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import skew

# 月收入数据
income_data = np.array([3000, 3500, 4000, 4500, 5000, 5500, 6000, 7000, 8000, 9000, 10000, 12000, 15000])

# 计算均值、样本标准差和偏态系数
mean_income = np.mean(income_data)
std_dev_income = np.std(income_data, ddof=1)
skewness = skew(income_data, bias=False)

# 绘制直方图
plt.hist(income_data, bins=10, color='skyblue', edgecolor='black')

# 添加标题和标签
plt.title('Histogram of Monthly Income')
plt.xlabel('Income')
plt.ylabel('Frequency')

# 显示图表
plt.show()

print("Mean of income:", mean_income)
print("Standard deviation of income:", std_dev_income)
print("Skewness of income:", skewness)
# Mean of income: 7115.384615384615
# Standard deviation of income: 3577.4399957339497
# Skewness of income: 0.9850641596108992
以上代码计算了月收入数据的均值、标准差和偏态系数,并绘制了月收入的直方图。
直方图展示了收入数据的分布情况,偏态系数表明数据呈右偏分布。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容