

1. 零假设与备择假设
1.1 介绍
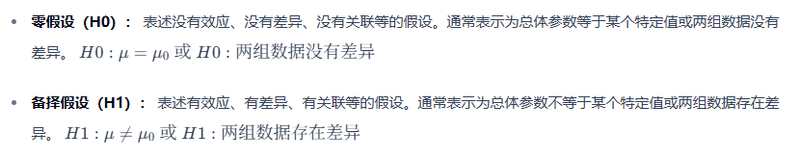
在统计学中,假设检验是一种通过样本数据对总体参数提出假设并进行检验的方法。
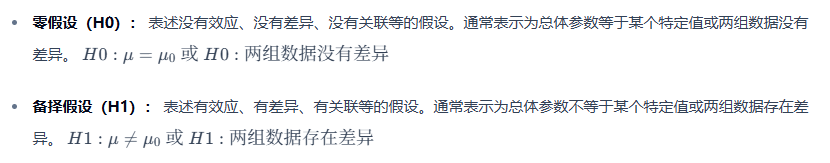
其中,零假设(Null Hypothesis,简称 H0)和备择假设(Alternative Hypothesis,简称 H1 或 Ha)是假设检验的核心概念。
1.2 原理
1.3 重点和注意事项
- 重点: 假设检验用于判断样本数据是否提供足够证据拒绝零假设。
- 注意事项:
- 类型I错误(α错误): 错误地拒绝了真实的零假设。
- 类型II错误(β错误): 错误地未拒绝了虚假的零假设。
- 显著性水平(α):决定在多大程度上拒绝零假设的概率。
1.4 完整案例
考虑一个案例:某电商公司对于两个不同网站设计的购物车结算页面的转化率是否存在显著差异。
假设第一个网站(A网站)的转化率为 ,第二个网站(B网站)的转化率为 。
数据:
A网站购物车结算成功的用户数:80
A网站总的用户数:1000

B网站购物车结算成功的用户数:120
B网站总的用户数:1000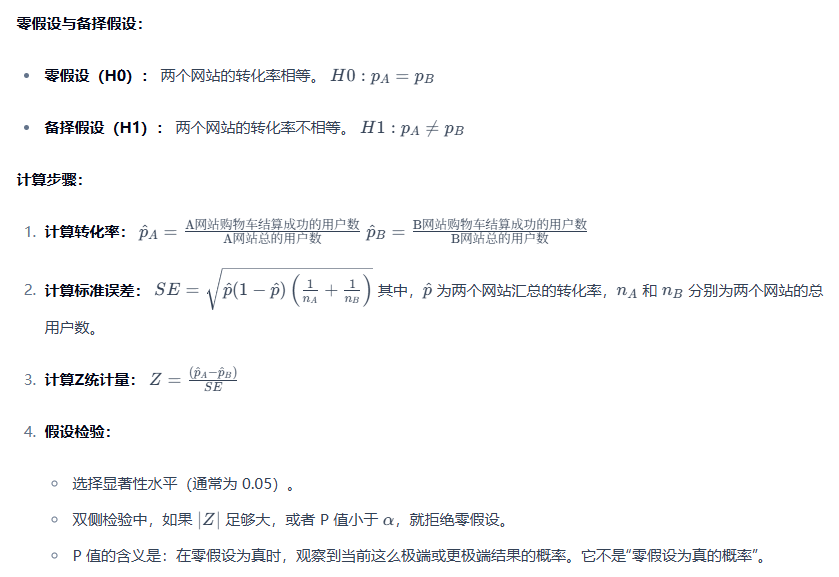
Python代码:
import numpy as np
import scipy.stats as stats

# 数据
success_A, total_A = 80, 1000
success_B, total_B = 120, 1000

# 转化率计算
p_A = success_A / total_A
p_B = success_B / total_B

# 汇总的转化率
p_combined = (success_A + success_B) / (total_A + total_B)

# 计算标准误差
SE = np.sqrt(p_combined * (1 - p_combined) * (1 / total_A + 1 / total_B))

# 计算Z统计量
Z = (p_A - p_B) / SE

# 计算P值
p_value = 2 * (1 - stats.norm.cdf(np.abs(Z)))

# 显示结果
print("Z统计量:", Z)
print("P值:", p_value)

# 判断是否拒绝零假设
alpha = 0.05
if p_value < alpha:
    print("拒绝零假设,存在显著差异。")
else:
    print("未拒绝零假设,没有足够证据表明两个网站的转化率不同。")
代码中进行了两个网站转化率的假设检验,通过计算 Z 统计量和 P 值来判断是否拒绝零假设。
最后根据 P 值和显著性水平的比较,给出了对零假设的结论。
2. 基本原理 – 显著性水平的选择
2.1 介绍
显著性水平是假设检验中的一个关键参数,表示在假设检验中拒绝零假设的概率阈值。
通常用符号 表示,它决定了犯第一类错误(拒绝了真实的零假设)的概率。
2.2 原理
- 显著性水平 α: 表示在零假设为真时拒绝零假设的概率。通常选择0.05、0.01等较小的值作为显著性水平,表示对第一类错误的容忍度。
2.3 重点和注意事项
- 重点: 显著性水平的选择影响了假设检验的结果,通常选择0.05作为标准,表示在5%的显著性水平下进行检验。
- 注意事项:
- 较小的显著性水平可以降低犯第一类错误的概率,但也可能增加犯第二类错误的概率。
- 显著性水平的选择需要根据具体问题、领域标准和研究目的来确定。
2.4 完整案例
考虑一个案例:某医药公司研发了一种新药物,希望证明该药物的治疗效果显著。我们将设定显著性水平为0.05,用假设检验来判断新药物是否显著提高疾病的治愈率。
数据:
新药物治愈的患者数:90
总的治疗患者数:1000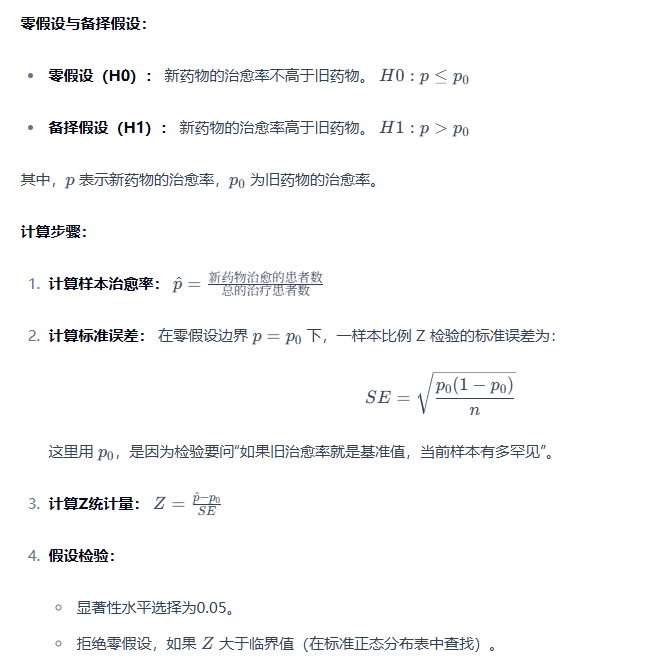
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 数据
cured_patients = 90
total_patients = 1000

# 计算样本治愈率
p_hat = cured_patients / total_patients

# 设定旧药物治愈率和显著性水平
p0 = 0.2
alpha = 0.05

# 在零假设边界 p = p0 下计算标准误差
SE = np.sqrt(p0 * (1 - p0) / total_patients)

# 计算Z统计量
Z = (p_hat - p0) / SE

# 计算P值
p_value = 1 - stats.norm.cdf(Z)

# 显示结果
print("Z统计量:", Z)
print("P值:", p_value)

# 判断是否拒绝零假设
if p_value < alpha:
    print("拒绝零假设,新药物的治愈率显著提高。")
else:
    print("未拒绝零假设,没有足够证据表明新药物的治愈率显著提高。")
以上代码进行了关于新药物治愈率的假设检验。这个案例里样本治愈率是 9%,低于旧药物基准 20%,所以我们不会得到“显著提高”的证据。这里正好提醒我们:统计检验不能替数据说好话,样本方向和备择假设方向必须一致。
3. 检验统计量 – 选择适当的检验统计量
3.1 介绍
在假设检验中,检验统计量是用于量化样本数据与零假设的偏离程度的指标。选择适当的检验统计量是进行假设检验的关键步骤之一。
3.2 原理
- 检验统计量: 衡量样本数据与零假设的一致性或不一致性的统计量。不同的检验问题需要选择不同的检验统计量。
3.3 重点和注意事项
- 重点: 选择适当的检验统计量需要考虑问题的性质、数据的分布和假设的形式。
- 注意事项:
- 检验统计量应具备敏感性,即对于真实差异的检测能力较强。
- 选择检验统计量时要注意问题的特点,例如是均值的比较、方差的比较还是两样本间的关系。
3.4 完整案例
考虑一个案例:某电商公司通过新设计的网站希望提高用户的点击率。我们将使用 t 检验来比较新旧网站的平均点击率是否存在显著差异。
数据:
旧网站点击率:[0.08, 0.09, 0.07, 0.1, 0.11, 0.09, 0.08, 0.1]
新网站点击率:[0.12, 0.14, 0.1, 0.13, 0.15, 0.11, 0.13, 0.12]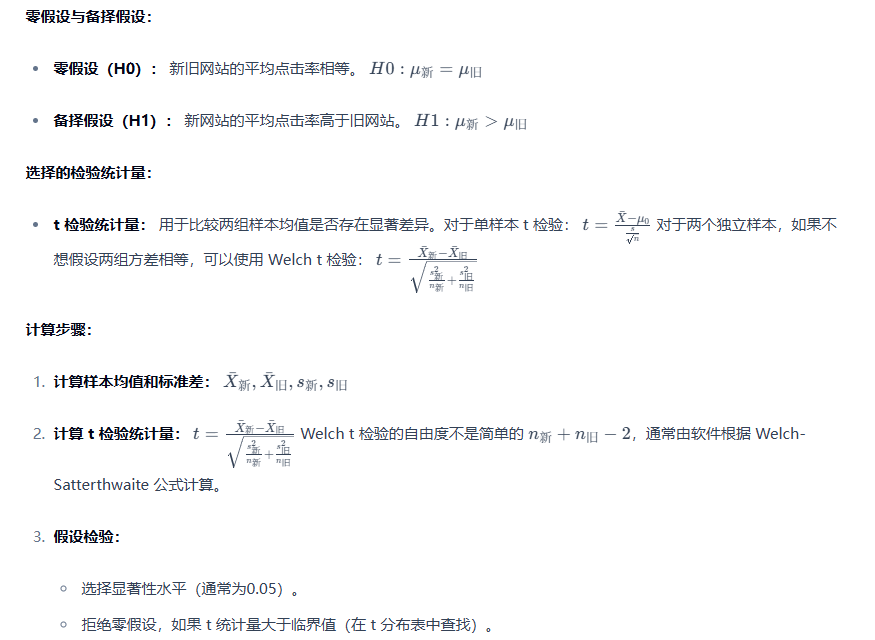
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 数据
click_rate_old = np.array([0.08, 0.09, 0.07, 0.1, 0.11, 0.09, 0.08, 0.1])
click_rate_new = np.array([0.12, 0.14, 0.1, 0.13, 0.15, 0.11, 0.13, 0.12])

# 计算样本均值和标准差
mean_old, mean_new = np.mean(click_rate_old), np.mean(click_rate_new)
std_old, std_new = np.std(click_rate_old, ddof=1), np.std(click_rate_new, ddof=1)

# Welch t 检验:不要求两组方差相等
t_statistic, p_value = stats.ttest_ind(
    click_rate_new,
    click_rate_old,
    equal_var=False,
    alternative='greater'
)

# 显示结果
print("t 检验统计量:", t_statistic)
print("P值:", p_value)

# 判断是否拒绝零假设
alpha = 0.05
if p_value < alpha:
    print("拒绝零假设,新网站的平均点击率显著高于旧网站。")
else:
    print("未拒绝零假设,没有足够证据表明新网站的平均点击率显著高于旧网站。")

# 绘制 t 分布图
x = np.linspace(-4, 4, 1000)
df_approx = len(click_rate_old) + len(click_rate_new) - 2
y = stats.t.pdf(x, df=df_approx)
plt.plot(x, y, label='t Distribution')
plt.vlines(t_statistic, ymin=0, ymax=0.4, color='red', linestyle='--', label='t Statistic')
plt.fill_between(x, y, where=(x >= t_statistic), color='gray', alpha=0.3, label='Area of Interest')
plt.legend()
plt.title('t Distribution and t Statistic')
plt.show()
关于新旧网站平均点击率的 t 检验。通过 Welch t 检验计算 t 统计量和 P 值,判断样本是否支持“新网站点击率更高”这个方向性结论。
同时,绘制了 t 分布图并标注了 t 统计量,以更直观地理解检验的过程。
4. 检验统计量 – 样本均值检验实例
4.1 介绍
样本均值检验是一种用于比较两个或多个样本均值是否存在显著差异的统计方法。在比较两个独立样本均值时,通常使用 t 检验。
4.2 原理
- 样本均值检验: 用于检验两个独立样本的均值是否存在显著差异。通常把“两组均值相等”作为零假设,把“两组均值不相等”或“某一组更高”作为备择假设。
4.3 重点和注意事项
- 重点: 样本均值检验适用于独立的两个样本,用于检验它们的均值是否存在显著差异。
- 注意事项:
- 显著性水平的选择影响最终的结论,通常选择0.05。
- 双侧检验用于判断均值是否不相等,单侧检验用于判断均值的方向性。
4.4 完整案例
考虑一个案例:一家电商公司希望了解两个不同推广策略对用户点击率的影响。我们将使用 t 检验比较两个推广策略的点击率是否存在显著差异。
数据:
推广策略 A 点击率:[0.08, 0.09, 0.07, 0.1, 0.11, 0.09, 0.08, 0.1]
推广策略 B 点击率:[0.12, 0.14, 0.1, 0.13, 0.15, 0.11, 0.13, 0.12]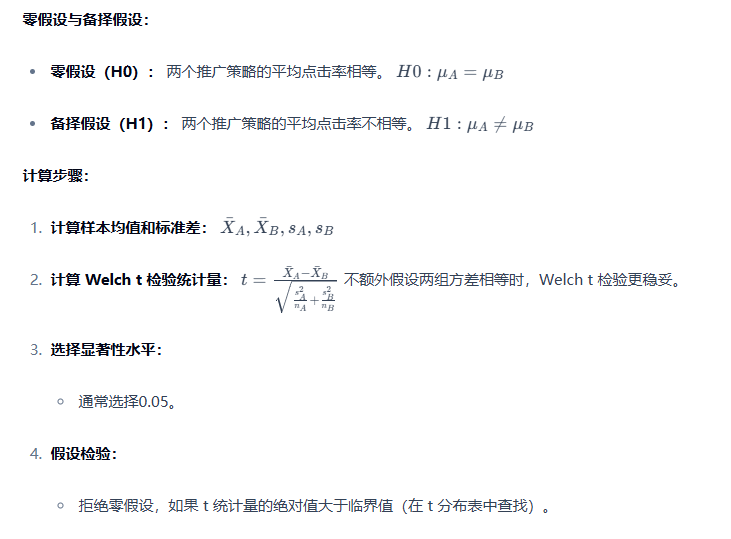
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 数据
click_rate_strategy_A = np.array([0.08, 0.09, 0.07, 0.1, 0.11, 0.09, 0.08, 0.1])
click_rate_strategy_B = np.array([0.12, 0.14, 0.1, 0.13, 0.15, 0.11, 0.13, 0.12])

# 计算样本均值和标准差
mean_A, mean_B = np.mean(click_rate_strategy_A), np.mean(click_rate_strategy_B)
std_A, std_B = np.std(click_rate_strategy_A, ddof=1), np.std(click_rate_strategy_B, ddof=1)

# Welch t 检验:双侧检验
t_statistic, p_value = stats.ttest_ind(
    click_rate_strategy_A,
    click_rate_strategy_B,
    equal_var=False,
    alternative='two-sided'
)

# 显示结果
print("t 检验统计量:", t_statistic)
print("P值:", p_value)

# 判断是否拒绝零假设
alpha = 0.05
if p_value < alpha:
    print("拒绝零假设,两个推广策略的平均点击率存在显著差异。")
else:
    print("未拒绝零假设,没有足够证据表明两个推广策略的平均点击率存在显著差异。")

# 绘制 t 分布图
x = np.linspace(-4, 4, 1000)
df_approx = len(click_rate_strategy_A) + len(click_rate_strategy_B) - 2
y = stats.t.pdf(x, df=df_approx)
plt.plot(x, y, label='t Distribution')
plt.vlines(t_statistic, ymin=0, ymax=0.4, color='red', linestyle='--', label='t Statistic')
plt.fill_between(x, y, where=(x <= -np.abs(t_statistic)) | (x >= np.abs(t_statistic)), color='gray', alpha=0.3, label='Area of Interest')
plt.legend()
plt.title('t Distribution and t Statistic')
plt.show()
以上代码进行了关于两个推广策略点击率的 Welch t 检验。双侧检验关心的是“两者是否不同”,不预设哪一个更高。
5. 拒绝域与显著性水平 – 拒绝域的确定
5.1 介绍
样本均值检验是用于比较两个或多个样本均值是否存在显著差异的统计方法。在比较两个独立样本均值时,通常使用 t 检验。
5.2 原理
- 样本均值检验: 用于检验两个独立样本的均值是否存在显著差异。我们先写清楚零假设和备择假设,再决定使用双侧检验还是单侧检验。
5.3 重点和注意事项
- 重点: 样本均值检验适用于独立的两个样本,用于检验它们的均值是否存在显著差异。
- 注意事项:
- 显著性水平的选择影响最终的结论,通常选择0.05。
- 双侧检验用于判断均值是否不相等,单侧检验用于判断均值的方向性。
5.4 完整案例
考虑一个案例:一家电商公司希望了解两个不同推广策略对用户点击率的影响。我们将使用 t 检验比较两个推广策略的点击率是否存在显著差异。
数据:
推广策略 A 点击率:[0.08, 0.09, 0.07, 0.1, 0.11, 0.09, 0.08, 0.1]
推广策略 B 点击率:[0.12, 0.14, 0.1, 0.13, 0.15, 0.11, 0.13, 0.12]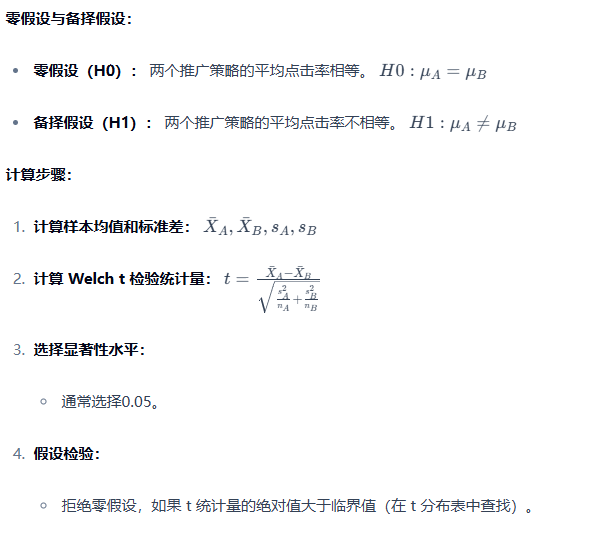
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 数据
click_rate_strategy_A = np.array([0.08, 0.09, 0.07, 0.1, 0.11, 0.09, 0.08, 0.1])
click_rate_strategy_B = np.array([0.12, 0.14, 0.1, 0.13, 0.15, 0.11, 0.13, 0.12])

# 计算样本均值和标准差
mean_A, mean_B = np.mean(click_rate_strategy_A), np.mean(click_rate_strategy_B)
std_A, std_B = np.std(click_rate_strategy_A, ddof=1), np.std(click_rate_strategy_B, ddof=1)

# Welch t 检验:双侧检验
t_statistic, p_value = stats.ttest_ind(
    click_rate_strategy_A,
    click_rate_strategy_B,
    equal_var=False,
    alternative='two-sided'
)

# 显示结果
print("t 检验统计量:", t_statistic)
print("P值:", p_value)

# 判断是否拒绝零假设
alpha = 0.05
if p_value < alpha:
    print("拒绝零假设,两个推广策略的平均点击率存在显著差异。")
else:
    print("未拒绝零假设,没有足够证据表明两个推广策略的平均点击率存在显著差异。")

# 绘制 t 分布图
x = np.linspace(-4, 4, 1000)
df_approx = len(click_rate_strategy_A) + len(click_rate_strategy_B) - 2
y = stats.t.pdf(x, df=df_approx)
plt.plot(x, y, label='t Distribution')
plt.vlines(t_statistic, ymin=0, ymax=0.4, color='red', linestyle='--', label='t Statistic')
plt.fill_between(x, y, where=(x <= -np.abs(t_statistic)) | (x >= np.abs(t_statistic)), color='gray', alpha=0.3, label='Area of Interest')
plt.legend()
plt.title('t Distribution and t Statistic')
plt.show()
以上代码再次演示了拒绝域与 P 值的对应关系:如果 P 值小于显著性水平,样本结果就落入拒绝域。图上的阴影区域只是帮助理解,真正下结论仍以检验设定和 P 值为准。
6. 拒绝域与显著性水平 – 显著性水平的意义
6.1 介绍
显著性水平是假设检验中的一个重要概念,用于控制错误发生的概率。它表示在零假设为真的情况下,拒绝零假设的概率上限。
6.2 原理
- 显著性水平: 通常表示为α(alpha),是在零假设为真的情况下,拒绝零假设的概率上限。常见的显著性水平有0.05、0.01等。
6.3 重点和注意事项
- 重点: 显著性水平用于控制错误发生的概率,通常选择0.05,表示有5%的概率拒绝一个实际上为真的零假设。
- 注意事项:
- 显著性水平过高可能导致过多的错误拒绝,而过低可能让我们更难发现真实差异,也就是第二类错误风险上升。
- 显著性水平的选择应基于实际问题和研究目的。
6.4 完整案例
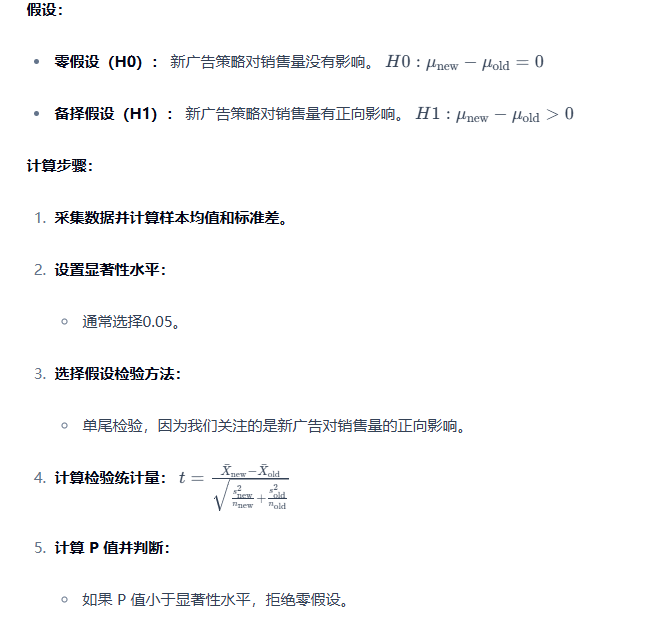
考虑一个案例:一家公司推出了一个新的广告策略,声称这个广告能够显著提高产品的销售量。我们希望通过假设检验来验证这个声明。
数据:
- 假设我们有两组数据,分别是旧广告策略的销售量和新广告策略的销售量。
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 示例数据
rng = np.random.default_rng(42)
sales_old = rng.normal(loc=100, scale=20, size=30)
sales_new = rng.normal(loc=110, scale=20, size=30)

# 计算样本均值和标准差
mean_old, mean_new = np.mean(sales_old), np.mean(sales_new)
std_old, std_new = np.std(sales_old, ddof=1), np.std(sales_new, ddof=1)

# Welch t 检验:单侧检验,备择假设是新广告策略均值更高
t_statistic, p_value = stats.ttest_ind(
    sales_new,
    sales_old,
    equal_var=False,
    alternative='greater'
)

# 显示结果
print("t 检验统计量:", t_statistic)
print("P值:", p_value)

# 判断是否拒绝零假设
alpha = 0.05
if p_value < alpha:
    print("拒绝零假设,新广告策略对销售量有显著影响。")
else:
    print("未拒绝零假设,没有足够证据表明新广告策略对销售量有显著影响。")

# 绘制 t 分布图
x = np.linspace(-4, 4, 1000)
df_approx = len(sales_new) + len(sales_old) - 2
y = stats.t.pdf(x, df=df_approx)
plt.plot(x, y, label='t Distribution')
plt.vlines(t_statistic, ymin=0, ymax=0.4, color='red', linestyle='--', label='t Statistic')
plt.fill_between(x, y, where=(x >= t_statistic), color='gray', alpha=0.3, label='Area of Interest')
plt.legend()
plt.title('t Distribution and t Statistic')
plt.show()
以上代码进行了关于新广告策略对销售量影响的 Welch t 检验。这里是单侧检验,因为问题本身关心“是否提高”,不是简单地问“是否不同”。
7. 决定规则 – 制定明确的决定规则
7.1 介绍
决定规则是假设检验中的一组明确的步骤和判据,用于根据样本数据对零假设进行判断,最终决定是否拒绝零假设。
7.2 原理
- 决定规则: 制定了在假设检验中根据样本数据做出决策的步骤。通常包括计算检验统计量、选择显著性水平、计算P值、拒绝或不拒绝零假设等步骤。
7.3 重点和注意事项
- 重点: 决定规则的制定直接影响了最终的假设检验结果,需要根据实际问题和研究目的明确每一步的操作。
- 注意事项:
- 显著性水平的选择和假设检验的类型(单尾或双尾)是决定规则的关键因素。
- 决定规则的制定应遵循科学的原则,避免主观性的干扰。
7.4 完整案例
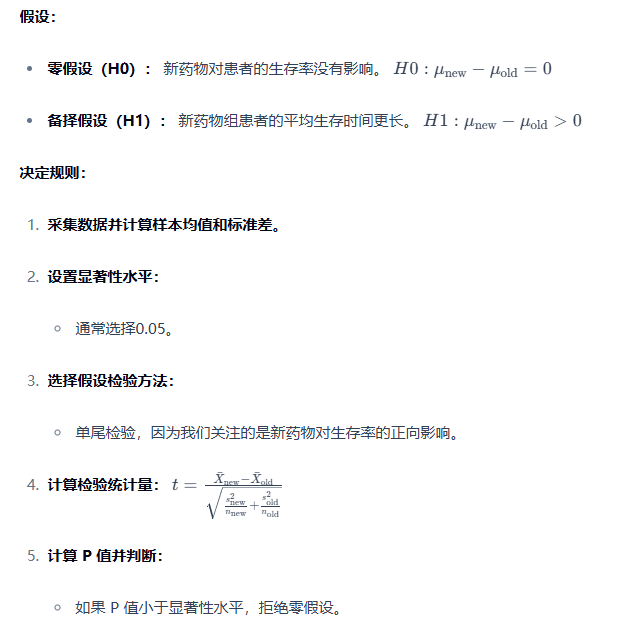
考虑一个案例:一家制药公司开发了一种新药物,声称这种药物能够显著提高患者的生存率。我们希望通过假设检验来验证这个声明。
数据:
- 假设我们有两组数据,分别是使用新药物的患者和使用老药物的患者的生存时间。
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 示例数据
rng = np.random.default_rng(42)
survival_old = rng.normal(loc=50, scale=10, size=30)
survival_new = rng.normal(loc=55, scale=10, size=30)

# 计算样本均值和标准差
mean_old, mean_new = np.mean(survival_old), np.mean(survival_new)
std_old, std_new = np.std(survival_old, ddof=1), np.std(survival_new, ddof=1)

# Welch t 检验:单侧检验,备择假设是新药物组均值更高
t_statistic, p_value = stats.ttest_ind(
    survival_new,
    survival_old,
    equal_var=False,
    alternative='greater'
)

# 显示结果
print("t 检验统计量:", t_statistic)
print("P值:", p_value)

# 判断是否拒绝零假设
alpha = 0.05
if p_value < alpha:
    print("拒绝零假设,新药物对患者的生存率有显著影响。")
else:
    print("未拒绝零假设,没有足够证据表明新药物对患者的生存率有显著影响。")

# 绘制 t 分布图
x = np.linspace(-4, 4, 1000)
df_approx = len(survival_new) + len(survival_old) - 2
y = stats.t.pdf(x, df=df_approx)
plt.plot(x, y, label='t Distribution')
plt.vlines(t_statistic, ymin=0, ymax=0.4, color='red', linestyle='--', label='t Statistic')
plt.fill_between(x, y, where=(x >= t_statistic), color='gray', alpha=0.3, label='Area of Interest')
plt.legend()
plt.title('t Distribution and t Statistic')
plt.show()
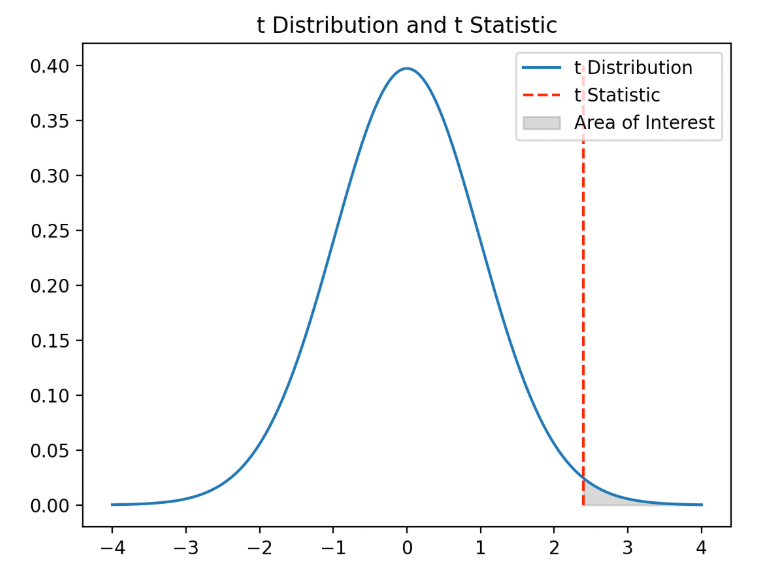
以上代码把决定规则落到实际计算上:先声明备择方向,再计算 P 值,最后按 α 判断是否拒绝零假设。这里的“未拒绝”不是证明新药无效,而是当前样本还不够支持这个方向性结论。












请登录后查看评论内容