

8.1 介绍
在假设检验中,制定决定规则的一个关键目标是避免第一类错误和第二类错误。第一类错误是错误地拒绝了一个为真的零假设,而第二类错误是未能拒绝一个为假的零假设。
8.2 原理
- 第一类错误: 错误地拒绝了一个为真的零假设,导致对研究问题的不准确结论。
- 第二类错误: 未能拒绝一个为假的零假设,同样导致对研究问题的不准确结论。
8.3 重点和注意事项
- 重点: 设定显著性水平(α)和功效(1-β)以平衡第一类和第二类错误的概率。
- 注意事项:
- 选择合适的显著性水平是决策的重要一步。
- 需要权衡第一类和第二类错误,取决于研究问题的重要性。
8.4 完整案例
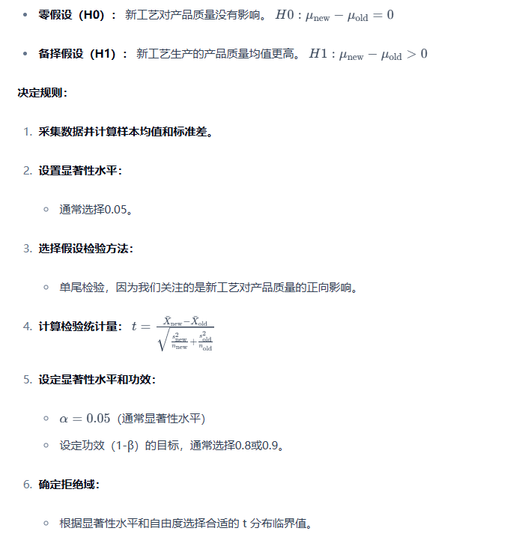
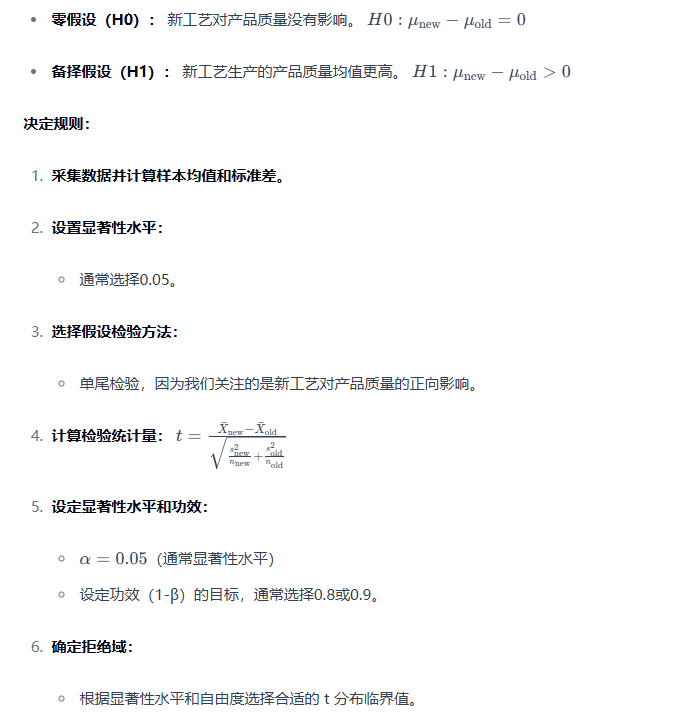
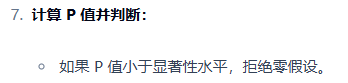
考虑一个案例:一家公司声称新的生产工艺能够显著提高产品的质量。我们希望通过假设检验来验证这个声明。
数据:
- 假设我们有两组数据,分别是使用新工艺生产的产品和使用旧工艺生产的产品的质量指标。
假设:
Python代码:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 示例数据
rng = np.random.default_rng(42)
quality_old = rng.normal(loc=90, scale=5, size=30)
quality_new = rng.normal(loc=95, scale=5, size=30)

# 计算样本均值和标准差
mean_old, mean_new = np.mean(quality_old), np.mean(quality_new)
std_old, std_new = np.std(quality_old, ddof=1), np.std(quality_new, ddof=1)

# Welch t 检验:单侧检验,备择假设是新工艺质量均值更高
t_statistic, p_value = stats.ttest_ind(
    quality_new,
    quality_old,
    equal_var=False,
    alternative='greater'
)

# 显示结果
print("t 检验统计量:", t_statistic)
print("P值:", p_value)

# 设置显著性水平和功效目标
alpha = 0.05
power_target = 0.8

# 计算 t 分布的临界值
df_approx = len(quality_new) + len(quality_old) - 2
critical_value = stats.t.ppf(1 - alpha, df=df_approx)

# 近似计算功效,用于帮助理解第一类错误和第二类错误的权衡
power = 1 - stats.t.cdf(critical_value - t_statistic, df=df_approx)

# 显示结果
print("临界值:", critical_value)
print("功效:", power)

# 绘制 t 分布图
x = np.linspace(-4, 4, 1000)
y = stats.t.pdf(x, df=df_approx)
plt.plot(x, y, label='t Distribution')
plt.vlines(t_statistic, ymin=0, ymax=0.4, color='red', linestyle='--', label='t Statistic')
plt.vlines(critical_value, ymin=0, ymax=0.4, color='blue', linestyle='--', label='Critical Value')
plt.fill_between(x, y, where=(x >= critical_value), color='gray', alpha=0.3, label='Rejection Region')
plt.legend()
plt.title('t Distribution and t Statistic')
plt.show()
以上代码进行了关于新工艺对产品质量影响的 Welch t 检验,并用临界值和功效近似展示第一类错误、第二类错误之间的权衡。要注意,功效分析在正式项目里通常需要事先设定最小可检测效应、样本量和方差假设,不能只在结果出来后随手算一个数就当作完整结论。
关于统计学的内容,到这里总结差不多了。介绍了描述性统计的核心概念,如均值、方差和分位数,帮助理解数据的集中趋势与分布特征。还讲解了变量间关系的度量方法(如相关系数),并引入了假设检验的基本原理与应用流程。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容