

一、全球气候变化趋势分析
1.1 案例名称
全球气候变化趋势分析
1.2 分析目标
本案例旨在分析全球气候变化趋势,基于历史气温数据,挖掘以下关键问题:
- 全球地表平均气温是否呈现显著的上升趋势?
- 温度波动的范围(不确定性)是否随着时间推移发生变化?
- 各时间段的温度变化模式是否存在周期性或异常事件(如极端天气)?
1.3 背景与业务需求
全球气候变化是一个备受关注的全球性议题,科学界和政策制定者需要准确的数据支持来制定应对措施。
背景如下:
- 研究意义:了解过去的气温变化趋势有助于预测未来的气候变化,并为政府和环保组织提供科学依据。
- 业务需求:为气候政策制定者提供数据支持,帮助评估人类活动对气候的影响以及应对全球变暖的必要性。
1.4 假设设定
- 全球地表平均气温在过去两个世纪中呈现显著上升趋势。
- 温度的不确定性(波动范围)随着时间推移逐渐减小,可能与数据记录技术的改进有关。
- 存在显著的周期性变化或异常事件(例如火山喷发、工业革命等),对气温产生阶段性影响。
2. 数据探索
以下对数据集的探索分析,包括数据的基本信息、分布、趋势和相关性分析,并通过图表展示数据特征。
2.1 数据基本信息与描述
我们将加载数据集 GlobalTemperatures.csv,并检查其基本信息,包括列名、数据类型、缺失值情况等。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 加载数据集
file_path = './dataset/001/GlobalTemperatures.csv'
data = pd.read_csv(file_path)

# 查看数据基本信息
print("数据集基本信息:")
print(data.info())  # 显示数据类型和非空值
print("\n数据集前5行:")
print(data.head())  # 显示前5行数据

# 检查数据的描述性统计
print("\n数据集的描述性统计:")
print(data.describe())
2.2 数据趋势与分布可视化
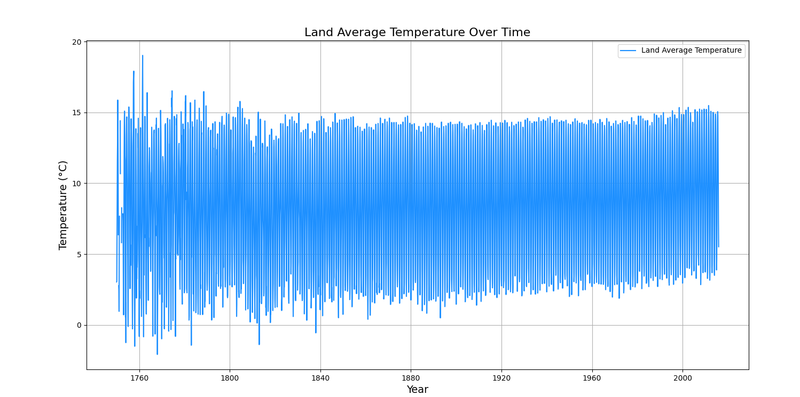
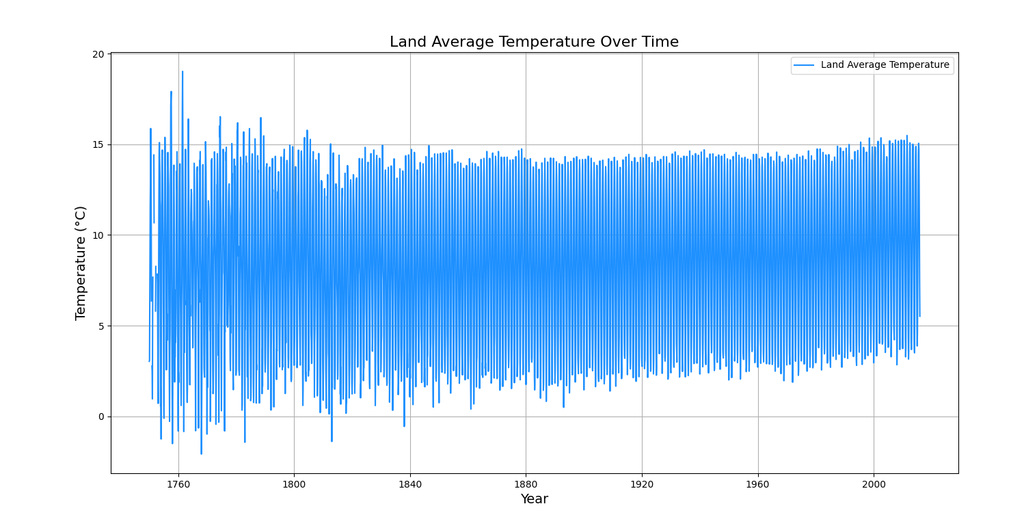
分析全球地表平均气温(LandAverageTemperature)的时间趋势,使用折线图展示温度的变化趋势。
# 将日期列转换为datetime格式
data['dt'] = pd.to_datetime(data['dt'])

# 设置日期为索引
data.set_index('dt', inplace=True)

# 绘制全球地表平均气温的时间趋势
plt.figure(figsize=(16, 8))
plt.plot(data.index, data['LandAverageTemperature'], color='dodgerblue', label='Land Average Temperature')
plt.title('Land Average Temperature Over Time', fontsize=16)
plt.xlabel('Year', fontsize=14)
plt.ylabel('Temperature (°C)', fontsize=14)
plt.legend()
plt.grid(True)
plt.show()折线图:显示气温随时间的变化趋势,观察是否有显著的上升趋势。
2.3 数据分布分析
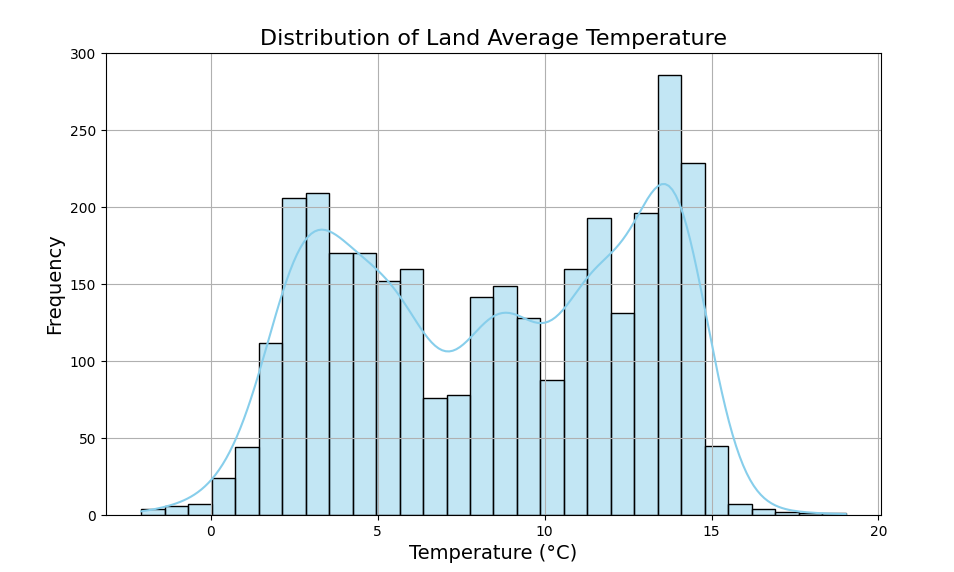
我们绘制 LandAverageTemperature 的分布图,观察其分布形态。
 # 绘制直方图和核密度估计图
plt.figure(figsize=(10, 6))
sns.histplot(data['LandAverageTemperature'].dropna(), kde=True, color='skyblue', bins=30)
plt.title('Distribution of Land Average Temperature', fontsize=16)
plt.xlabel('Temperature (°C)', fontsize=14)
plt.ylabel('Frequency', fontsize=14)
plt.grid(True)
plt.show()分布图:通过直方图和核密度估计,分析气温数据的分布形态是否符合正态分布。
2.4 数据相关性分析
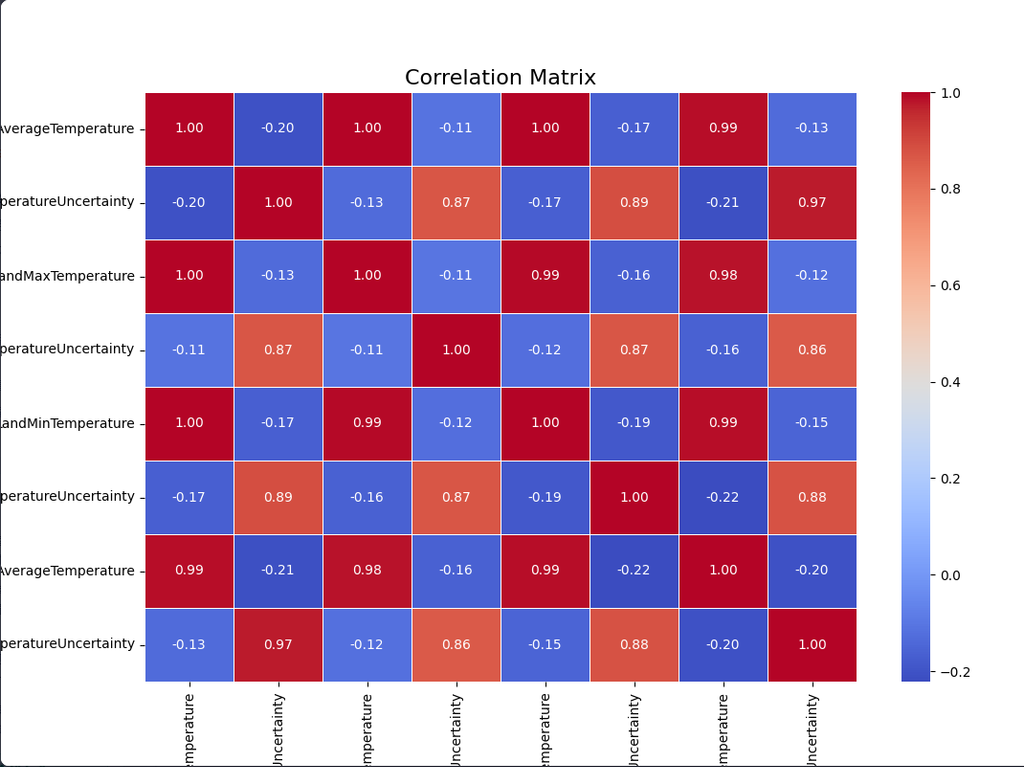
通过热力图分析各变量之间的相关性。
# 计算相关性矩阵
correlation_matrix = data.corr()

# 绘制热力图
plt.figure(figsize=(12, 8))
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm', fmt=".2f", linewidths=0.5)
plt.title('Correlation Matrix', fontsize=16)
plt.show()热力图:揭示变量之间的相关性,例如地表温度与海洋温度的关系。
3. 数据清洗
3.1 数据清洗目标
- 处理缺失值:识别并填补或删除缺失值,确保数据完整性。
- 处理异常值:检测并调整可能的异常数据,防止其对分析结果产生误导。
- 处理重复数据:检查并去除重复数据,避免冗余。
以下是针对 GlobalTemperatures.csv 数据集的清洗步骤。
3.2 检查并处理缺失值
# 检查缺失值情况
print("每列缺失值数量:")
print(data.isnull().sum())

# 可视化缺失值分布
plt.figure(figsize=(12, 6))
sns.heatmap(data.isnull(), cbar=False, cmap='viridis')
plt.title('Missing Values Heatmap', fontsize=16)
plt.show()

# 填充缺失值(以插值为例)
data_cleaned = data.copy()
data_cleaned.interpolate(method='linear', inplace=True)  # 线性插值填补缺失值

# 由于后面使用到了,LandAndOceanAverageTemperature 和 LandAndOceanAverageTemperature,这里做 前向填充 和 后向填充
# 前向填充
data_cleaned['LandAndOceanAverageTemperature'] = data_cleaned['LandAndOceanAverageTemperature'].fillna(method='ffill')
# 后向填充
data_cleaned['LandAndOceanAverageTemperature'] = data_cleaned['LandAndOceanAverageTemperature'].fillna(method='bfill')

print("\n缺失值处理后,仍有缺失值的列:")
print(data_cleaned.isnull().sum())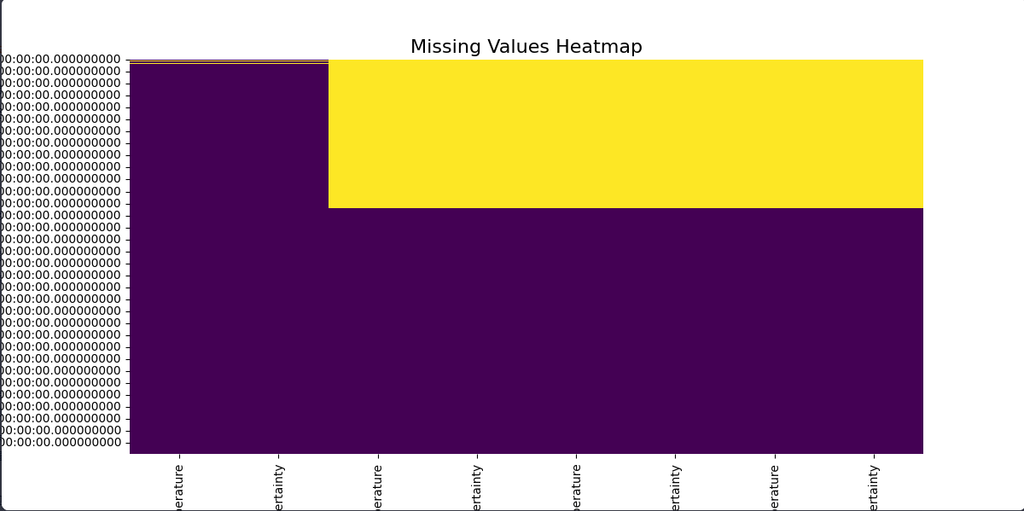
3.3 检查并处理异常值
异常值可能是由于记录错误或极端天气事件引起的,我们通过统计方法或可视化检测异常值。
# 使用箱线图检测异常值
plt.figure(figsize=(12, 6))
sns.boxplot(data=data_cleaned[['LandAverageTemperature', 'LandMaxTemperature', 'LandMinTemperature']], palette='Set2')
plt.title('Boxplot for Temperature Variables', fontsize=16)
plt.show()

# 计算上下四分位范围(IQR)来标记异常值
Q1 = data_cleaned['LandAverageTemperature'].quantile(0.25)
Q3 = data_cleaned['LandAverageTemperature'].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

# 标记异常值
outliers = data_cleaned[(data_cleaned['LandAverageTemperature'] < lower_bound) |
                        (data_cleaned['LandAverageTemperature'] > upper_bound)]
print(f"检测到 {len(outliers)} 个异常值。")

# 处理异常值:使用上下限值进行截断(Winsorization)
data_cleaned['LandAverageTemperature'] = np.clip(data_cleaned['LandAverageTemperature'], lower_bound, upper_bound)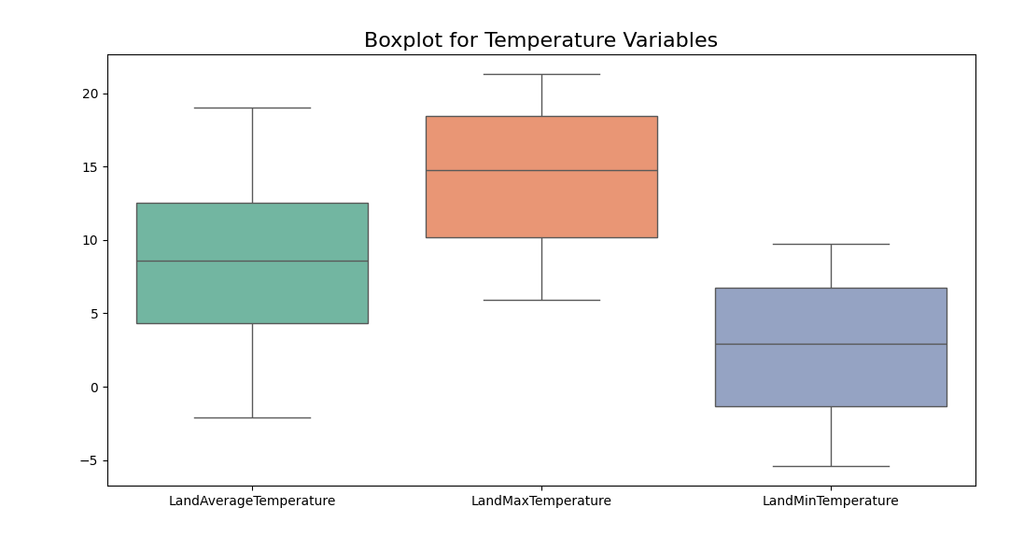
3.4 检查并处理重复数据
# 检查重复数据
duplicates = data_cleaned.duplicated().sum()
print(f"检测到 {duplicates} 条重复记录。")

# 删除重复数据
data_cleaned.drop_duplicates(inplace=True)
print(f"清理后数据集大小:{data_cleaned.shape}")
3.5 数据质量检查
在完成清洗后,验证数据质量。
# 检查清洗后数据的描述性统计
print("\n清洗后数据的描述性统计:")
print(data_cleaned.describe())

# 绘制清洗后的时间趋势图,确认数据合理性
plt.figure(figsize=(16, 8))
plt.plot(data_cleaned.index, data_cleaned['LandAverageTemperature'], color='dodgerblue', label='Cleaned Land Average Temperature')
plt.title('Cleaned Land Average Temperature Over Time', fontsize=16)
plt.xlabel('Year', fontsize=14)
plt.ylabel('Temperature (°C)', fontsize=14)
plt.legend()
plt.grid(True)
plt.show()
3.5 小结
- 缺失值处理:采用线性插值法填补缺失值,适用于时间序列数据。
- 异常值处理:通过箱线图和 IQR 检测,并采用上下限截断法(Winsorization)调整异常值。
- 重复数据处理:删除重复记录,确保数据唯一性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容