

1. 目标定义和假设设定
1.1 项目背景
电影行业是一个竞争激烈且充满不确定性的市场。电影票房的成功受多种因素影响,如电影类型、预算、上映时间、口碑评分等。分析这些因素如何影响票房表现,有助于电影制片方、发行公司和投资者优化决策,提高电影的盈利能力。
1.2 数据分析目标
本项目的目标是通过探索 The Movies Dataset 数据集,分析影响电影票房的主要因素,并进行数据可视化,以揭示不同变量对票房的影响。
具体来说,我们关注以下几个问题:
- 电影的 预算 与票房收入 之间是否存在相关性?高预算电影是否更容易获得高票房?
- 不同 电影类型(Genre) 对票房收入的影响如何?哪些类型的电影更受观众欢迎?
- 电影 评分(Vote Average) 是否会影响票房收入?高评分电影是否更受市场欢迎?
- 上映年份 是否影响电影的票房表现?是否存在某些年份票房整体更高?
- 制作公司(Production Companies) 是否对电影票房有显著影响?
- 关键词(Keywords) 是否能帮助预测票房高低?是否存在某些关键词的电影更容易成功?
- 观众评分数据(Ratings) 如何影响电影票房?是否存在评分越多、票房越高的现象?
1.3 假设设定(Hypotheses)
为了回答上述问题,我们设定以下假设,并将在后续数据分析中进行验证:
H1: 电影预算越高,票房收入越高。
- 直觉上,投资更多资金的电影往往有更好的制作质量、演员阵容、营销资源,因此可能会获得更高的票房收入。
- 我们可以通过 预算(budget) 和票房收入(revenue) 计算相关性,分析二者是否存在统计学上的关系。
H2: 电影类型对票房收入有显著影响,不同类型的电影票房表现不同。
- 某些类型的电影,如 动作(Action) 或科幻(Sci-Fi),可能比剧情片(Drama)更受欢迎。
- 我们可以计算不同电影类型的 票房中位数 或票房均值,并进行数据可视化。
H3: 电影评分(vote_average)与票房收入正相关。
- 评分高的电影通常质量更好,口碑更强,因此可能会吸引更多观众,带来更高票房。
- 我们可以计算 评分 vs. 票房 的相关性,观察趋势。
H4: 近年上映的电影票房高于早年上映的电影。
- 电影行业随技术进步、观影习惯变化,近年来可能有更高的票房收入。
- 通过时间序列分析,观察不同年份电影的票房变化趋势。
H5: 电影制作公司影响电影票房,知名电影公司出品的电影票房更高。
- 例如,迪士尼、华纳兄弟等大公司可能比小型独立电影公司更容易获得票房成功。
- 计算不同制作公司的平均票房,并进行可视化比较。
H6: 电影的关键词可以预测票房,某些关键词的电影更容易成功。
- 例如,包含 “superhero”(超级英雄)或“franchise”(系列电影)关键词的电影,可能票房更高。
- 提取电影关键词,计算与票房的关系,找出高票房关键词。
H7: 观众评分次数(vote_count)越多,票房越高。
- 评分次数较多的电影,说明观看人数较多,因此票房可能更高。
- 计算 评分次数 vs. 票房 的相关性,分析趋势。
2. 数据探索
在进行数据分析之前,需要对数据进行探索,以了解数据的基本情况,并对异常数据进行处理,确保数据质量。
数据探索的主要步骤:
2.1 加载数据并查看基本信息
首先,我们加载四个主要数据集:
movies_metadata.csv:包含电影的基本信息,如预算、上映时间、票房收入、评分等。ratings_small.csv:包含观众对电影的评分数据。credits.csv:包含演员和导演信息。keywords.csv:包含电影的关键词信息。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 读取数据集
movies_metadata = pd.read_csv('dataset/002/movies_metadata.csv', low_memory=False)
ratings = pd.read_csv('dataset/002/ratings_small.csv')
credits = pd.read_csv('dataset/002/credits.csv')
keywords = pd.read_csv('dataset/002/keywords.csv')

# 查看movies_metadata数据集的基本信息
print(movies_metadata.info())
print(movies_metadata.head())pd.read_csv()用于读取 CSV 文件。low_memory=False解决数据类型推断问题,防止数据类型不一致导致的警告。movies_metadata.info()可以查看数据集的列名、非空值数量、数据类型等。movies_metadata.head()可以查看数据前五行数据,了解基本格式。
2.2 数据清洗
数据清洗主要包括:
- 处理 缺失值:删除或填充缺失值(NaN)。
- 处理 异常值:如票房收入为负数的情况。
- 处理 数据类型:将字符串转换为合适的数据类型(如时间、数值等)。
2.2.1 处理缺失值
# 检查movies_metadata数据集中缺失值的情况
print(movies_metadata.isnull().sum())

# 删除不必要的列,如 'homepage','tagline',这些列信息不影响票房分析
movies_metadata.drop(columns=['homepage', 'tagline'], inplace=True)

# 对关键数值型列进行缺失值填充
movies_metadata['budget'].fillna(0, inplace=True)
movies_metadata['revenue'].fillna(0, inplace=True)
movies_metadata['runtime'].fillna(movies_metadata['runtime'].median(), inplace=True)

# 对分类变量进行缺失值填充
movies_metadata['status'].fillna('Unknown', inplace=True)isnull().sum()统计每列的缺失值数量。- 删除无关列,如
homepage和tagline,这些信息对票房预测影响较小。 fillna(0)用 0 填充缺失的budget和revenue,表示预算和票房为空的电影视作无预算或无票房。runtime使用 中位数 填充,因为电影时长一般符合正态分布,使用中位数可减少异常影响。status为空时填充'Unknown'。
2.2.2 处理数据类型
某些列的数据类型需要转换,以便后续分析。
# 转换 id 为字符串类型
movies_metadata['id'] = movies_metadata['id'].astype(str)

# 处理日期格式
movies_metadata['release_date'] = pd.to_datetime(movies_metadata['release_date'], errors='coerce')

# 处理 budget 和 revenue 的数据类型为整数
movies_metadata['budget'] = pd.to_numeric(movies_metadata['budget'], errors='coerce').fillna(0).astype(int)
movies_metadata['revenue'] = pd.to_numeric(movies_metadata['revenue'], errors='coerce').fillna(0).astype(int)astype(str)确保id为字符串,避免数值运算错误。pd.to_datetime()解析release_date为日期类型,errors='coerce'遇到无法转换的值会变为NaT,便于处理缺失值。pd.to_numeric(errors='coerce')强制budget和revenue转换为数值,无法转换的变为NaN,然后填充0并转换为整数。
2.3. 统计描述与数据分布分析
2.3.1 查看关键数值变量的统计信息
print(movies_metadata[['budget', 'revenue', 'runtime', 'vote_average', 'vote_count']].describe())describe()方法返回数据的均值、标准差、最小值、最大值等,帮助分析数据分布是否正常。
2.3.2 票房收入与预算的分布
# 设置图形风格
sns.set_style("darkgrid")

# 绘制预算和票房收入的分布
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# 预算分布
sns.histplot(movies_metadata[movies_metadata['budget'] > 0]['budget'], bins=50, kde=True, ax=axes[0], color="blue")
axes[0].set_title("Distribution of Movie Budgets")
axes[0].set_xlabel("Budget")
axes[0].set_ylabel("Count")

# 票房收入分布
sns.histplot(movies_metadata[movies_metadata['revenue'] > 0]['revenue'], bins=50, kde=True, ax=axes[1], color="red")
axes[1].set_title("Distribution of Movie Revenues")
axes[1].set_xlabel("Revenue")
axes[1].set_ylabel("Count")

plt.show()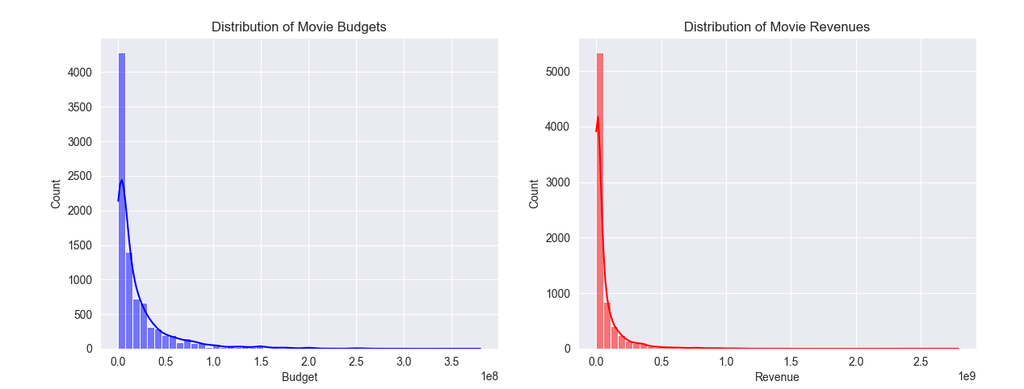
sns.histplot()生成直方图,bins=50代表分成 50 个区间,kde=True添加核密度估计曲线。movies_metadata[movies_metadata['budget'] > 0]过滤掉预算为 0 的数据,避免干扰分析。- 通过
figsize=(14, 5)创建 两个子图,左侧显示预算分布,右侧显示票房收入分布。
2.3.3 电影评分与票房的相关性
plt.figure(figsize=(8, 6))
sns.scatterplot(x=movies_metadata['vote_average'], y=movies_metadata['revenue'], alpha=0.5)
plt.title("Vote Average vs Revenue")
plt.xlabel("Vote Average")
plt.ylabel("Revenue")
plt.show()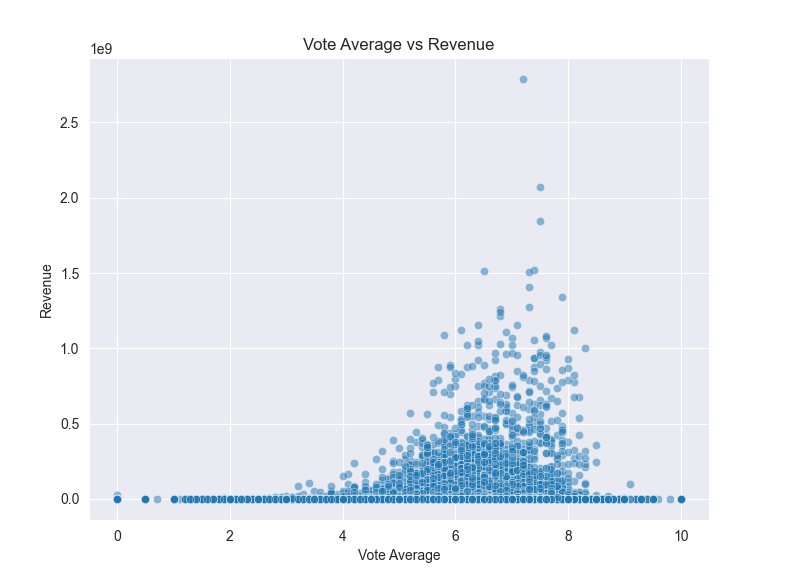
scatterplot()绘制散点图,alpha=0.5使点透明度降低,减少重叠带来的视觉混乱。- 通过观察 评分与票房 的关系,判断高评分电影是否更容易获得高票房。
2.3.4 电影类型与票房的关系
# 解析电影类型
import ast

def extract_genres(genre_str):
    try:
        genres = ast.literal_eval(genre_str)
        return [genre['name'] for genre in genres]
    except:
        return []

movies_metadata['genres'] = movies_metadata['genres'].apply(extract_genres)

# 计算不同电影类型的平均票房
genre_revenue = {}
for genres, revenue in zip(movies_metadata['genres'], movies_metadata['revenue']):
    for genre in genres:
        if genre in genre_revenue:
            genre_revenue[genre].append(revenue)
        else:
            genre_revenue[genre] = [revenue]

# 计算平均票房
genre_avg_revenue = {genre: np.mean(revenues) for genre, revenues in genre_revenue.items()}

# 绘制柱状图
plt.figure(figsize=(12, 6))
sns.barplot(x=list(genre_avg_revenue.keys()), y=list(genre_avg_revenue.values()), palette="viridis")
plt.xticks(rotation=45)
plt.title("Average Revenue by Genre")
plt.xlabel("Genre")
plt.ylabel("Average Revenue")
plt.show()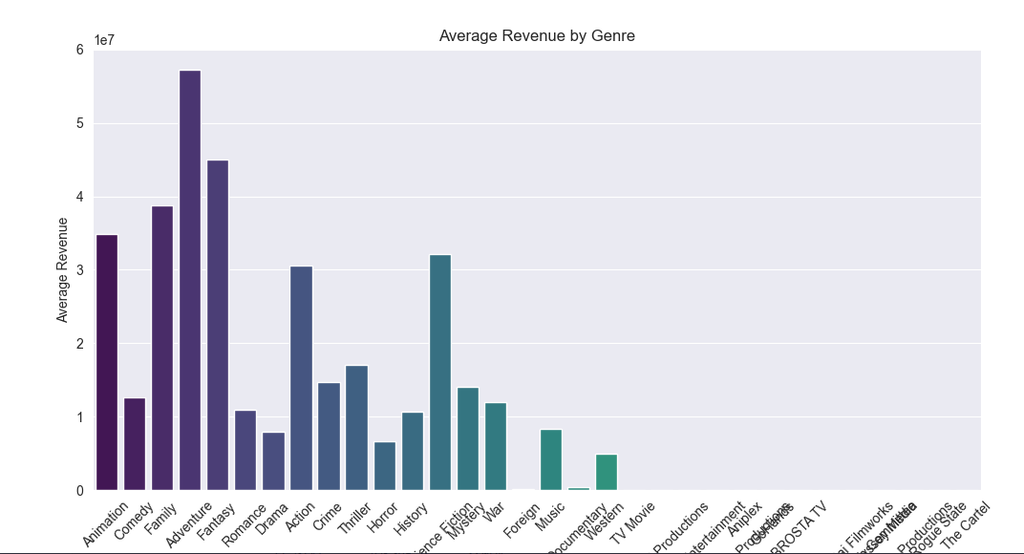
ast.literal_eval()解析 JSON 格式的genres数据。- 计算不同电影类型的平均票房,并使用
barplot()绘制柱状图。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容