

在数据探索之后,我们需要对数据进行 特征工程,以提取更具代表性的信息,并为后续的建模和分析做好准备。
特征工程的核心目标是 选择、构造和优化特征,使其能更好地反映数据的内在关系。
这里主要涉及:
- 特征选择:去除不相关或冗余的特征,保留对电影票房有影响的关键特征。
- 特征提取:对复杂字段(如
genres、production_companies)进行解析,将其转换为可用于建模的数值特征。 - 特征构造:创建新的特征,如投资回报率(ROI)、电影时长类别等,增强数据的可解释性。
- 数据分割:将数据集拆分为训练集和测试集,为后续建模做准备。
3.1 特征选择
电影数据集包含很多字段,但并不是所有字段都对票房预测有帮助。我们需要筛选出与票房收入(revenue)相关的特征。
以下特征被认为是有潜在价值的:
budget(预算):电影的投入成本,通常影响票房表现。runtime(时长):电影的时长可能会影响观众体验,进而影响票房。vote_average(平均评分):评分高的电影可能更受欢迎。vote_count(评分人数):评分人数多的电影可能有更高的关注度。release_date(上映日期):上映的时间可能会影响票房。genres(类型):不同类型的电影可能有不同的票房表现。production_companies(制作公司):知名公司制作的电影可能票房更高。
首先,选择与票房预测相关的字段:
selected_columns = ['budget', 'runtime', 'vote_average', 'vote_count', 'release_date', 'genres', 'production_companies', 'revenue']
movies_data = movies_metadata[selected_columns].copy()- 我们筛选了
budget、runtime、vote_average等关键变量,并去掉了如imdb_id、homepage等无关变量,以减少噪音,提高模型性能。
3.2. 特征提取
某些字段(如 genres、production_companies)是 非结构化数据,需要进行解析并转换成可以用于建模的数值类型。
3.2.1 处理电影类型(Genres)
电影类型(genres)字段的存储格式是 JSON-like,需要解析为列表,并转换为可用于分析的独热编码(One-Hot Encoding)。
import ast

# 解析JSON格式的电影类型
def extract_genres(genre_str):
    try:
        genres = ast.literal_eval(genre_str)
        return [genre['name'] for genre in genres]
    except:
        return []

movies_data['genres'] = movies_data['genres'].apply(extract_genres)

# 进行独热编码
from sklearn.preprocessing import MultiLabelBinarizer

mlb = MultiLabelBinarizer()
genres_encoded = pd.DataFrame(mlb.fit_transform(movies_data['genres']), columns=mlb.classes_)

# 合并到原数据集
movies_data = pd.concat([movies_data, genres_encoded], axis=1)
movies_data.drop(columns=['genres'], inplace=True)ast.literal_eval()解析 JSON 字符串,将其转换为 Python 列表。MultiLabelBinarizer()将电影类型转换为 独热编码,每种类型对应一个二元特征(1 表示属于该类型,0 表示不属于)。- 最后,删除原始
genres列,并用编码后的数据替换。
3.2.2 处理制作公司(Production Companies)
电影的制作公司可能影响票房,但 production_companies 字段同样是 JSON-like 数据,我们可以提取 最常见的制作公司 并进行编码。
# 提取前 10 个最常见的制作公司
from collections import Counter

def extract_companies(company_str):
    try:
        companies = ast.literal_eval(company_str)
        return [company['name'] for company in companies]
    except:
        return []

movies_data['production_companies'] = movies_data['production_companies'].apply(extract_companies)

# 统计出现次数最多的前10个公司
all_companies = [company for sublist in movies_data['production_companies'] for company in sublist]
top_companies = [company for company, _ in Counter(all_companies).most_common(10)]

# 创建二元特征
for company in top_companies:
    movies_data[company] = movies_data['production_companies'].apply(lambda x: 1 if company in x else 0)

# 删除原始 production_companies 列
movies_data.drop(columns=['production_companies'], inplace=True)Counter计算所有制作公司出现的次数,选出前 10 个最常见的公司。- 通过
apply(lambda x: 1 if company in x else 0)为前 10 个公司创建独热编码。
3.3 特征构造
我们可以基于已有特征构造新的变量,以增强预测能力。
3.3.1 计算投资回报率(ROI)
ROI(Return on Investment)是衡量电影投资回报的重要指标:
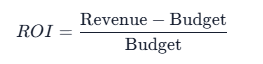
# 计算 ROI,避免除零错误
movies_data['ROI'] = movies_data.apply(lambda row: (row['revenue'] - row['budget']) / row['budget'] if row['budget'] > 0 else 0, axis=1)- 计算 ROI,若
budget为 0,则 ROI 设为 0。
3.3.2 电影时长类别
电影的时长可能影响观众的体验,因此可以将 runtime 进行 分桶 处理:
# 创建时长类别
def categorize_runtime(runtime):
    if runtime < 60:
        return 'Short'
    elif 60 <= runtime < 90:
        return 'Medium'
    elif 90 <= runtime < 120:
        return 'Long'
    else:
        return 'Very Long'

movies_data['runtime_category'] = movies_data['runtime'].apply(categorize_runtime)

# 进行独热编码
movies_data = pd.get_dummies(movies_data, columns=['runtime_category'])- 电影时长被分为 Short (<60 min)、** Medium (60-90 min)、 Long (90-120 min)、 Very Long (>120 min)**,并转换为独热编码。
3.4 数据分割
在进行建模之前,我们需要做一些数据处理,以及需要将数据集拆分为 训练集和测试集:
from sklearn.model_selection import train_test_split

# 处理 'release_date' 列,将其转换为 datetime 类型
movies_metadata['release_date'] = pd.to_datetime(movies_metadata['release_date'], errors='coerce')

# 提取日期特征
movies_metadata['release_year'] = movies_metadata['release_date'].dt.year
movies_metadata['release_month'] = movies_metadata['release_date'].dt.month
movies_metadata['release_day'] = movies_metadata['release_date'].dt.day
movies_metadata['release_weekday'] = movies_metadata['release_date'].dt.weekday

# 删除原始的 'release_date' 列,因为我们已经提取了有用的特征
movies_metadata.drop(columns=['release_date'], inplace=True)

# 处理缺失值,填充 'release_year' 的缺失值
movies_metadata['release_year'].fillna(movies_metadata['release_year'].mode()[0], inplace=True)

# 2. 特征选择与目标变量选择
# 选择与票房相关的特征并创建输入数据 X 和目标变量 y
# 假设我们用 'budget' 和提取的日期特征作为特征,目标是 'revenue'
movies_metadata = movies_metadata[['budget', 'release_year', 'release_month', 'release_day', 'release_weekday', 'revenue']]

# 去除含有缺失值的行
movies_metadata.dropna(subset=['budget', 'revenue'], inplace=True)

# 3. 数据划分 - 划分训练集和测试集
X = movies_metadata[['budget', 'release_year', 'release_month', 'release_day', 'release_weekday']]
y = movies_metadata['revenue']


# 数据集拆分 80% 训练集,20% 测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)train_test_split()将数据按 80% 训练集、20% 测试集 进行拆分,random_state=42确保结果可复现。
3.5 小结
- 特征选择:去除无关特征,保留票房预测相关的字段。
- 特征提取:解析
genres和production_companies,转换为可用于建模的数值变量。 - 特征构造:创建 ROI、电影时长类别等新特征,提高模型的可解释性。
- 数据分割:将数据集拆分为训练集和测试集,为后续建模做好准备。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容