

4.1 选择最适合的数据分析或预测模型
在房价预测问题中,除了线性回归 和随机森林回归,我们还可以考虑其他更复杂和强大的模型。选择最适合的模型要基于数据特征、** 预测准确性和 算法适用性** 来进行的。
经过数据探索,我们可以看到:房价(SalePrice)与多个特征之间可能存在复杂的非线性关系,并且数据集包含多种特征类型,包括数值型、类别型和缺失值等。
基于这些因素,最适合的模型是 梯度提升回归(Gradient Boosting Regression, GBR)。
理由:
- 处理非线性关系:梯度提升回归能处理数据中的非线性关系,通过逐步减少误差来提高预测准确性。
- 鲁棒性强:GBR 可以有效地处理高维数据 和缺失值,在面对复杂数据集时通常表现较好。
- 模型稳定性:与随机森林相比,GBR 更能有效地避免过拟合,并且在大多数预测任务中表现较为优异。
- 强大的性能:GBR 是目前最强的集成学习方法之一,在许多数据科学竞赛中都有很高的排名。
4.2 梯度提升回归算法原理
梯度提升回归(GBR)是基于集成学习 的思想,通过多个弱模型(通常是决策树)的组合来形成一个强预测模型。GBR 采用了Boosting 方法,这意味着模型会逐步构建,在每一轮训练中对之前模型的错误做出改进。它的主要思想是通过加法模型 和梯度下降 的结合,逐步优化每一个预测结果。
公式推理:
假设目标是最小化损失函数 L(y,y^),其中 y 是实际值,y^ 是预测值。
- 初始模型: 初始时我们可以通过简单的常数模型(例如预测所有房价为均值)来进行预测:
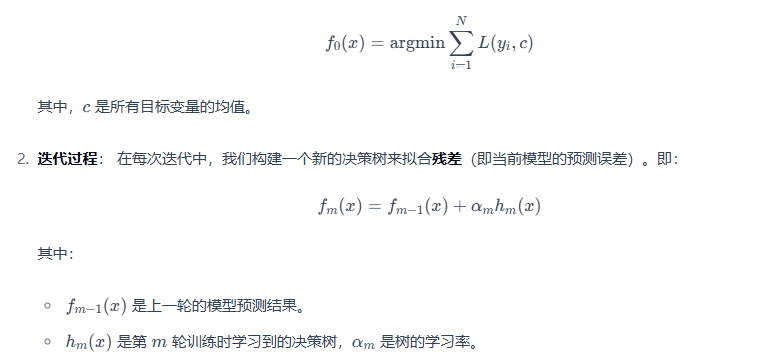
- 损失函数最小化: 通过每轮训练,我们会更新当前模型的参数,最小化损失函数。一般使用 梯度下降法 来优化每轮的学习率 αm 和决策树参数。损失函数的优化过程是基于梯度信息来进行的,通过逐步加法 和梯度下降 组合来构建最终的预测模型。
- 最终模型: 最终模型将会是多个弱模型(决策树)的组合,目标是尽量减少误差,找到一个精确的预测函数。
4.3 GBR 的优点与适用性
优点
- 强大的预测能力:GBR 可以自动处理特征之间的非线性关系,能够很好地拟合复杂的数据。
- 高效性:相对于随机森林,GBR 通过逐步调整每一轮的学习来减少误差,通常能够提供更高的精度。
- 防止过拟合:通过树的深度限制、早停等技术来避免过拟合。
- 适应性强:GBR 对缺失值和异常值较为鲁棒,能适应高维数据,并能自动识别特征的关系。
适用性
- 复杂数据:适合处理复杂、高维数据,特别是在存在非线性关系 的场景下。
- 回归问题:GBR 在回归问题中表现尤为突出,例如房价预测、销售量预测等。
- 集成学习:对于每一轮训练而言,GBR 会重点关注之前模型的错误,使得模型逐步逼近真实目标。
4.4 多维度数据分析
通过对特征进行选择、构建并进行多维度数据分析,GBR 能够充分考虑不同特征与目标之间的关系。在训练过程中,GBR 会逐步构建多棵决策树,并结合每棵树的结果进行加权求和,以最终提高模型的预测性能。
多维度特征分析的效果:
- 非线性特征:GBR 能够捕捉到输入特征与房价之间的复杂关系,而不像线性回归那样假设线性关系。
- 重要性特征:通过训练得到的决策树模型,GBR 可以识别出对房价预测最重要的特征(例如
GrLivArea、OverallQual等),从而进行特征选择。 - 模型优化:GBR 中的学习率 和树的数量 等超参数对模型的表现有很大影响。通过调参,可以使得模型更加精确。
4.5 小结
- 最适合的模型:在本任务中,梯度提升回归(GBR) 是最适合的模型,因为它能有效处理复杂的非线性关系,并且能够通过集成学习不断优化预测结果。
- 原理细化:GBR 通过多轮迭代和梯度下降法,逐步优化预测模型,通过每轮训练的残差调整来减少模型误差,提升预测性能。
- 模型效果:通过训练与调参,GBR 能够提供高精度 的房价预测,适合复杂的房价数据集。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容