

4.1 待选算法模型
在股票市场数据分析中,选择合适的模型是成功的关键。我们面临的任务是回归问题,即预测未来的股票收盘价。股票数据包含历史价格、交易量、技术指标等多个特征,且股市数据通常具有强烈的非线性 特性。
根据这一特点,我们可以考虑以下几种常见的模型:
4.1.1 线性回归
- 简介:线性回归是最简单的一种回归模型,试图通过找到一条最优的直线来拟合数据。它假设特征与目标之间存在线性关系。
- 适用性:适用于特征和目标之间有明显线性关系的数据,但股票市场数据通常存在较强的波动性和非线性趋势,因此,线性回归可能无法准确捕捉这些复杂关系。
- 优点:
- 简单易懂,计算效率高。
- 模型解释性强,易于理解各个特征的影响。
- 缺点:
- 对于非线性关系的数据效果较差,无法处理复杂的股票市场模式。
4.1.2 决策树回归
- 简介:决策树回归通过将数据划分为不同的区间,基于划分后的数据进行回归预测。它是通过一系列的“条件判断”来建立模型,可以捕捉到特征与目标之间的非线性关系。
- 适用性:决策树可以有效处理非线性 的数据关系,能够更好地捕捉股市数据中的复杂模式,适合多维度特征的数据分析。
- 优点:
- 能够处理非线性关系。
- 适用于大规模数据,并且无需特征缩放。
- 结果易于解释。
- 缺点:
- 容易过拟合,尤其是在训练数据量较少时,生成的树可能过于复杂。
4.1.3 随机森林回归
- 简介:随机森林是基于决策树的集成学习方法,通过训练多个决策树并进行平均或投票预测,从而减少单棵决策树的过拟合问题。
- 适用性:对于股票数据这样的高维、非线性问题,随机森林能够较好地捕捉不同特征之间的复杂关系,避免了单棵决策树的过拟合问题。
- 优点:
- 可以处理高维数据,适合具有复杂关系的数据集。
- 可以有效减少过拟合。
- 对缺失值不敏感,并且具有较好的鲁棒性。
- 缺点:
- 模型较为复杂,计算开销较大。
- 模型解释性较差,较难理解各个特征的具体贡献。
4.1.4 XGBoost回归
- 简介:XGBoost(Extreme Gradient Boosting)是一个基于梯度提升树(Gradient Boosting Trees)的高效实现,能够处理大规模数据和高维数据。它通过迭代训练多个弱学习器(通常是决策树),每次训练时通过计算梯度来纠正前一轮的误差。
- 适用性:XGBoost 在处理具有非线性关系、高维特征的数据时非常强大。它能够通过集成多个弱学习器来逐步优化模型,并且具有较强的泛化能力,非常适合处理股票市场这种动态变化的数据。
- 优点:
- 可以处理非线性关系。
- 具有较强的模型拟合能力,尤其适合复杂的数据模式。
- 通过正则化和树的深度控制,可以有效防止过拟合。
- 高效的并行计算,可以在大数据上快速训练。
- 缺点:
- 需要较多的计算资源,训练时间较长。
- 对超参数非常敏感,可能需要花费大量时间进行调参。
4.2 选择 XGBoost 回归模型
选择理由:
- 强大的非线性建模能力:股市数据通常具有复杂的非线性模式,XGBoost 可以通过集成多棵决策树来有效捕捉这些非线性关系,提供准确的预测。
- 鲁棒性:XGBoost 在面对高维数据、缺失值和噪声数据时具有良好的表现,适合股票市场这类波动较大且数据维度较高的情况。
- 防止过拟合:通过正则化技术(L1 和 L2 正则化)和树的深度控制,XGBoost 可以有效防止过拟合,确保模型的泛化能力。
- 并行计算:XGBoost 提供了高效的并行计算能力,能够快速训练大规模数据集,这对于股票市场数据分析尤为重要。
4.3 XGBoost 的原理与适用性
4.3.1 核心原理:梯度提升树
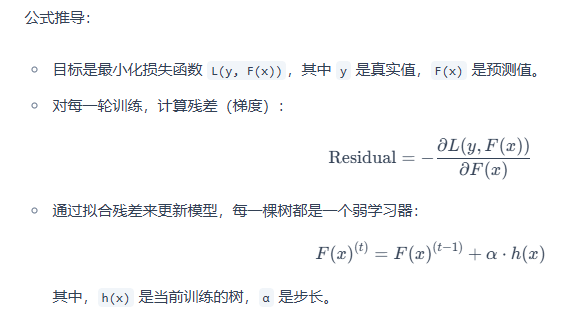
- 梯度提升 是一种集成学习方法,它通过训练多个弱学习器(通常是决策树),每个学习器都试图纠正前一个学习器的错误。XGBoost 是梯度提升的一个高效实现。
- 模型的训练过程:
- 初始化:模型从一个简单的常数值开始,通常是目标值的均值。
- 残差计算:计算当前模型预测值与实际值之间的残差(误差)。
- 训练新树:在每一轮迭代中,XGBoost 会根据残差训练一棵新的决策树,用来减小误差。
- 更新模型:新训练出的树与现有模型组合,通过加权的方式进行更新。
- 迭代优化:这一过程会持续进行多轮,每次都通过最小化残差来逐步改进模型。
4.3.2 适用性
- 非线性关系建模:XGBoost 能够通过多棵树的组合来捕捉非线性关系,适用于复杂的数据集。
- 高维数据处理:XGBoost 具有较强的处理高维特征的能力,可以有效利用大量特征进行建模。
- 大规模数据:XGBoost 的并行计算能力使得它能够处理大规模数据集,尤其适合股票市场这样的动态数据。
4.3.3 正则化与过拟合防止
- XGBoost 通过正则化技术(L1 和 L2 正则化)来避免过拟合。正则化项会对模型复杂度进行惩罚,从而避免模型过于复杂。
- 通过限制树的深度,XGBoost 可以有效控制模型的复杂度,进一步防止过拟合。
4.4 多维度数据分析
使用 XGBoost 时,我们需要考虑多维度特征的影响。在股票数据中,通常会涉及以下几个维度:
- 价格特征:如开盘价、收盘价、最高价、最低价等,反映了股票的市场趋势。
- 交易量特征:如股票的交易量,通常与价格波动性密切相关。
- 技术指标特征:如移动均线、RSI 指标、MACD 等,用于捕捉股票的技术走势。
- 时间特征:如年、月、周等时间维度,可以帮助捕捉季节性或周期性变化。
XGBoost 能够处理这些多维特征,并通过模型内部的特征重要性评分,告诉我们哪些特征对股票价格预测最为关键。
4.5 小结
在股票市场预测中,XGBoost 是一个强大的回归模型,适用于非线性、高维数据的建模。通过集成多个决策树,XGBoost 能够有效捕捉数据中的复杂模式,同时通过正则化和树深度控制避免过拟合。模型的训练过程基于梯度提升算法,逐步优化模型,确保其具有较强的预测能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容