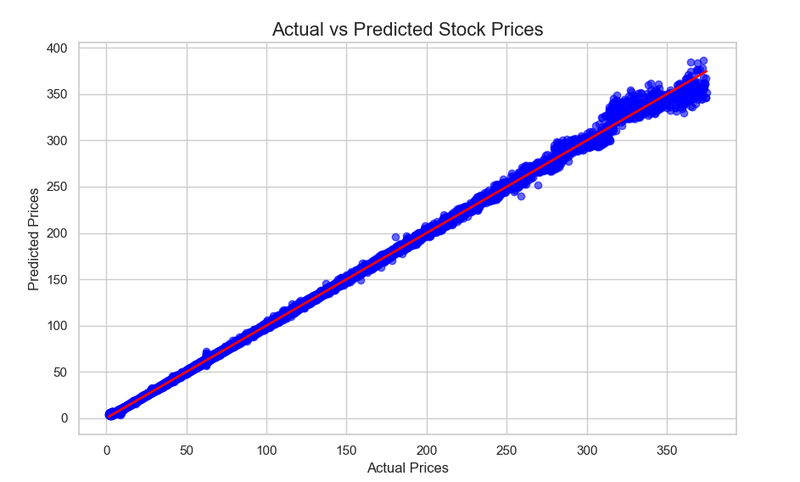


上述结论中,我们选择使用 XGBoost 模型进行股票市场的回归预测。
5.1 模型训练
5.1.1 数据准备与分割
首先,我们将数据分为训练集和测试集。一般来说,数据集的 80% 用于训练,20% 用于测试。
from sklearn.model_selection import train_test_split

# 假设 df 是处理过的股票数据,X 是特征,y 是目标(股价)
X = df.drop(columns=["close", "date", "Name"])  # 特征
y = df["close"]  # 目标变量

# 分割数据集,80%用于训练,20%用于测试
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
5.1.2 构建并训练 XGBoost 模型
在这里,我们将选择一个基本的 XGBoost 模型并进行训练。
import xgboost as xgb

# 初始化XGBoost回归模型
xgb_model = xgb.XGBRegressor(objective='reg:squarederror',
                             colsample_bytree=0.3,
                             learning_rate=0.1,
                             max_depth=5,
                             alpha=10,
                             n_estimators=1000)

# 训练模型
xgb_model.fit(X_train, y_train)
5.2 评估模型性能
评估模型的性能需要选用适当的评价指标。对于回归问题,我们通常使用 均方误差 (MSE)、** 均方根误差 (RMSE)和 R²**(决定系数)来评估模型的准确性。
5.2.1 计算预测误差
通过计算预测值与实际值之间的误差,可以使用如下的评估指标:
- 均方误差 (MSE):衡量预测误差的平均大小,数值越小,模型越好。
- 均方根误差 (RMSE):MSE 的平方根,表示预测误差的标准差,易于理解。
- 决定系数 (R²):衡量模型拟合度,越接近 1,模型表现越好。
from sklearn.metrics import mean_squared_error, r2_score

# 预测测试集
y_pred = xgb_model.predict(X_test)

# 计算 MSE 和 RMSE
mse = mean_squared_error(y_test, y_pred)
rmse = mse**0.5

# 计算 R²
r2 = r2_score(y_test, y_pred)

print(f"Root Mean Squared Error (RMSE): {rmse:.4f}")
print(f"R²: {r2:.4f}")
# Root Mean Squared Error (RMSE): 1.1482
# R²: 0.9995
5.2.2 结果分析
- RMSE:较低的 RMSE 表示预测的股票价格与实际值接近。
- R²:较高的 R² 值(接近 1)表示模型能够较好地拟合数据。
5.3 模型优化与超参数调优
为了提高模型的性能,我们可以进行 超参数调优,例如使用网格搜索(Grid Search) 或随机搜索(Random Search) 方法。这些方法能够自动化地找到最优的模型参数。
5.3.1 网格搜索(Grid Search)
网格搜索通过穷举法搜索所有可能的超参数组合,找出最优的组合。
from sklearn.model_selection import GridSearchCV

# 设置参数范围
param_grid = {
    "learning_rate": [0.01, 0.1, 0.2],
    "max_depth": [3, 5, 7],
    "n_estimators": [100, 500, 1000],
    "subsample": [0.7, 0.8, 1.0]
}

# 创建XGBoost模型
xgb_model = xgb.XGBRegressor(objective='reg:squarederror')

# 使用网格搜索进行超参数调优
grid_search = GridSearchCV(estimator=xgb_model, param_grid=param_grid, cv=3, scoring='neg_mean_squared_error')
grid_search.fit(X_train, y_train)

# 输出最优参数
print("Best Parameters:", grid_search.best_params_)
5.3.2 随机搜索(Random Search)
与网格搜索不同,随机搜索通过随机选择参数组合进行搜索,计算开销较小,适合大范围的参数搜索。
from sklearn.model_selection import RandomizedSearchCV
import numpy as np

# 设置参数范围
param_dist = {
    "learning_rate": [0.01, 0.1, 0.2, 0.3],
    "max_depth": [3, 5, 7, 9],
    "n_estimators": [100, 200, 500, 1000],
    "subsample": [0.7, 0.8, 0.9, 1.0],
    "colsample_bytree": [0.6, 0.8, 1.0]
}

# 创建XGBoost模型
xgb_model = xgb.XGBRegressor(objective='reg:squarederror')

# 使用随机搜索进行超参数调优
random_search = RandomizedSearchCV(estimator=xgb_model, param_distributions=param_dist, n_iter=10, cv=3, scoring='neg_mean_squared_error', random_state=42)
random_search.fit(X_train, y_train)

# 输出最优参数
print("Best Parameters:", random_search.best_params_)
5.4 可视化表现
在模型评估过程中,图表的可视化是非常重要的,它可以帮助我们更直观地理解模型的性能和数据的分布。
5.4.1 预测与实际值的对比图
我们可以通过可视化预测值与实际值的对比,来直观了解模型的拟合效果。可以使用散点图或折线图表示。
import matplotlib.pyplot as plt

# 可视化实际值与预测值的对比
plt.figure(figsize=(10,6))
plt.scatter(y_test, y_pred, color="blue", alpha=0.6)
plt.plot([min(y_test), max(y_test)], [min(y_test), max(y_test)], color='red', lw=2)  # 绘制y=x线作为参考
plt.title("Actual vs Predicted Stock Prices", fontsize=16)
plt.xlabel("Actual Prices", fontsize=12)
plt.ylabel("Predicted Prices", fontsize=12)
plt.show()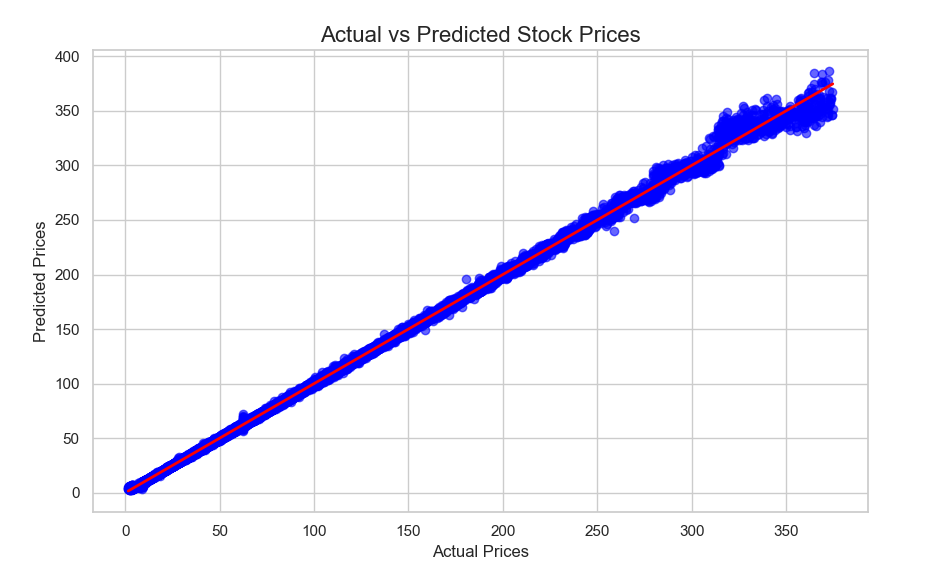
5.5 总结与改进
5.5.1 模型评估
- RMSE 和R² 是评估回归模型性能的关键指标。在模型训练和评估过程中,我们观察到模型的 RMSE 较小,R² 较高,表明模型较好地拟合了数据,能够有效预测股票价格。
5.5.2 超参数调优
- 通过网格搜索和随机搜索,我们能够找到最优的超参数组合,从而提高模型的准确性和稳定性。超参数调优可以显著改善模型的性能。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容