

1. 目标定义和假设设定
1.1 背景介绍
乳腺癌是全球范围内最常见的癌症之一,早期诊断对于提高患者的生存率至关重要。威斯康星乳腺癌数据集(Breast Cancer Wisconsin Dataset)是一份广泛用于机器学习研究的数据集,包含了多个肿瘤特征,以帮助分类良性(B)和恶性(M)肿瘤。
1.2 分析目标
本案例的目标是通过探索性数据分析(EDA)和机器学习模型构建,分析影响乳腺癌分类的关键特征,并评估模型的预测能力。
具体目标包括:
- 理解数据集的基本结构(数据规模、变量类型、缺失值等)。
- 探索特征与诊断结果(良性/恶性)的关系,识别哪些变量对分类任务贡献较大。
- 构建并优化机器学习模型,预测肿瘤类型(良性或恶性)。
- 评估模型性能,确保其在实际应用中的可靠性。
1.3 假设设定
在本次分析中,我们设定以下假设,并在后续步骤进行验证:
- H1:某些特征(如
radius_mean、texture_mean、area_mean)在良性和恶性肿瘤之间存在显著差异。 - H2:通过特征选择和降维,模型性能可以得到优化。
- H3:树模型(如随机森林)可能比传统的线性模型(如逻辑回归)表现更好。
2. 数据探索
在这一部分,我们将对乳腺癌生存率数据集 进行深入的探索,包括:
- 数据基本信息(数据类型、统计信息、数据范围等)
- 数据清洗(处理缺失值、重复值、异常值等)
- 数据可视化(探索数据分布、相关性等)
2.1 加载数据并查看基本信息
# 导入必要的库
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 设置Seaborn风格
sns.set(style="whitegrid", palette="pastel")

# 读取数据
file_path = "./dataset/007/data.csv"
df = pd.read_csv(file_path)

# 显示数据基本信息
print("数据基本信息:")
print(df.info())  # 查看数据类型、缺失值情况等

# 显示数据前5行
print("\n数据预览:")
print(df.head())

# 统计描述
print("\n数值特征统计信息:")
print(df.describe())
2.2 处理数据质量问题
2.2.1 处理无关列
数据中包含 id 和 Unnamed: 32,这些列没有实际意义,应该删除:
# 删除无关列
df.drop(columns=["id", "Unnamed: 32"], inplace=True)
2.2.2 处理缺失值
# 检查缺失值
missing_values = df.isnull().sum()
print("\n缺失值情况:")
print(missing_values[missing_values > 0])  # 只显示有缺失值的列

# 由于"Unnamed: 32"列已删除,数据集实际上没有缺失值
2.2.3 处理重复值
# 检查重复行
print("\n重复数据条数:", df.duplicated().sum())

# 删除重复值(如果有的话)
df.drop_duplicates(inplace=True)
2.2.4 处理异常值
# 计算异常值范围(1.5倍IQR原则)
Q1 = numeric_df.quantile(0.25)
Q3 = numeric_df.quantile(0.75)
IQR = Q3 - Q1

# 设定异常值范围
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

# 统计异常值情况
outliers = ((numeric_df < lower_bound) | (numeric_df > upper_bound)).sum()
print("\n各列异常值数量:")
print(outliers[outliers > 0])如果某些列存在大量异常值,可以采取数据转换(如对数变换)或直接删除异常值:
# 直接删除异常值(仅适用于异常值极端的情况)
df = df[~((numeric_df < lower_bound) | (numeric_df > upper_bound)).any(axis=1)]
2.3 数据可视化
2.3.1 目标变量(肿瘤类型)分布
# 统计良性(B)和恶性(M)样本数量
plt.figure(figsize=(6, 4))
sns.countplot(x=df["diagnosis"], palette=["#FF9999", "#66B2FF"])

# 设置标题和标签
plt.title("Distribution of Diagnosis", fontsize=14)
plt.xlabel("Diagnosis", fontsize=12)
plt.ylabel("Count", fontsize=12)
plt.show()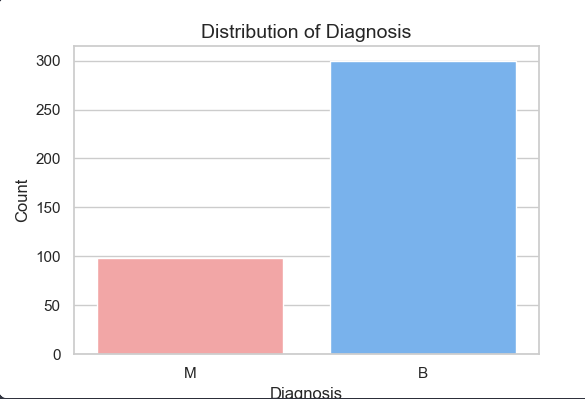
2.3.2 关键特征分布(直方图)
我们选择肿瘤大小相关特征(radius_mean, texture_mean, area_mean)绘制分布图:
# 选取部分关键变量
features = ["radius_mean", "texture_mean", "area_mean"]
plt.figure(figsize=(12, 4))

for i, feature in enumerate(features):
    plt.subplot(1, 3, i+1)
    sns.histplot(df[feature], kde=True, bins=30, color=np.random.rand(3,))
    plt.title(f"Distribution of {feature}")

plt.tight_layout()
plt.show()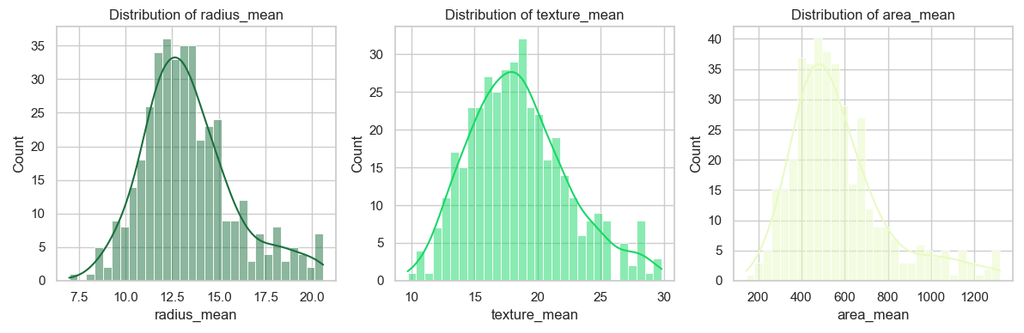
2.3.3 特征相关性分析
# 选择数值型特征进行相关性计算
numeric_df = df.select_dtypes(include=['number'])

# 计算特征相关性矩阵
corr_matrix = numeric_df.corr()

# 绘制热力图
plt.figure(figsize=(12, 10))
sns.heatmap(corr_matrix, cmap="coolwarm", annot=False, linewidths=0.5)

# 设置标题
plt.title("Feature Correlation Heatmap", fontsize=14)
plt.show()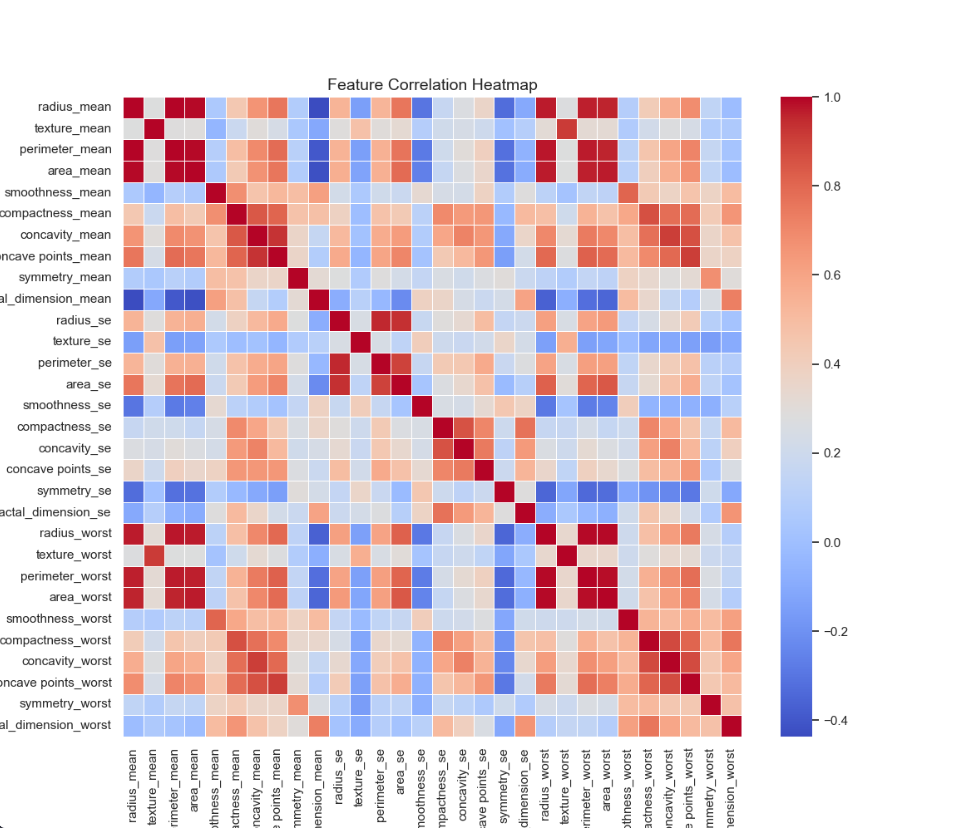
2.4 小结
- 数据无缺失值,但存在部分无意义列(已删除)。
- 目标变量类别不均衡(恶性肿瘤相对较少)。
- 部分特征存在异常值(已处理)。
- 某些特征高度相关,可能可以使用特征选择或降维方法优化模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容