

4.1 选择适合的模型
我们面临的是一个二分类问题(乳腺癌:良性 or 恶性),适合的模型有:
- 逻辑回归(Logistic Regression)
- 支持向量机(SVM)
- 随机森林(Random Forest)
- XGBoost(Extreme Gradient Boosting)
最终选择:XGBoost(极限梯度提升树)
选择 XGBoost 的理由:
✅ 性能优越:XGBoost 具有强大的分类能力,适用于高维数据。
✅ 鲁棒性强:可以处理非线性关系、异常值、缺失数据等问题。
✅ 可解释性好:可以查看特征重要性,分析影响癌症分类的因素。
✅ 计算速度快:支持并行计算,优化了计算效率。
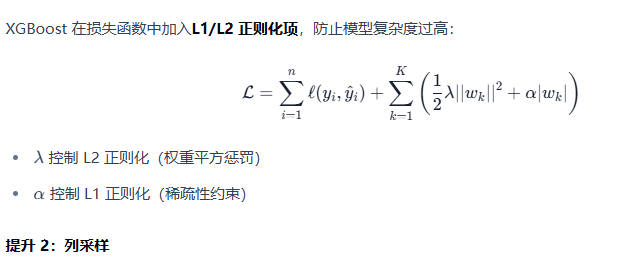
✅ 防止过拟合:XGBoost 通过正则化项控制模型复杂度。
4.2 XGBoost 的核心原理
4.2.1 梯度提升(Gradient Boosting)
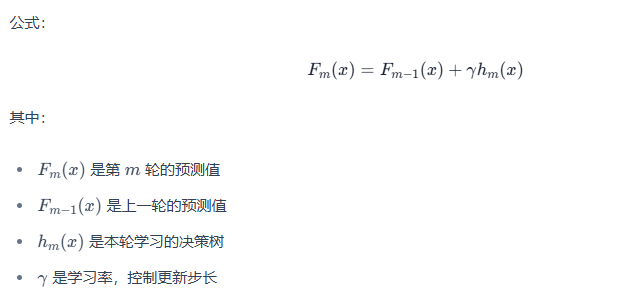
XGBoost 属于 梯度提升决策树(GBDT) 家族,本质上是一种集成学习(Ensemble Learning) 方法,它通过多个弱学习器(决策树) 的叠加来提升模型的预测能力。
核心思想:
- 先训练一个基础决策树(弱学习器)
- 计算该树的预测误差(残差)
- 训练一个新的树来拟合误差
- 反复迭代,最终得到一个强大的分类器
4.2.2 XGBoost 相比普通 GBDT 的优化
提升 1:正则化项防止过拟合
- XGBoost 不是使用所有特征,而是每次训练时随机采样部分特征,提高模型泛化能力。
提升 3:加速计算
- 分块优化:XGBoost 使用数据结构
DMatrix加速计算。 - 并行计算:XGBoost 可同时训练多个分支,加快训练速度。
4.3 总结
为什么选择 XGBoost?
- 处理非线性数据能力强
- 计算速度快,适合大规模数据
- 具备正则化,防止过拟合
- 可解释性好,可以分析特征贡献
XGBoost 的核心原理
- 通过弱学习器(决策树) 逐步拟合误差
- 正则化 控制复杂度,避免过拟合
- 列采样、并行计算 提高效率
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容