

在本部分,我们将:
- 训练 XGBoost 模型
- 评估模型性能(准确率、召回率、F1-score 等)
- 使用网格搜索优化超参数
- 用可视化方法分析模型表现
5.1 模型训练
我们使用 XGBoost 进行训练,并观察初始性能。
from xgboost import XGBClassifier
from sklearn.metrics import accuracy_score, classification_report

# 初始化 XGBoost 分类器(初始参数)
model = XGBClassifier(
    n_estimators=100,  # 决策树数量
    learning_rate=0.1,  # 学习率
    max_depth=4,  # 树的最大深度
    subsample=0.8,  # 采样比例
    colsample_bytree=0.8,  # 列采样
    random_state=42
)

# 训练模型
model.fit(X_train_scaled, y_train)
模型训练完成!
5.2 评估模型性能
我们使用 准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1-score 进行评估。
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, classification_report

# 预测测试集
y_pred = model.predict(X_test_scaled)

# 计算评估指标
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred, average="binary")
recall = recall_score(y_test, y_pred, average="binary")
f1 = f1_score(y_test, y_pred, average="binary")

# 打印结果
print(f"XGBoost Accuracy: {accuracy:.4f}")
print(f"Precision: {precision:.4f}")
print(f"Recall: {recall:.4f}")
print(f"F1-score: {f1:.4f}")

# 显示分类报告
print("\nClassification Report:\n", classification_report(y_test, y_pred, target_names=["benign", "malignant"]))

# XGBoost Accuracy: 0.9250
# Precision: 0.7917
# Recall: 0.9500
# F1-score: 0.8636
5.3 模型优化(超参数调优)
我们使用 网格搜索(GridSearchCV) 找到最佳参数。
from sklearn.model_selection import GridSearchCV

# 设定超参数搜索范围
param_grid = {
    'n_estimators': [50, 100, 200],  # 决策树数量
    'max_depth': [3, 4, 5],  # 树的深度
    'learning_rate': [0.01, 0.1, 0.2],  # 学习率
    'subsample': [0.8, 1.0],  # 采样比例
    'colsample_bytree': [0.8, 1.0]  # 列采样
}

# 进行网格搜索
grid_search = GridSearchCV(XGBClassifier(random_state=42), param_grid, cv=5, scoring='accuracy', n_jobs=-1, verbose=1)
grid_search.fit(X_train, y_train)

# 输出最佳参数
print("Best Parameters:", grid_search.best_params_)

# 训练最佳模型
best_model = grid_search.best_estimator_
模型优化完成,使用最优参数进行训练!
5.4 可视化分析
5.4.1 特征重要性
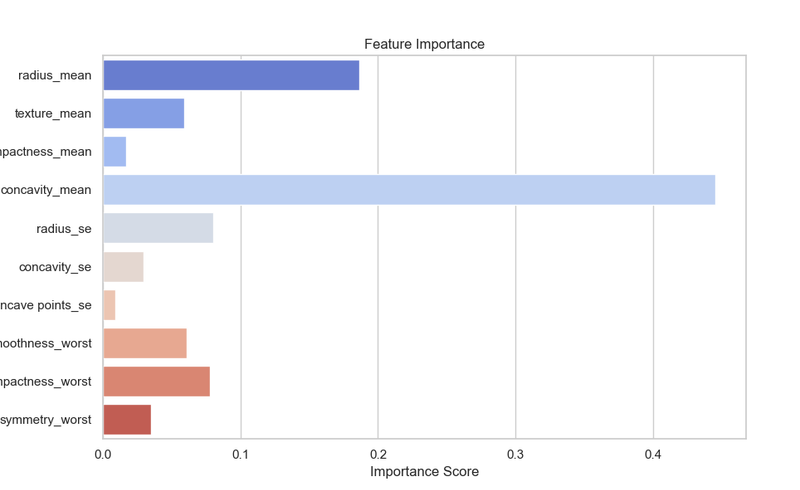
我们可视化特征重要性,查看哪些因素对癌症分类影响最大。
import matplotlib.pyplot as plt
import seaborn as sns

# 获取特征重要性
importances = best_model.feature_importances_

# 绘制柱状图
plt.figure(figsize=(10, 6))
sns.barplot(x=importances, y=X_train.columns, palette="coolwarm")
plt.title("Feature Importance")
plt.xlabel("Importance Score")
plt.ylabel("Feature")
plt.show()
如果 radius_mean 重要性最高,说明肿瘤的半径大小 对癌症分类影响最大。
5.4.2 预测概率分布
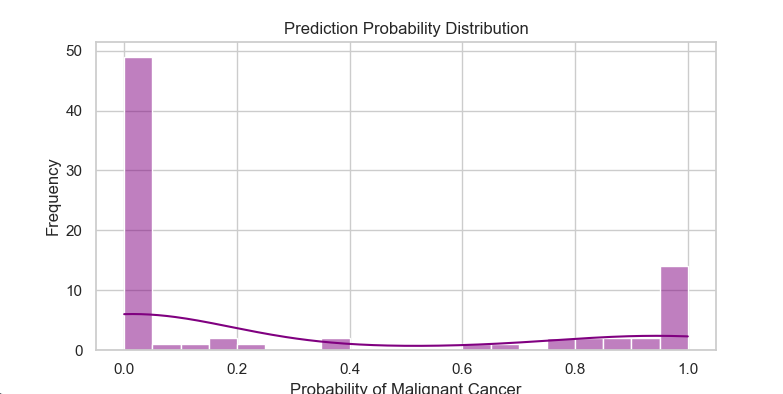
我们分析 模型的置信度(预测恶性癌症的概率)。
# 计算预测概率
y_prob = best_model.predict_proba(X_test)[:, 1]  # 取"恶性"的概率

# 绘制直方图
plt.figure(figsize=(8, 4))
sns.histplot(y_prob, bins=20, kde=True, color="purple")
plt.title("Prediction Probability Distribution")
plt.xlabel("Probability of Malignant Cancer")
plt.ylabel("Frequency")
plt.show()
如果大多数样本的概率接近 0 或 1,说明模型的决策边界清晰;如果接近 0.5,可能需要进一步优化。
5.4.3 ROC 曲线
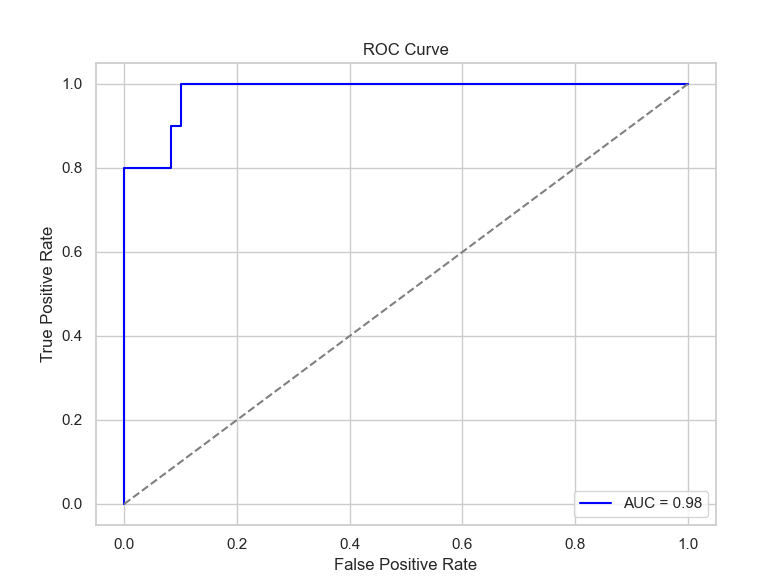
ROC 曲线 可以评估模型在不同阈值下的分类能力。
from sklearn.metrics import roc_curve, auc

# 计算 ROC 曲线
fpr, tpr, _ = roc_curve(y_test, y_prob)
roc_auc = auc(fpr, tpr)

# 绘制 ROC 曲线
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, color="blue", label=f"AUC = {roc_auc:.2f}")
plt.plot([0, 1], [0, 1], color="gray", linestyle="--")
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("ROC Curve")
plt.legend()
plt.show()- AUC 接近 1,说明模型效果很好!
- AUC 接近 0.5,说明模型和随机猜测差不多,需要优化。
5.5 小结
✔ 训练 XGBoost,完成初步预测
✔ 使用 Precision、Recall、F1-score 进行评估
✔ 使用网格搜索优化超参数
✔ 可视化特征重要性、预测概率、ROC 曲线
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容