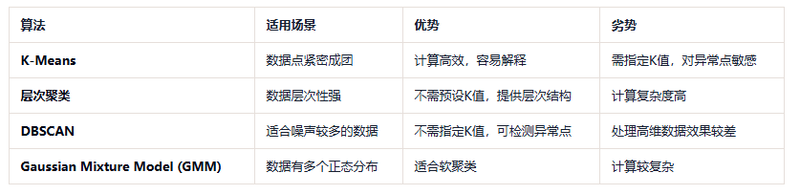


在这一部分,我们将选择合适的聚类算法,并详细介绍其原理、适用性等等。
4.1 模型选择
4.1.1 为什么使用聚类?
本项目的目标是对客户进行分群,而不是预测某个具体值(如收入或消费评分)。这属于无监督学习 问题,因此需要选择一种聚类(Clustering) 算法。
4.1.2 可能的聚类方法
我们可以选择的聚类方法包括:
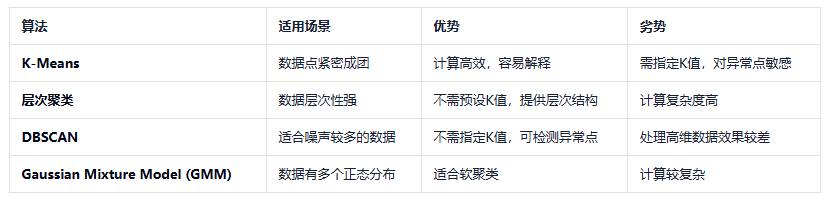
由于我们的数据相对规则,且客户消费模式通常可以用“高消费、低消费、中等消费”等类别表示,因此我们选择K-Means 聚类,同时进行GMM 聚类 对比。
4.2 K-Means 聚类原理
4.2.1 核心思想
K-Means 通过迭代优化数据点到最近聚类中心的距离,最终形成K 个簇。核心思想如下:
- 随机初始化 K 个聚类中心(centroids)。
- 将每个数据点分配给最近的聚类中心,形成 K 个簇。
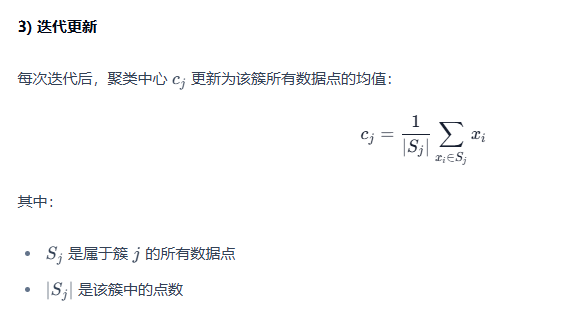
- 重新计算每个簇的中心,即所有点的均值。
- 重复步骤 2 和 3,直到聚类中心不再变化或达到最大迭代次数。
4.2.2 公式推导
1) 距离计算
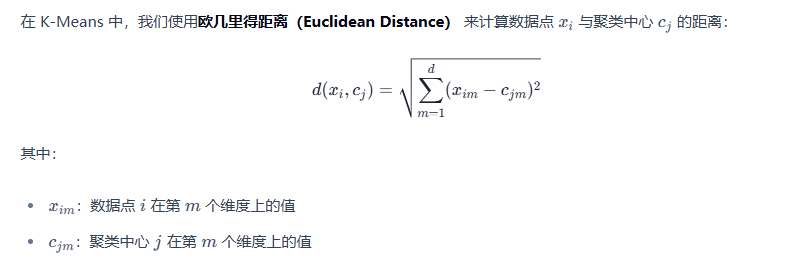
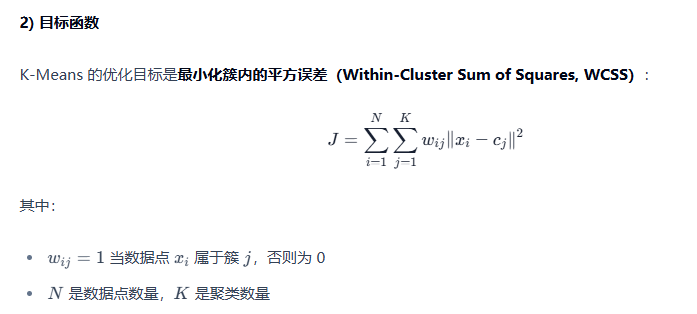
4.3 高斯混合模型 (GMM) 作为对比
K-Means 假设所有簇是球形的,而 GMM(Gaussian Mixture Model) 允许簇有不同的形状,并使用概率分布进行分类。
4.3.1 GMM 聚类原理
GMM 假设数据来自多个高斯分布,并使用期望最大化(EM) 算法进行优化:
- 初始化参数(每个簇的均值、协方差矩阵、混合系数)。
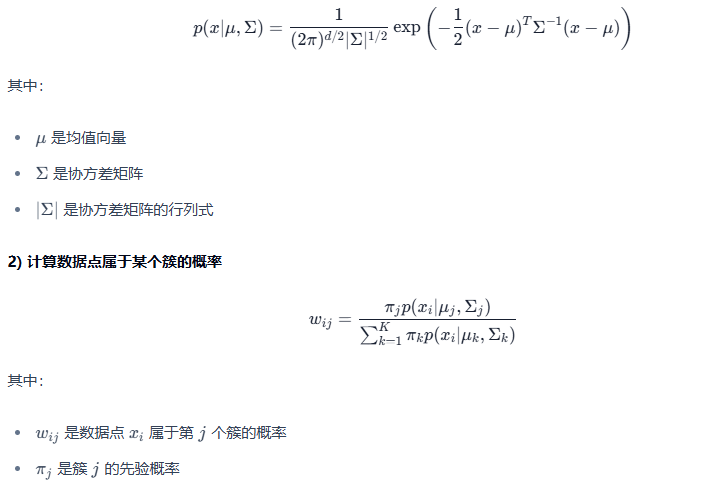
- E 步骤(Expectation):计算每个数据点属于每个簇的概率(即软分配)。
- M 步骤(Maximization):更新均值、协方差和混合系数,使得数据点的概率最大化。
- 重复 E-M 过程,直到参数收敛。
4.3.2 公式推导
1) 高斯分布公式
对于一个 d 维特征向量 x,高斯分布定义如下:
4.4 小结
- K-Means 是一种计算高效的聚类方法,适用于数据分布较均匀的情况。
- GMM 允许更复杂的簇形状,并提供软分配(概率分布)。
- 通过肘部法则确定 K 值,能够避免过拟合或欠拟合。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容