

在这一部分,我们将通过 Python 实现 K-Means 和GMM 模型的训练与评估,并优化模型参数,最后通过可视化展示模型效果。
5.1 模型训练
5.1.1 训练 K-Means 模型
使用之前的 K 值(假设通过肘部法则选择 K=5),我们将对数据进行训练并得到每个数据点的类别标签。
from sklearn.cluster import KMeans

# 训练 K-Means 模型
optimal_k = 5  # 通过肘部法则确定的最佳 K 值
kmeans = KMeans(n_clusters=optimal_k, random_state=42)
df_cluster_scaled['KMeans_Cluster'] = kmeans.fit_predict(df_cluster_scaled)

# 查看聚类结果
print(df_cluster_scaled[['Age', 'Annual Income (k$)', 'Spending Score (1-100)', 'KMeans_Cluster']].head())
5.1.2 训练 GMM 模型
使用 Gaussian Mixture Model (GMM) 进行训练,并得到每个数据点属于各个簇的概率。
from sklearn.mixture import GaussianMixture

# 训练 GMM 模型
gmm = GaussianMixture(n_components=optimal_k, random_state=42)
df_cluster_scaled['GMM_Cluster'] = gmm.fit_predict(df_cluster_scaled)

# 查看聚类结果
print(df_cluster_scaled[['Age', 'Annual Income (k$)', 'Spending Score (1-100)', 'GMM_Cluster']].head())
5.2 模型评估
由于聚类是无监督学习,我们无法使用传统的分类评价指标(如准确率、精确率、召回率)。
不过,我们可以使用以下方法评估聚类结果:
- 轮廓系数(Silhouette Score):评估聚类的紧密性和分离度。值越接近1表示聚类效果越好。
- 聚类内平方误差(WCSS, Within-Cluster Sum of Squares):聚类内的方差,越小表示聚类效果越好。
5.2.1 计算轮廓系数
from sklearn.metrics import silhouette_score

# 计算 K-Means 和 GMM 的轮廓系数
kmeans_score = silhouette_score(df_cluster_scaled[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']], df_cluster_scaled['KMeans_Cluster'])
gmm_score = silhouette_score(df_cluster_scaled[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']], df_cluster_scaled['GMM_Cluster'])

print(f"K-Means Silhouette Score: {kmeans_score:.4f}")
print(f"GMM Silhouette Score: {gmm_score:.4f}")
5.2.2 计算 WCSS
# 计算 K-Means 的 WCSS(聚类内平方误差)
wcss = kmeans.inertia_
print(f"K-Means WCSS: {wcss:.4f}")
5.2.3 模型对比
通过比较轮廓系数和 WCSS,可以评估哪种方法在该数据集上效果更好。一般来说,轮廓系数越接近 1,聚类效果越好,WCSS 越小,聚类效果越好。
5.3 模型优化:超参数调优
为了优化 K-Means 和 GMM 模型的性能,我们可以使用 网格搜索(GridSearchCV) 或随机搜索(RandomizedSearchCV) 来优化模型参数。
5.3.1 K-Means 的优化
我们可以通过调节 K-Means 中的 n_clusters(K 值)来进一步优化模型。
from sklearn.model_selection import GridSearchCV
from sklearn.cluster import KMeans

# 定义参数范围
param_grid = {
    'n_clusters': [3, 4, 5, 6, 7, 8, 9, 10]  # K 值范围
}

# 使用 GridSearchCV 进行超参数调优
grid_search = GridSearchCV(estimator=KMeans(random_state=42), param_grid=param_grid, cv=3, scoring='neg_mean_squared_error')
grid_search.fit(df_cluster_scaled[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']])

# 输出最佳参数
print(f"Best K for K-Means: {grid_search.best_params_['n_clusters']}")
# Best K for K-Means: 3
5.3.2 GMM 的优化
GMM 模型的优化通常包括 n_components(簇的数量),covariance_type(协方差矩阵的类型),以及max_iter(最大迭代次数)。
from sklearn.model_selection import GridSearchCV
from sklearn.mixture import GaussianMixture

# 定义参数范围
param_grid_gmm = {
    'n_components': [3, 4, 5, 6],  # 簇数
    'covariance_type': ['full', 'tied', 'diag', 'spherical'],  # 协方差类型
    'max_iter': [100, 200]  # 最大迭代次数
}

# 使用 GridSearchCV 进行超参数调优
grid_search_gmm = GridSearchCV(estimator=GaussianMixture(), param_grid=param_grid_gmm, cv=3)
grid_search_gmm.fit(df_cluster_scaled[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']])

# 输出最佳参数
print(f"Best GMM Parameters: {grid_search_gmm.best_params_}")
# Best GMM Parameters: {'covariance_type': 'spherical', 'max_iter': 200, 'n_components': 3}
5.4 可视化展示
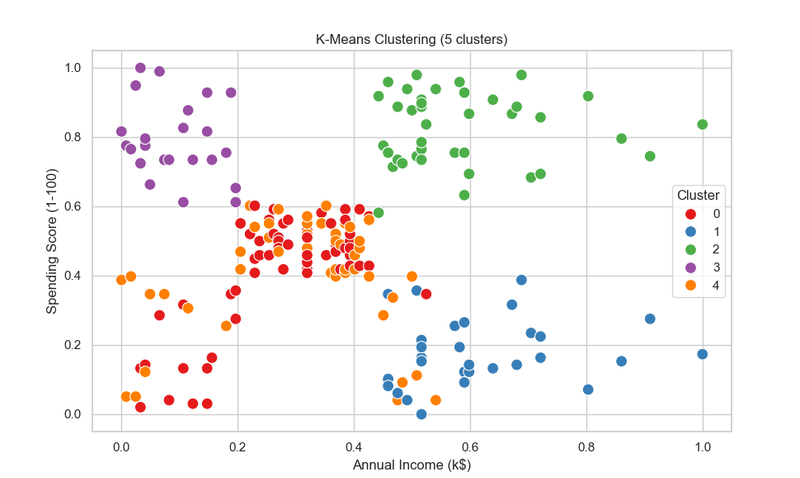
为了直观地展示聚类效果,我们可以绘制 散点图,通过颜色区分不同的簇。
5.4.1 K-Means 聚类结果可视化
# K-Means 聚类结果的可视化
plt.figure(figsize=(10, 6))
sns.scatterplot(x='Annual Income (k$)', y='Spending Score (1-100)', hue='KMeans_Cluster', data=df_cluster_scaled, palette='Set1', s=100, marker='o')
plt.title('K-Means Clustering (5 clusters)')
plt.xlabel('Annual Income (k$)')
plt.ylabel('Spending Score (1-100)')
plt.legend(title='Cluster')
plt.show()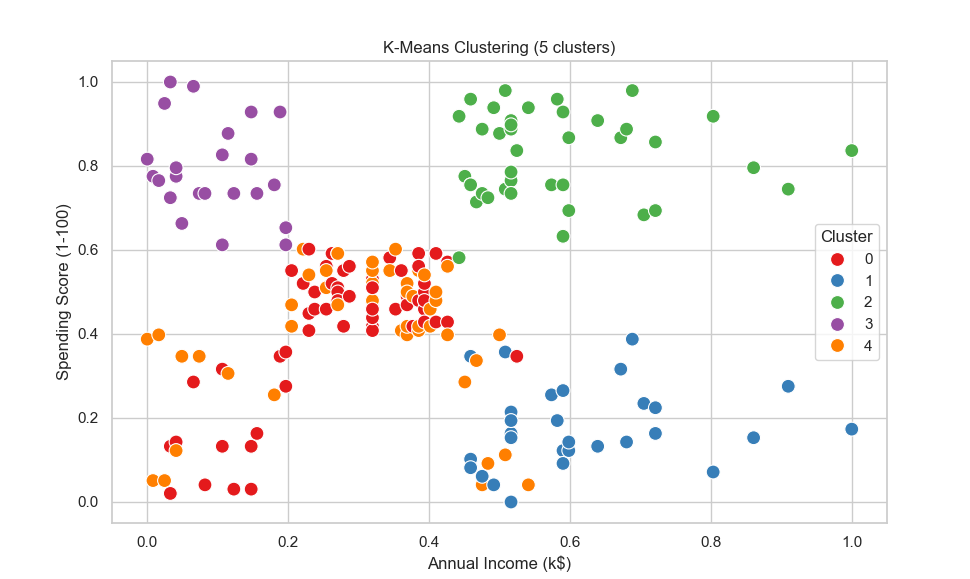
5.4.2 GMM 聚类结果可视化
# GMM 聚类结果的可视化
plt.figure(figsize=(10, 6))
sns.scatterplot(x='Annual Income (k$)', y='Spending Score (1-100)', hue='GMM_Cluster', data=df_cluster_scaled, palette='Set2', s=100, marker='o')
plt.title('GMM Clustering (5 components)')
plt.xlabel('Annual Income (k$)')
plt.ylabel('Spending Score (1-100)')
plt.legend(title='Cluster')
plt.show()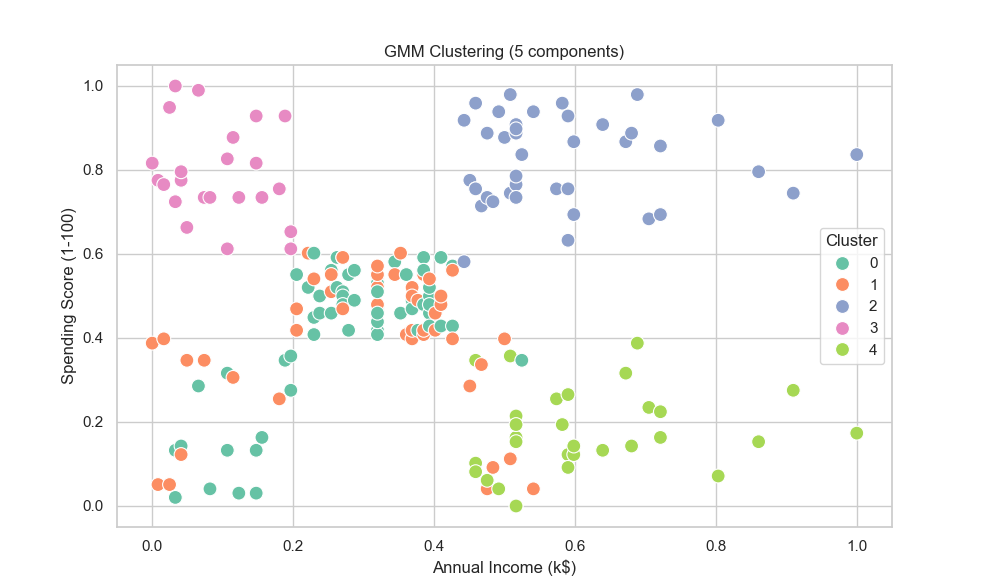
5.4.3 聚类结果对比
我们可以将 K-Means 和GMM 聚类结果进行对比,帮助分析不同算法的效果差异。
# 对比 K-Means 和 GMM 的聚类效果
fig, axes = plt.subplots(1, 2, figsize=(18, 6))

# K-Means 可视化
sns.scatterplot(x='Annual Income (k$)', y='Spending Score (1-100)', hue='KMeans_Cluster', data=df_cluster_scaled, palette='Set1', s=100, marker='o', ax=axes[0])
axes[0].set_title('K-Means Clustering')
axes[0].set_xlabel('Annual Income (k$)')
axes[0].set_ylabel('Spending Score (1-100)')

# GMM 可视化
sns.scatterplot(x='Annual Income (k$)', y='Spending Score (1-100)', hue='GMM_Cluster', data=df_cluster_scaled, palette='Set2', s=100, marker='o', ax=axes[1])
axes[1].set_title('GMM Clustering')
axes[1].set_xlabel('Annual Income (k$)')
axes[1].set_ylabel('Spending Score (1-100)')

plt.show()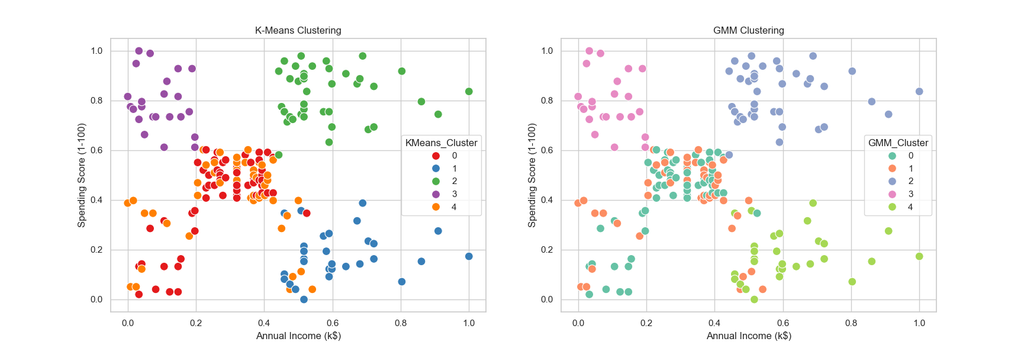
5.5 小结
- 模型评估:
- 通过轮廓系数和 WCSS,我们评估了 K-Means 和 GMM 的聚类效果。
- 通过网格搜索,我们进一步优化了模型参数,选择了最佳 K 值和 GMM 的参数。
- 可视化结果:
- K-Means 和 GMM 聚类结果通过散点图进行了展示,便于直观对比不同聚类方法的效果。
- 超参数优化:
- 使用了网格搜索优化 K-Means 和 GMM 模型的超参数,提高了模型的准确性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容