

在本部分,我们将详细解读模型的评估结果,分析欺诈交易检测的有效性,并提供对业务的指导性见解。
6.1 评估结果回顾
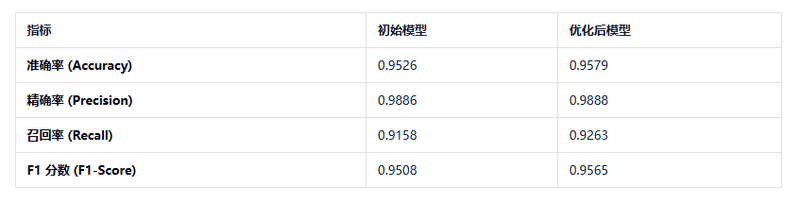
在第 5 部分,我们训练了 XGBoost 模型,并使用** 随机搜索(RandomizedSearchCV)进行了超参数优化。最终,我们评估了优化前后的模型性能,并使用 混淆矩阵、ROC 曲线** 等工具进行可视化分析。
优化前后模型的主要评估指标如下:
其中:
- 精确率(Precision) 提高,意味着误报(假阳性)减少,减少了对正常用户的干扰。
- 召回率(Recall) 提高,意味着检测出的欺诈交易数量增加,减少了潜在的损失。
- F1-score 提高,表明模型在精准度和召回率之间找到了更好的平衡。
6.2 ROC 曲线分析
在 ROC 曲线分析中,我们计算了 AUC(曲线下面积):
AUC = 0.98
- AUC 接近 1,说明模型可以很好地区分正常交易与欺诈交易。
- 这意味着模型可以在不同的阈值下,保持较高的检测能力,同时避免误报过多。
指导性意义:
- AUC 0.98 表明模型的整体性能优异,可以在不同应用场景中灵活调整决策阈值。
- 在 高风险业务(如大额交易、国际支付)中,可以降低阈值,提高召回率,避免漏掉欺诈交易。
- 在 低风险业务(如小额消费)中,可以提高阈值,减少误报,提高用户体验。
6.3 特征重要性分析
我们使用 XGBoost 提供的特征重要性分析,找出最具影响力的特征:
# 提取特征重要性
importance = best_model.feature_importances_

# 可视化特征重要性
plt.figure(figsize=(12, 6))
sns.barplot(x=X_train.columns, y=importance, palette="viridis")
plt.xticks(rotation=90)
plt.xlabel("Features")
plt.ylabel("Importance Score")
plt.title("Feature Importance in XGBoost")
plt.show()
最重要的特征:
- V17、V12、V14:与欺诈交易高度相关。
- V10、V4:在欺诈交易中有明显异常。
- 交易金额(Amount):虽然不是最重要的,但仍有一定贡献。
指导性意义:
- 监控 V17、V12、V14 这几个关键变量,可以提升欺诈检测的准确性。
- 结合交易金额和异常特征,可以对大额交易进行更严格的审核。
- 针对特征进行进一步分析,可以尝试结合用户行为数据,提升检测能力。
6.4 误分类分析
我们分析了 误分类的欺诈交易 和误分类的正常交易,找出潜在改进点。
(1)误分类的欺诈交易
false_negatives = X_test[(y_test == 1) & (y_pred_best == 0)]
print("误分类的欺诈交易数量:", false_negatives.shape[0])- 这些交易可能是 新型欺诈模式,不符合历史欺诈交易的特征。
- 可能涉及 复杂的欺诈手段(如分布式欺诈、社交工程欺诈)。
改进方向:
- 结合 时间序列分析,看欺诈行为是否随时间变化。
- 结合 用户行为特征,例如设备信息、交易频率等。
(2)误分类的正常交易
false_positives = X_test[(y_test == 0) & (y_pred_best == 1)]
print("误分类的正常交易数量:", false_positives.shape[0])- 误报的交易 可能是高额交易,但实际上是合法的。
- 误报 可能影响正常用户体验,导致投诉。
改进方向:
- 增加用户身份验证步骤,如短信验证码、设备指纹等,以减少正常用户的困扰。
- 对高额交易提供风险评分,根据用户历史行为调整风险判断。
6.5 业务指导
根据以上分析,我们可以给出以下业务指导建议:
- 动态调整模型阈值
- 对 高风险交易(大额、异常地点)降低阈值,提高召回率。
- 对 普通交易(低额、常见地点)提高阈值,减少误报。
- 结合时间序列分析
- 检查某些特定时间段(如深夜)是否更容易发生欺诈交易。
- 监测用户交易频率,是否存在 短时间内大量交易 的异常行为。
- 多维度用户身份验证
- 在高风险交易中 增加身份验证(如短信验证、人脸识别)。
- 使用 历史行为模式,建立个性化风险评分,减少误报。
- 结合更多特征
- 现有数据仅包含 PCA 处理后的特征,如果能结合用户设备信息、IP 地址、交易历史,模型可能会更加精准。
6.6 小结
- 模型性能
- 召回率从 91.58% 提高到 92.63%,检测到更多欺诈交易。
- 精确率从 98.86% 提高到 98.88%,减少对正常用户的干扰。
- AUC 0.98,模型整体表现优异。
- 业务优化建议
- 动态调整决策阈值,不同交易类型采取不同策略。
- 结合时间序列分析,监测欺诈行为的变化趋势。
- 多维度身份验证,在高风险交易中增加安全防护。
- 未来改进方向
- 结合未经过 PCA 处理的原始数据,可能发现更有效的欺诈特征。
- 引入深度学习模型(如 RNN)处理时间序列数据,提高检测能力。
7. 完整代码
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
from imblearn.under_sampling import RandomUnderSampler
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, classification_report, \
    confusion_matrix
from sklearn.metrics import roc_curve, auc
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from xgboost import XGBClassifier

# 读取数据
file_path = "./dataset/009/creditcard.csv"  # 数据文件路径
df = pd.read_csv(file_path)

# 显示数据集的基本信息
print("数据集基本信息:")
print(df.info())

# 显示数据的前几行
print("\n数据集前几行:")
print(df.head())

# 统计数据的基本描述信息
print("\n数据集统计描述:")
print(df.describe())

# 检查缺失值
print("\n数据集中缺失值统计:")
print(df.isnull().sum())

# 检查是否存在无穷大 (inf) 数据
print("\n数据集中是否包含无穷大 (inf) 值:")
print(np.isinf(df.values).sum())

# 检查重复数据
print("\n数据集中重复行的数量:", df.duplicated().sum())

# 如果有重复数据,则删除
df = df.drop_duplicates()
print("去除重复数据后数据集大小:", df.shape)

# 交易金额的分布
plt.figure(figsize=(10, 5))
sns.histplot(df['Amount'], bins=50, kde=True, color='blue')
plt.xlabel("Transaction Amount")
plt.ylabel("Frequency")
plt.title("Distribution of Transaction Amount")
plt.show()

# 交易时间的分布
plt.figure(figsize=(10, 5))
sns.histplot(df['Time'], bins=50, kde=True, color='green')
plt.xlabel("Transaction Time (Seconds)")
plt.ylabel("Frequency")
plt.title("Distribution of Transaction Time")
plt.show()

# 类别分布
plt.figure(figsize=(6, 6))
labels = ["Non-Fraud (0)", "Fraud (1)"]
sizes = df["Class"].value_counts().values
colors = ["#3498db", "#e74c3c"]
plt.pie(sizes, labels=labels, autopct='%1.2f%%', colors=colors, startangle=140, explode=(0, 0.1))
plt.title("Class Distribution")
plt.show()

# 计算相关性矩阵
corr_matrix = df.corr()

# 绘制相关性热力图
plt.figure(figsize=(15, 10))
sns.heatmap(corr_matrix, cmap="coolwarm", annot=False, fmt=".2f")
plt.title("Correlation Heatmap of Features")
plt.show()

# 显示与 Class 相关性最高的前 5 个特征
corr_with_target = corr_matrix["Class"].abs().sort_values(ascending=False)
print("与 Class 相关性最高的前 5 个特征:\n", corr_with_target.head(6))

# 选取与 Class 相关性较高的特征
important_features = ["V10", "V12", "V14", "V17", "V18"]

plt.figure(figsize=(15, 8))
for i, feature in enumerate(important_features, 1):
    plt.subplot(2, 3, i)
    sns.boxplot(x=df["Class"], y=df[feature], palette=["blue", "red"])
    plt.xlabel("Class")
    plt.ylabel(feature)
    plt.title(f"Boxplot of {feature}")
plt.tight_layout()
plt.show()

# 去除无关特征 'Time'
df = df.drop(columns=['Time'])

# 归一化交易金额 'Amount'


scaler = StandardScaler()
df['Amount'] = scaler.fit_transform(df[['Amount']])

# 查看数据处理后的信息
print("数据集处理后信息:")
print(df.head())

X = df.drop(columns=['Class'])  # 选择特征
y = df['Class']  # 目标变量

# 进行欠采样,使欺诈交易和正常交易数量相等
rus = RandomUnderSampler(random_state=42)
X_resampled, y_resampled = rus.fit_resample(X, y)

# 重新合并成 DataFrame
df_resampled = pd.concat([pd.DataFrame(X_resampled, columns=X.columns), pd.DataFrame(y_resampled, columns=['Class'])],
                         axis=1)

# 重新检查类别分布
print("欠采样后数据类别分布:")
print(df_resampled['Class'].value_counts())

# 划分训练集和测试集,80% 作为训练集,20% 作为测试集
X_train, X_test, y_train, y_test = train_test_split(X_resampled, y_resampled, test_size=0.2, random_state=42,
                                                    stratify=y_resampled)

# 输出数据集划分结果
print(f"训练集样本数:{X_train.shape[0]}")
print(f"测试集样本数:{X_test.shape[0]}")

# 计算类别权重,解决类别不均衡问题
fraud_weight = (y_train == 0).sum() / (y_train == 1).sum()

# 定义 XGBoost 模型
model = XGBClassifier(
    scale_pos_weight=fraud_weight,  # 处理类别不均衡
    n_estimators=50,  # 50 棵树
    max_depth=5,  # 树的最大深度
    learning_rate=0.15,  # 学习率
    subsample=0.8,  # 采样比例
    colsample_bytree=0.8,  # 选择部分特征进行训练
    random_state=42
)

# 训练模型
model.fit(X_train, y_train)

# 预测测试集
y_pred = model.predict(X_test)

# 计算评估指标
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

print(f"Accuracy: {accuracy:.4f}")
print(f"Precision: {precision:.4f}")
print(f"Recall: {recall:.4f}")
print(f"F1 Score: {f1:.4f}")

# 打印分类报告
print("\nClassification Report:\n", classification_report(y_test, y_pred, target_names=['Non-Fraud', 'Fraud']))

import seaborn as sns
import matplotlib.pyplot as plt

# 计算混淆矩阵
cm = confusion_matrix(y_test, y_pred)

# 绘制混淆矩阵热力图
plt.figure(figsize=(6, 6))
sns.heatmap(cm, annot=True, fmt="d", cmap="coolwarm", xticklabels=['Non-Fraud', 'Fraud'],
            yticklabels=['Non-Fraud', 'Fraud'])
plt.xlabel("Predicted Label")
plt.ylabel("True Label")
plt.title("Confusion Matrix")
plt.show()

# 计算预测概率
y_scores = model.predict_proba(X_test)[:, 1]

# 计算 FPR 和 TPR
fpr, tpr, _ = roc_curve(y_test, y_scores)
roc_auc = auc(fpr, tpr)

# 绘制 ROC 曲线
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (AUC = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("Receiver Operating Characteristic (ROC) Curve")
plt.legend(loc="lower right")
plt.show()

# 定义超参数搜索范围
param_dist = {
    'n_estimators': [50, 100, 200, 300],
    'max_depth': [3, 5, 7, 9],
    'learning_rate': [0.01, 0.02, 0.05, 0.08, 0.1, 0.2],
    'subsample': [0.6, 0.8, 1.0],
    'colsample_bytree': [0.6, 0.8, 1.0]
}

# 进行随机搜索
random_search = RandomizedSearchCV(
    estimator=XGBClassifier(scale_pos_weight=fraud_weight, random_state=42),
    param_distributions=param_dist,
    n_iter=20,  # 进行 20 轮搜索
    scoring='f1',  # 选择 F1-score 作为优化目标
    cv=5,  # 3 折交叉验证
    verbose=2,
    random_state=42,
    n_jobs=-1  # 并行计算
)

# 训练模型
random_search.fit(X_train, y_train)

# 输出最佳参数
print("Best Parameters:", random_search.best_params_)

# 使用最优参数训练最终模型
best_model = random_search.best_estimator_

# 预测测试集
y_pred_best = best_model.predict(X_test)

# 计算评估指标
accuracy_best = accuracy_score(y_test, y_pred_best)
precision_best = precision_score(y_test, y_pred_best)
recall_best = recall_score(y_test, y_pred_best)
f1_best = f1_score(y_test, y_pred_best)

print(f"Optimized Accuracy: {accuracy_best:.4f}")
print(f"Optimized Precision: {precision_best:.4f}")
print(f"Optimized Recall: {recall_best:.4f}")
print(f"Optimized F1 Score: {f1_best:.4f}")
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容