

1. 目标定义和假设设定
1.1 背景介绍
在现代通信中,垃圾短信(Spam SMS)不仅影响用户体验,还可能涉及诈骗、广告骚扰等问题。因此,自动化垃圾短信检测是一个重要的任务。通过机器学习,我们可以构建分类模型,自动区分正常短信(Ham)和垃圾短信(Spam),提高用户体验并减少不必要的干扰。
本案例基于 Kaggle 的 Spam SMS Messages Dataset,该数据集包含真实的短信文本及其对应的标签。我们将通过数据分析和机器学习模型,探索短信文本特征,并构建垃圾短信检测模型。
1.2 分析目标
本案例的核心目标包括:
- 数据探索与预处理:分析数据的基本特征,处理缺失值、异常值等问题。
- 特征工程:提取文本特征,如词频、TF-IDF(词频-逆文档频率)等,为机器学习模型提供有效的输入。
- 模型训练与评估:使用机器学习算法(如 Naïve Bayes、逻辑回归等)训练垃圾短信分类模型,并评估其性能。
- 结果分析与优化:分析模型效果,尝试改进特征提取和模型参数,以提高分类准确率。
1.3 假设设定
为了完成上述目标,我们设定以下假设,并在分析过程中进行验证:
- H0H0(零假设):短信文本的词汇分布对垃圾短信和正常短信的分类没有显著影响。
- H1H1(备择假设):短信文本的词汇分布对垃圾短信和正常短信的分类有显著影响,可以通过机器学习模型进行有效区分。
此外,我们假设:
- 垃圾短信通常包含某些高频词,如“免费”(free)、“中奖”(win)、“优惠”(offer)等。
- 正常短信较少包含过度营销或诈骗相关的关键词,结构较为自然。
- 通过 TF-IDF、词频等文本特征,可以有效区分垃圾短信和正常短信。
2. 数据探索
在进行数据建模之前,我们需要对数据进行充分的探索,以便理解数据的基本结构、质量情况以及潜在的模式。
这一步包括数据基本信息的检查、缺失值与异常值的处理、数据分布的可视化分析等。
2.1 加载数据集
我们使用 pandas 读取数据,并查看数据的基本信息,包括数据类型、缺失值情况等。
import pandas as pd

# 读取数据集
file_path = "./dataset/011/spam.csv"
df = pd.read_csv(file_path, encoding='ISO-8859-1')

# 查看数据前几行
df.head()
2.2 数据基本信息
# 查看数据集的基本信息
df.info()

# 查看数据的统计摘要
df.describe(include="all")
分析结果:
- 数据集中共有 5 列,但有 3 列无列名(Unnamed: 2, Unnamed: 3, Unnamed: 4)。
- 主要关心的列是 v1(标签: Spam/Ham) 和v2(短信内容),其余列可能为空,需要进一步处理。
- 数据类型主要是 object(字符串类型),后续可能需要转换。
2.3 处理无关列
因为 Unnamed: 2, Unnamed: 3, Unnamed: 4 主要为空,我们删除这些无用列,并重命名重要列:
# 只保留有用的列
df = df[['v1', 'v2']]

# 重命名列
df.columns = ['label', 'message']

# 再次检查数据
df.head()
2.4 处理缺失值
# 检查缺失值
missing_values = df.isnull().sum()
print(missing_values)

# 由于本数据集无缺失值,若有可使用以下方法填充:
df = df.dropna()  # 删除缺失值
# df = df.fillna('未知')  # 或者填充特定值
该数据集没有缺失值,因此不需要填充处理。
2.5 处理重复值
# 检查重复值
duplicate_count = df.duplicated().sum()
print(f"重复值数量: {duplicate_count}")

# 删除重复值
df = df.drop_duplicates()
如果有重复值,则删除它们,以保证数据质量。
2.6 数据分布可视化
2.6.1 类别分布
我们先看看 垃圾短信(Spam) 和正常短信(Ham) 的数量分布:
import matplotlib.pyplot as plt
import seaborn as sns

# 统计各类别的数量
plt.figure(figsize=(6,4))
sns.countplot(data=df, x='label', palette="coolwarm")

# 设置标题
plt.title("Distribution of Messages", fontsize=14)
plt.xlabel("Message Type", fontsize=12)
plt.ylabel("Count", fontsize=12)
plt.show()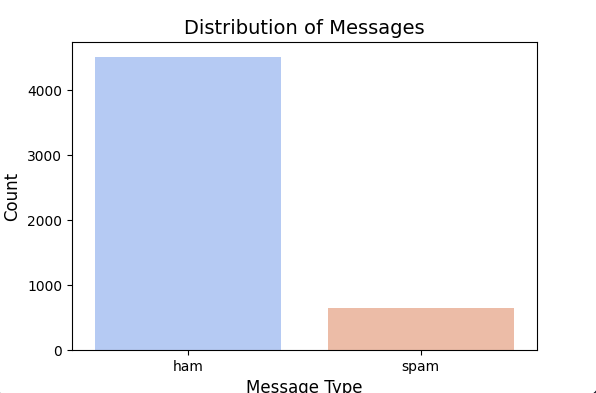
观察垃圾短信与正常短信的数量,看看是否存在数据不均衡问题。
2.6.2 短信长度分布
# 添加短信长度列
df["message_length"] = df["message"].apply(len)

# 绘制短信长度分布
plt.figure(figsize=(8,5))
sns.histplot(df["message_length"], bins=50, kde=True, color='royalblue')

# 设置标题和标签
plt.title("Message Length Distribution", fontsize=14)
plt.xlabel("Message Length", fontsize=12)
plt.ylabel("Frequency", fontsize=12)
plt.show()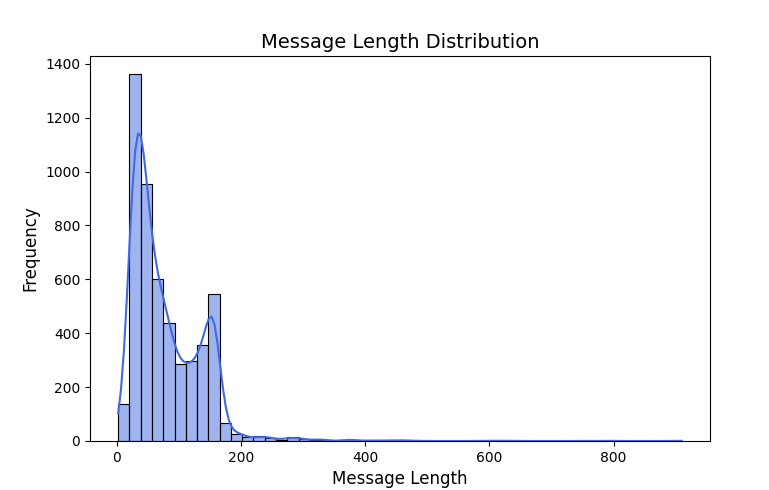
我们可以看到垃圾短信和正常短信的长度是否存在差异。
2.6.3 词云可视化
使用词云(WordCloud)查看常见单词,看看垃圾短信和正常短信的词汇分布是否有明显区别。
from wordcloud import WordCloud

# 生成垃圾短信和正常短信的文本
spam_text = " ".join(df[df["label"] == "spam"]["message"])
ham_text = " ".join(df[df["label"] == "ham"]["message"])

# 绘制词云
plt.figure(figsize=(12,5))

# 垃圾短信词云
plt.subplot(1, 2, 1)
spam_wc = WordCloud(width=400, height=300, background_color="black", colormap="Reds").generate(spam_text)
plt.imshow(spam_wc, interpolation="bilinear")
plt.axis("off")
plt.title("Spam Message WordCloud", fontsize=14)

# 正常短信词云
plt.subplot(1, 2, 2)
ham_wc = WordCloud(width=400, height=300, background_color="black", colormap="Blues").generate(ham_text)
plt.imshow(ham_wc, interpolation="bilinear")
plt.axis("off")
plt.title("Ham Message WordCloud", fontsize=14)

plt.show()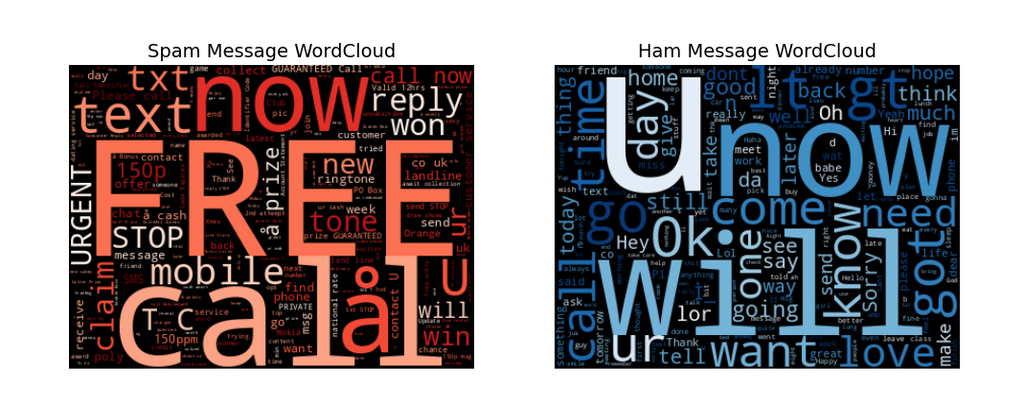
观察哪些词在垃圾短信中更常见(如 free, win, claim),哪些词在正常短信中常见(如ok, call, see)。
2.7 相关性分析
由于本数据集是文本类型,数值型特征较少,因此我们分析 短信长度 与垃圾短信的关系。
plt.figure(figsize=(6,4))
sns.boxplot(data=df, x='label', y='message_length', palette="coolwarm")

# 设置标题
plt.title("Message Length vs Spam/Ham", fontsize=14)
plt.xlabel("Message Type", fontsize=12)
plt.ylabel("Message Length", fontsize=12)
plt.show()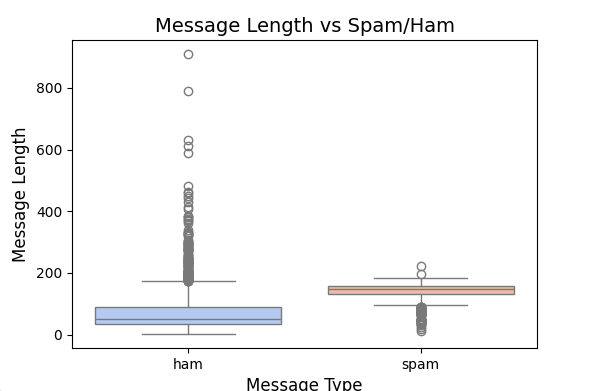
如果垃圾短信明显比正常短信长(或短),说明长度可能是一个重要的特征。
2.8 小结
- 数据集清理:去除无关列、删除重复值、检查缺失值。
- 数据探索:垃圾短信数量远少于正常短信,数据可能存在不均衡。
- 短信长度分析:垃圾短信和正常短信的长度可能有所区别。
- 文本可视化:垃圾短信高频词明显不同,如win, claim, prize 等。
- 数据趋势:短信长度和垃圾短信之间可能存在一定关系。












请登录后查看评论内容