

我们需要构建一个既能处理高维稀疏文本数据,又能具备较好泛化能力的分类模型。
经过对数据特点的分析,我们选择 支持向量机(Support Vector Machine, SVM) 作为主要模型,具体原因:
4.1 模型选择理由
- 适应高维稀疏数据:文本数据在经过 TF-IDF 转换后通常呈现高维、稀疏的特性,而线性 SVM 在这种数据结构上表现优异,能有效找到区分垃圾短信与正常短信的超平面。
- 边界最大化原理:SVM 的核心思想在于最大化类别间的间隔(Margin),这使得模型在面对未知数据时具有较强的泛化能力,从而降低过拟合风险。
- 鲁棒性和灵活性:SVM 可通过引入软间隔(Soft Margin)来处理噪音数据,同时可以利用核技巧(Kernel Trick)在非线性特征空间中进行映射(在本案例中,线性核已经足够优秀)。
4.2 SVM 算法原理与公式推理
1. 线性可分的情况
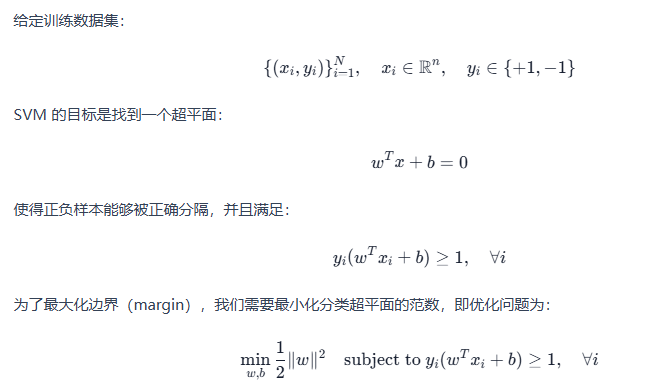
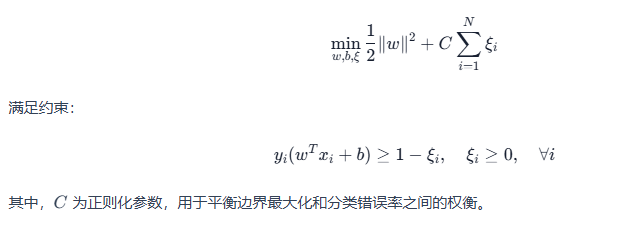
2. 软间隔(Soft Margin)
实际数据中往往存在噪音或重叠样本,故引入松弛变量 ξi 允许部分错误分类:
3. 核技巧(Kernel Trick)
当数据非线性可分时,可通过核函数 K(xi,xj) 将数据映射到高维特征空间,在该空间内进行线性分割。但对于文本数据,线性核通常已经能达到良好的效果,因此本案例中我们使用线性 SVM。
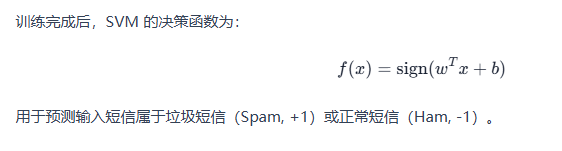
4. 决策函数
4.3 多维度数据分析与模型构建
1. 多维度特征分析
- 文本特征:利用 TF-IDF 将短信文本转化为 3000 维特征向量。
- 类别不平衡:通过前期数据探索分析垃圾短信与正常短信的数量分布,确保数据分割时的比例平衡。
- 短信长度:短信长度作为辅助特征,也可以纳入进一步分析,观察是否对分类效果有辅助提升。
2. SVM 模型构建
基于上述分析,我们选用 Linear SVM 模型来构建分类器。
下面给出使用 sklearn 构建 SVM 模型的代码:
from sklearn.svm import LinearSVC
from sklearn.metrics import classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# 构建线性SVM模型(适合高维、稀疏文本数据)
svm_model = LinearSVC(random_state=42, C=1.0)  # C为正则化参数

# 训练模型(这里选择了TF-IDF特征,也可以尝试BoW特征)
svm_model.fit(X_train, y_train)

# 预测测试集
y_pred = svm_model.predict(X_test)

# 输出分类报告
print(classification_report(y_test, y_pred))

# 输出混淆矩阵
cm = confusion_matrix(y_test, y_pred)
plt.figure(figsize=(6,5))
sns.heatmap(cm, annot=True, fmt='d', cmap='viridis')
plt.title("Confusion Matrix", fontsize=14)
plt.xlabel("Predicted Label", fontsize=12)
plt.ylabel("True Label", fontsize=12)
plt.show()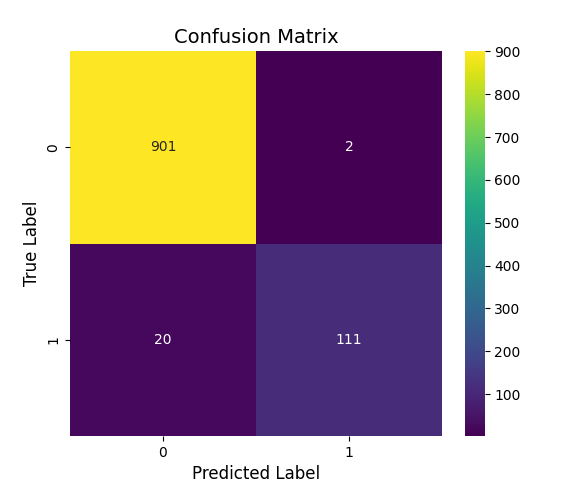
3. 多维度数据可视化(PCA 降维展示)
为了更直观地了解高维文本数据在 SVM 下的分类情况,我们可以使用 PCA 将数据降到二维,并展示决策边界的分布情况。
from sklearn.decomposition import PCA
import numpy as np

# 降维到二维(只用于可视化,不参与模型训练)
pca = PCA(n_components=2, random_state=42)
X_train_pca = pca.fit_transform(X_train.toarray())
X_test_pca = pca.transform(X_test.toarray())

# 重新训练一个在PCA空间下的SVM模型(用于可视化目的)
svm_model_pca = LinearSVC(random_state=42, C=1.0)
svm_model_pca.fit(X_train_pca, y_train)

# 绘制散点图及决策边界
plt.figure(figsize=(8,6))
# 绘制测试集散点图
plt.scatter(X_test_pca[:, 0], X_test_pca[:, 1], c=y_test, cmap='coolwarm', edgecolor='k', s=50, alpha=0.7)

# 绘制决策边界
# 创建网格数据
x_min, x_max = X_test_pca[:, 0].min() - 1, X_test_pca[:, 0].max() + 1
y_min, y_max = X_test_pca[:, 1].min() - 1, X_test_pca[:, 1].max() + 1
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 500), np.linspace(y_min, y_max, 500))
grid = np.c_[xx.ravel(), yy.ravel()]
Z = svm_model_pca.decision_function(grid)
Z = Z.reshape(xx.shape)

plt.contourf(xx, yy, Z, levels=[Z.min(), 0, Z.max()], alpha=0.2, colors=['blue', 'red'])
plt.contour(xx, yy, Z, levels=[0], linewidths=2, colors='black')

plt.title("SVM Decision Boundary (PCA Projection)", fontsize=14)
plt.xlabel("Principal Component 1", fontsize=12)
plt.ylabel("Principal Component 2", fontsize=12)
plt.show()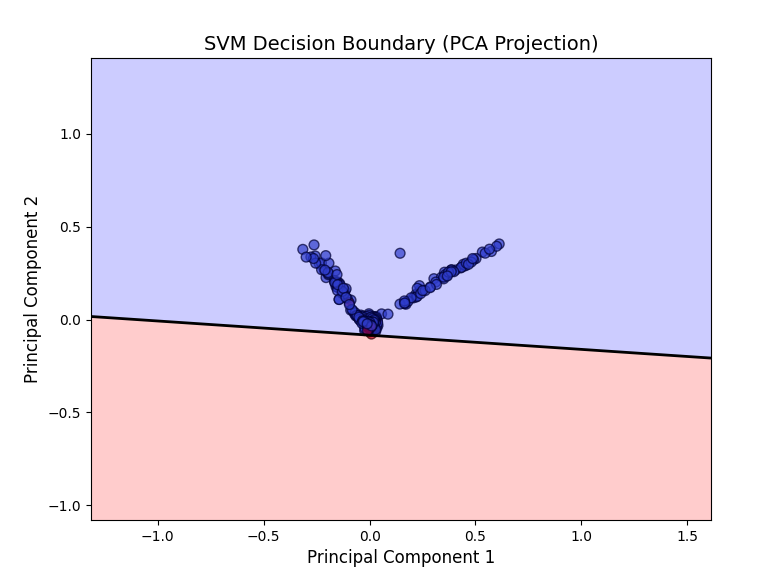
- PCA 降维:将高维 TF-IDF 特征投影到二维平面,仅用于可视化,帮助理解 SVM 如何区分不同类别。
- 决策边界展示:通过绘制决策函数的等高线,直观展示 SVM 在低维空间下划分垃圾短信和正常短信的效果。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容