

2.5.1 损失函数
对于模型一次预测结果的好坏,需要有一个度量标准。
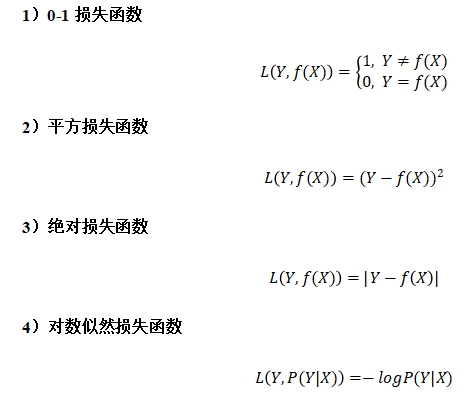
对于监督学习而言,给定一个输入X,选取的模型就相当于一个“决策函数”f,它可以输出一个预测结果f(X),而真实的结果(标签)记为Y。f(X) 和Y之间可能会有偏差,我们就用一个损失函数(loss function)来度量预测偏差的程度,记作 L(Y,f(X))。
- 损失函数用来衡量模型预测误差的大小;损失函数值越小,模型就越好;
- 损失函数是f(X)和Y的非负实值函数;
常见的损失函数有:
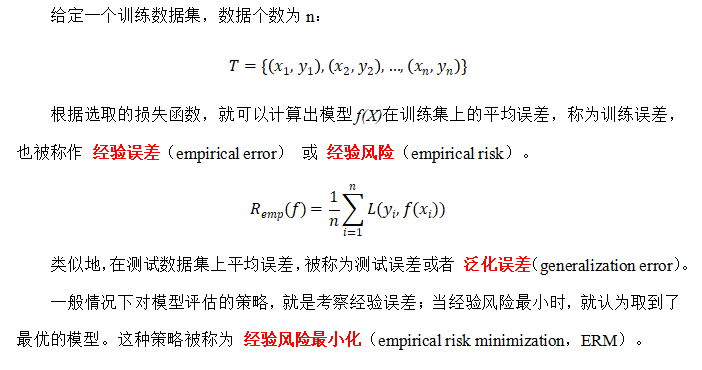
2.5.2 经验误差
2.5.3 欠拟合与过拟合
拟合(Fitting)是指机器学习模型在训练数据上学习到规律并生成预测结果的过程。理想情况下,模型能够准确地捕捉训练数据的模式,并且在未见过的新数据(测试数据)上也有良好的表现;即模型具有良好的 泛化能力。
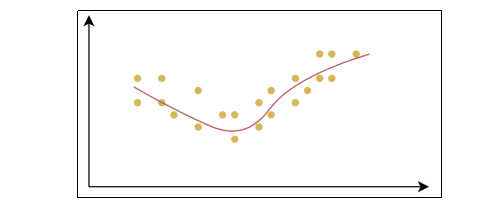
欠拟合(Underfitting):是指模型在训练数据上表现不佳,无法很好地捕捉数据中的规律。这样的模型不仅在训练集上表现不好,在测试集上也同样表现差。
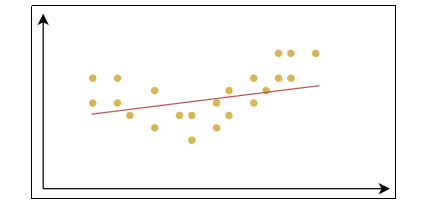
过拟合(Overfitting):是指模型在训练数据上表现得很好,但在测试数据或新数据上表现较差的情况。过拟合的模型对训练数据中的噪声或细节过度敏感,把训练样本自身的一些特点当作了所有潜在样本都会具有的一般性质,从而失去了泛化能力。
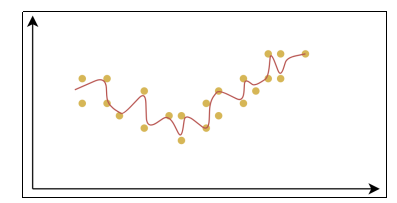
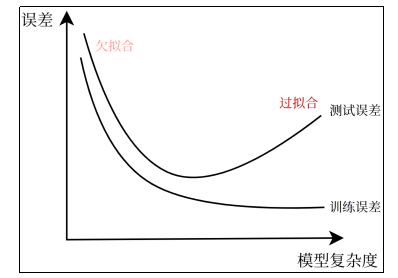
产生欠拟合和过拟合的根本原因,是模型的复杂度过低或过高,从而导致测试误差(泛化误差)偏大。
- 欠拟合:模型在训练集和测试集上误差都比较大。模型过于简单,高偏差。
- 过拟合:模型在训练集上误差较小,但在测试集上误差较大。模型过于复杂,高方差。
- 产生原因与解决办法欠拟合
产生原因:
- 模型复杂度不足:模型过于简单,无法捕捉数据中的复杂关系。
- 特征不足:输入特征不充分,或者特征选择不恰当,导致模型无法充分学习数据的模式。
- 训练不充分:训练过程中迭代次数太少,模型没有足够的时间学习数据的规律。
- 过强的正则化:正则化项设置过大,强制模型过于简单,导致模型无法充分拟合数据。
解决办法:
- 增加模型复杂度:选择更复杂的模型。
- 增加特征或改进特征工程:添加更多的特征或通过特征工程来创造更有信息量的特征。
- 增加训练时间:增加训练的迭代次数,让模型有更多机会去学习。
- 减少正则化强度:如果使用了正则化,尝试减小正则化的权重,以让模型更灵活。
- 过拟合
产生原因:
- 模型复杂度过高:模型过于复杂,参数太多。
- 训练数据不足:数据集太小,模型能记住训练数据的细节,但无法泛化到新数据。
- 特征过多:特征太多,模型可能会“记住”数据中的噪声,而不是学到真正的规律。
- 训练过长:训练时间过长,导致模型学习到训练数据中的噪声,而非数据的真正规律。
解决办法:
- 减少模型复杂度:降低模型的参数数量、使用简化的模型或降维来减小模型复杂度。
- 增加训练数据:收集更多数据,或通过数据增强来增加训练数据的多样性。
- 使用正则化:引入L1、L2正则化,避免过度拟合训练数据。
- 交叉验证:使用交叉验证技术评估模型在不同数据集上的表现,以减少过拟合的风险。
- 早停:训练时,当模型的验证损失不再下降时,提前停止训练,避免过度拟合训练集。
- 代码演示
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

plt.rcParams["font.sans-serif"] = ["KaiTi"]
plt.rcParams["axes.unicode_minus"] = False

def polynomial(x, degree):
    """构成多项式,返回 [x^1,x^2,x^3,...,x^n]"""
    return np.hstack([x**i for i in range(1, degree + 1)])

# 生成随机数据
X = np.linspace(-3, 3, 300).reshape(-1, 1)
y = np.sin(X) + np.random.uniform(-0.5, 0.5, 300).reshape(-1, 1)
fig, ax = plt.subplots(1, 3, figsize=(15, 4))
ax[0].plot(X, y, "yo")
ax[1].plot(X, y, "yo")
ax[2].plot(X, y, "yo")

# 划分训练集和测试集
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 创建线性回归模型
model = LinearRegression()

# 欠拟合
x_train1 = x_train
x_test1 = x_test
model.fit(x_train1, y_train)  # 模型训练
y_pred1 = model.predict(x_test1)  # 预测
ax[0].plot(np.array([[-3], [3]]), model.predict(np.array([[-3], [3]])), "c")  # 绘制曲线
ax[0].text(-3, 1, f"测试集均方误差:{mean_squared_error(y_test, y_pred1):.4f}")
ax[0].text(-3, 1.3, f"训练集均方误差:{mean_squared_error(y_train, model.predict(x_train1)):.4f}")

# 恰好拟合
x_train2 = polynomial(x_train, 5)
x_test2 = polynomial(x_test, 5)
model.fit(x_train2, y_train)  # 模型训练
y_pred2 = model.predict(x_test2)  # 预测
ax[1].plot(X, model.predict(polynomial(X, 5)), "k")  # 绘制曲线
ax[1].text(-3, 1, f"测试集均方误差:{mean_squared_error(y_test, y_pred2):.4f}")
ax[1].text(-3, 1.3, f"训练集均方误差:{mean_squared_error(y_train, model.predict(x_train2)):.4f}")

# 过拟合
x_train3 = polynomial(x_train, 20)
x_test3 = polynomial(x_test, 20)
model.fit(x_train3, y_train)  # 模型训练
y_pred3 = model.predict(x_test3)  # 预测
ax[2].plot(X, model.predict(polynomial(X, 20)), "r")  # 绘制曲线
ax[2].text(-3, 1, f"测试集均方误差:{mean_squared_error(y_test, y_pred3):.4f}")
ax[2].text(-3, 1.3, f"训练集均方误差:{mean_squared_error(y_train, model.predict(x_train3)):.4f}")
plt.show()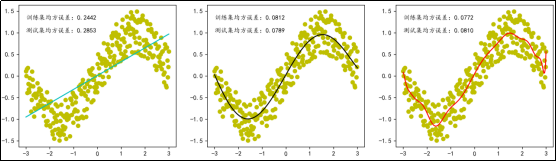
当多项式次数较低时,模型过于简单,拟合效果较差。
当多项式次数增加后,模型复杂度适中,拟合效果较好,训练误差和测试误差均较低。
当多项式次数继续增加,模型变得过于复杂,过度学习了噪声,导致训练误差较低而测试误差较高。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容