

5.1 逻辑回归简介
5.1.1 什么是逻辑回归
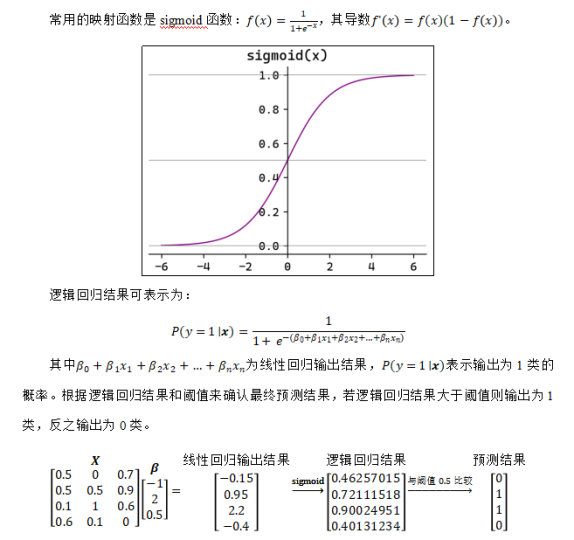
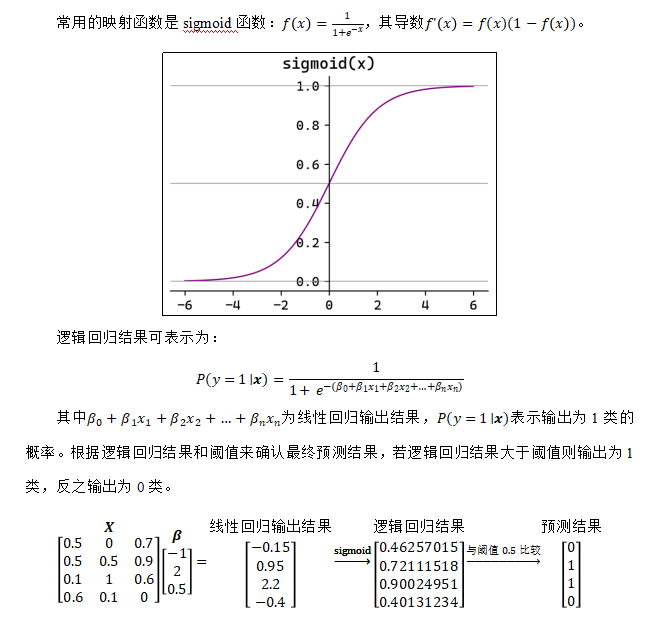
逻辑回归(Logistic Regression)是一种用于解决分类问题的统计方法,尤其适用于二分类问题。尽管名称中有“回归”,但它主要用于分类任务。
逻辑回归通过将线性回归的输出映射到[0,1]区间,来表示某个类别的概率。
5.1.2 逻辑回归应用场景
- 信用评分:预测客户是否会违约(违约/不违约)。
- 欺诈检测:预测某笔交易是否是欺诈行为。
- 垃圾邮件检测:预测一封邮件是否是垃圾邮件(垃圾邮件/非垃圾邮件)。
- 广告点击预测:预测用户是否会点击某个广告(点击/不点击)。
- 图像分类:将图像分类为不同的类别(如猫、狗、鸟等)。
- 情感分析:将文本分类为正面、负面或中性情感。
- 产品质量分类:预测产品是否合格。
- 医学诊断:预测患者是否患有某种疾病(患病/未患病)。
- 蛋白质功能预测:基于蛋白质序列和结构特征预测其功能类别。
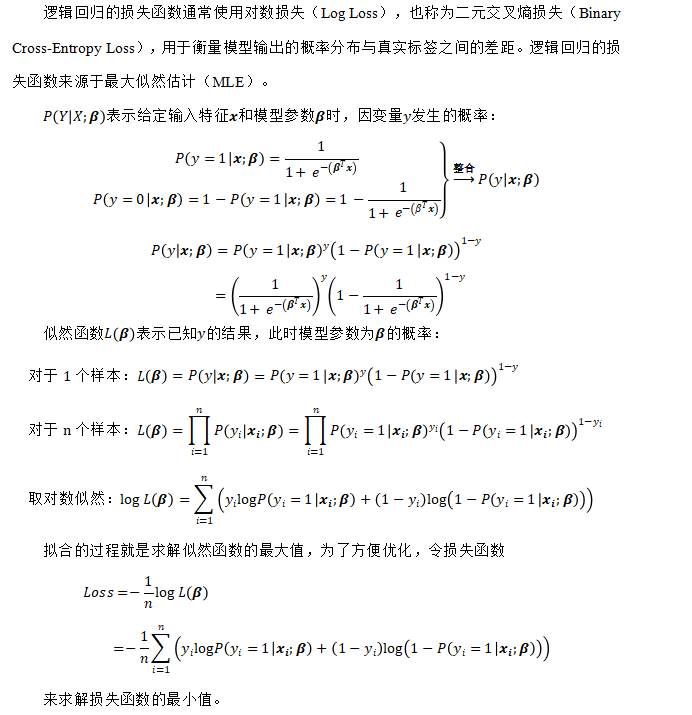
5.1.3 逻辑回归损失函数
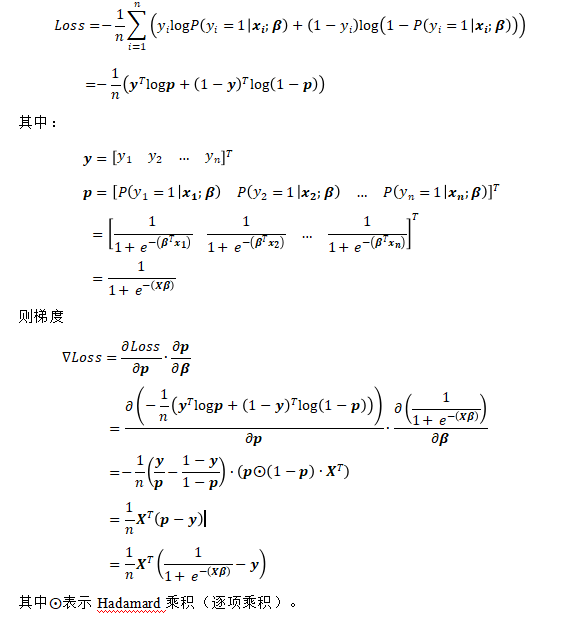
5.1.4 损失函数的梯度
5.1.5 API使用
- LogisticRegression参数说明
scikit-learn中的LogisticRegression类用于实现逻辑回归。它支持二分类和多分类任务,并提供了多种优化算法和正则化选项。
# solver: 优化算法
#   lbfgs: 拟牛顿法(默认),仅支持L2正则化
#   newton-cg: 牛顿法,仅支持L2正则化
#   liblinear: 坐标下降法,适用于小数据集,支持L1和L2正则化
#   sag: 随机平均梯度下降,适用于大规模数据集,仅支持L2正则化
#   saga: 改进的随机梯度下降,适用于大规模数据,支持L1、L2和ElasticNet正则化
# penalty: 正则化类型,可选l1、l2和elasticnet
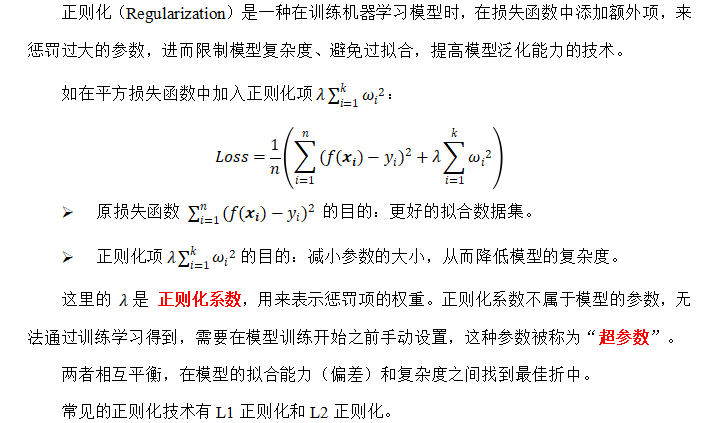
# C: 正则化强度,C越小,正则化强度越大
# class_weight: 类别权重,balanced表示自动平衡类别权重,让模型在训练时更关注少数类,从而减少类别不平衡带来的偏差
model = sklearn.linear_model.LogisticRegression(solver="lbfgs", penalty="l2", C=1, class_weight="balanced")
2. 案例:心脏病预测
Heart Disease数据集https://www.kaggle.com/datasets/johnsmith88/heart-disease-dataset。
- 年龄:连续值
- 性别:0-女,1-男
- 胸痛类型:0-典型心绞痛,1-非典型心绞痛,2-非心绞痛,3-无症状
- 静息血压:连续值,单位mmHg
- 胆固醇:连续值,单位mg/dl
- 空腹血糖:1-大于120mg/dl,0-小于等于120mg/dl
- 静息心电图结果:0-正常,1-ST-T异常,2-可能左心室肥大
- 最大心率:连续值
- 运动性心绞痛:1-有,0-无
- 运动后的ST下降:连续值
- 峰值ST段的斜率:0-向上,1-水平,2-向下
- 主血管数量:0到3
- 地中海贫血:一种先天性贫血,0-正常,1-固定缺陷,2-可逆缺陷
- 是否患有心脏病:标签,0-否,1-是
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LogisticRegression

# 加载数据集
heart_disease = pd.read_csv("data/heart_disease.csv")
heart_disease.dropna()

# 划分为训练集与测试集
X = heart_disease.drop("是否患有心脏病", axis=1)  # 特征
y = heart_disease["是否患有心脏病"]  # 标签
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100)

# 特征工程
# 数值型特征
numerical_features = ["年龄", "静息血压", "胆固醇", "最大心率", "运动后的ST下降", "主血管数量"]
# 类别型特征
categorical_features = ["胸痛类型", "静息心电图结果", "峰值ST段的斜率", "地中海贫血"]
# 二元特征
binary_features = ["性别", "空腹血糖", "运动性心绞痛"]
# 创建列转换器
preprocessor = ColumnTransformer(
    transformers=[
        # 对数值型特征进行标准化
        ("num", StandardScaler(), numerical_features),
        # 对类别型特征进行独热编码,使用drop="first"避免多重共线性
        ("cat", OneHotEncoder(drop="first"), categorical_features),
        # 二元特征不进行处理
        ("binary", "passthrough", binary_features),
    ]
)
# 执行特征转换
x_train = preprocessor.fit_transform(x_train)  # 计算训练集的统计信息并进行转换
x_test = preprocessor.transform(x_test)  # 使用训练集计算的信息对测试集进行转换

# 模型训练
model = LogisticRegression()
model.fit(x_train, y_train)

# 模型评估,计算准确率
model.score(x_test, y_test)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END




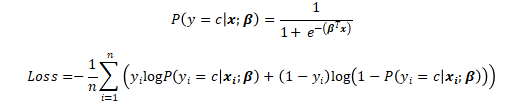






请登录后查看评论内容