

8.1 聚类
8.1.1 聚类简介
聚类(Clustering)旨在将数据集中的样本分成若干个簇,使得同一个簇内的对象彼此相似,不同簇间的对象差异较大。聚类是一种无监督学习算法,不需要预先标记数据的标签,完全依赖数据本身内在结构和特征来进行分组,最终簇所对应的概念语义需由使用者来把握和命名。
聚类的核心是“物以类聚”,具体通过以下步骤实现:
- 定义相似性:选择一个度量标准(如欧氏距离,余弦相似度)来衡量对象之间的相似性或距离。
- 分组:根据相似性将对象分配到不同的簇中。
- 优化:通过迭代或直接计算,调整簇的划分,使簇内相似性最大化,簇间差异最大化。
聚类应用场景:
- 市场细分:将消费者按购买习惯分组。
- 图像分割:将图像像素按颜色或纹理聚类。
- 异常检测:识别不属于任何主要簇的异常点。
- 生物信息:对基因表达数据进行分组。
8.1.2 常见聚类算法
2)层次聚类
层次聚类(Hierarchical Clustering)假设簇之间存在层次结构,将样本聚到层次化的簇中。层次聚类有自下而上的聚合方法和自上而下的分裂方法。因为每个样本只属于一个簇,所以层次聚类属于硬聚类。
聚合聚类:开始将每个样本各自分到一个簇,之后将相距最近的两个簇合并,如此往复直至满足停止条件(例如达到预设的簇的个数、每个簇只包含一个样本、簇内样本相似性达到某个阈值等)。
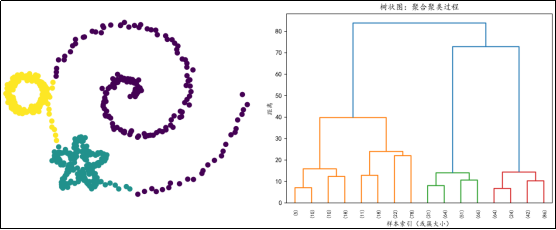
分裂聚类:开始将整个数据集视作一个整体,之后根据某种距离或相似性度量,选择一个现有的簇将其分裂成两个簇,使分裂后子簇内相似性高,子簇间差异大,如此往复直至满足停止条件。
3)密度聚类
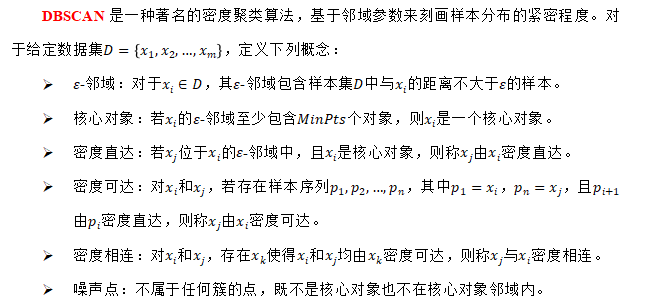
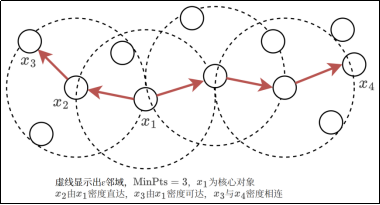
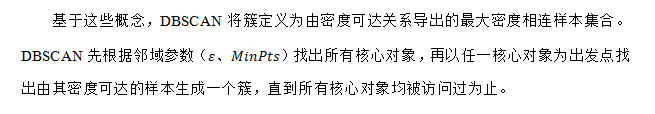
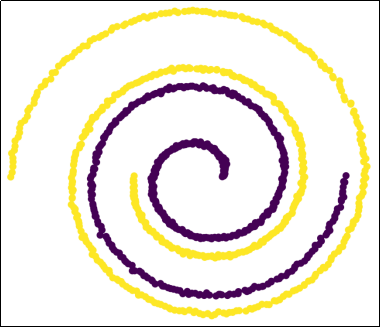
密度聚类(Density-Based Clustering)假设聚类结构能通过样本分布的紧密程度确定。通常情况下,密度聚类算法从样本密度的角度来考察样本之间的可连接性,并基于可连接样本不断扩展簇以获得最终聚类效果。

8.1.3 K-means API使用
kmeans = KMeans(n_clusters=3)
# n_clusters: 指定 K 的值
kmeans.fit(X)  # 训练
kmeans.predict(X)  # 预测
kmeans.fit_predict(X)  # 训练并预测
示例代码:
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs

plt.rcParams["font.sans-serif"] = ["KaiTi"]
plt.rcParams["axes.unicode_minus"] = False

# 使用 make_blobs 生成 3 个簇,每个簇 100 个点
X, y_true = make_blobs(n_samples=300, centers=3, cluster_std=2)

fig, ax = plt.subplots(2, figsize=(8, 8))
ax[0].scatter(X[:, 0], X[:, 1], s=50, c="gray", label="原始数据")
ax[0].set_title("原始数据")
ax[0].legend()

# 使用 K-Means 聚类
kmeans = KMeans(n_clusters=3)
kmeans.fit(X)
y_kmeans = kmeans.predict(X)  # 预测每个点的簇标签
centers = kmeans.cluster_centers_  # 获取簇中心

ax[1].scatter(X[:, 0], X[:, 1], s=50, c=y_kmeans)
ax[1].scatter(centers[:, 0], centers[:, 1], s=200, c="red", marker="o", label="簇中心")
ax[1].set_title("K-means 聚类结果 (K=3)")
ax[1].legend()
plt.show()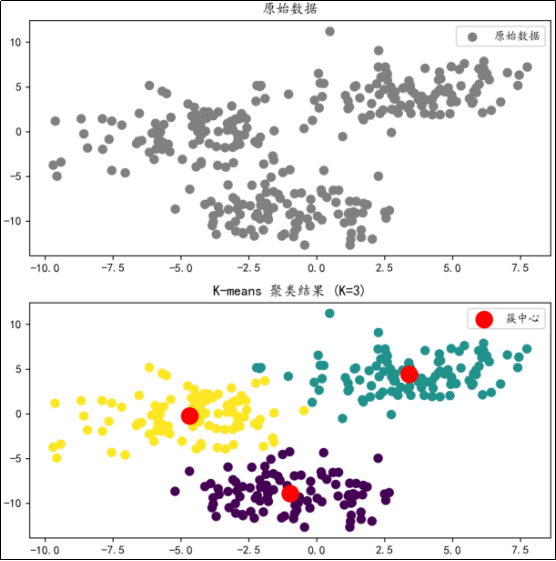
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容