

集成学习(Ensemble Learning)通过某种策略组合多个个体学习器的预测结果来提高整体的预测能力。只包含同种类型的个体学习器的集成称为同质集成,例如决策树集成中全是决策树,同质集成中的个体学习器亦称基学习器,相应的学习算法称为基学习算法。包含不同类型的个体学习器的集成称为异质集成,例如同时包含决策树和神经网络。
集成学习有三大经典方法:Boosting、Bagging和Stacking。
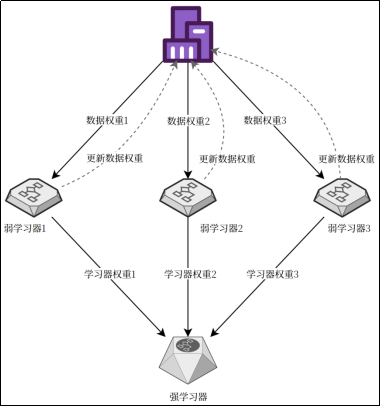
Boosting(提升方法)按顺序训练模型,每个模型关注前一个模型的错误,通过加权调整来优化整体预测。如AdaBoost通过给错分的样本更大的权重,逐步改进;梯度提升树用梯度下降法优化损失函数;XGBoost和LightGBM是高效的梯度提升树变种。Boosting主要关注于降低偏差。
Bagging(Bootstrap Aggregating,自助聚合)从原始数据集中通过有放回的对样本采样生成多个子数据集,分别训练多个独立模型,最后通过投票(分类)或平均(回归)得到结果。随机森林则是在Bagging基础上随机选择特征子集训练每棵树。Bagging主要关注于降低方差。
Stacking(堆叠)训练多个不同类型的个体学习器,之后使用一个元模型综合多个个体学习器的预测。灵活性强,能结合多种模型的优势。
7.4.1 AdaBoost
在概率近似正确学习的框架中,一个概念如果存在一个多项式的学习算法能够学习它,并且正确率很高,就称这个概念是强可学习的;一个概念如果存在一个多项式的学习算法能够学习它,但正确率仅比随机猜测略好,就称这个概念是弱可学习的。后来证明,强可学习与弱可学习是等价的。那么如果已经发现了弱学习算法,能否通过某种方式将其提升为强学习算法?
对于分类问题而言,给定一个训练样本集,求比较粗糙的分类规则(弱分类器)要比求精确的分类规则(强分类器)容易的多。Boosting就是从弱学习算法出发,反复学习,得到一系列弱分类器,然后组合这些弱分类器构成一个强分类器。AdaBoost通常使用单层决策树作为基学习器,单层决策树也被称为决策树桩(Decision Stump)。
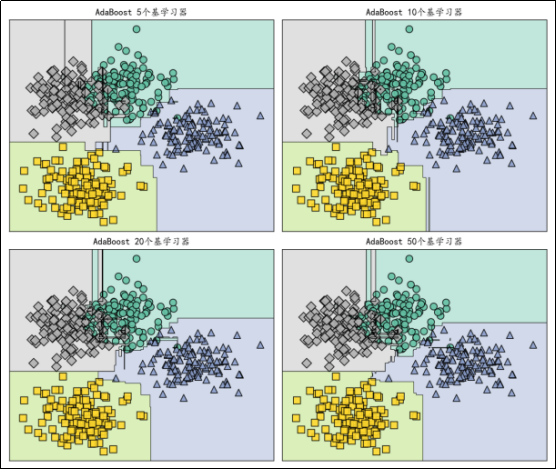
大多数Boosting都是改变训练数据的概率分布(权重分布),针对不同的训练数据分布调用弱学习算法学习一系列弱分类器。AdaBoost(Adaptive Boosting,自适应提升)的做法是提高被前一轮弱分类器错误分类的样本的权重,降低被正确分类的样本的权重。这样一来后一轮弱学习器会更加关注那些没有被正确分类的数据。同时采用加权多数表决的方法,加大分类误差率小的弱分类器的权重,减小分类误差率大的弱分类器的权重。
7.4.2 随机森林
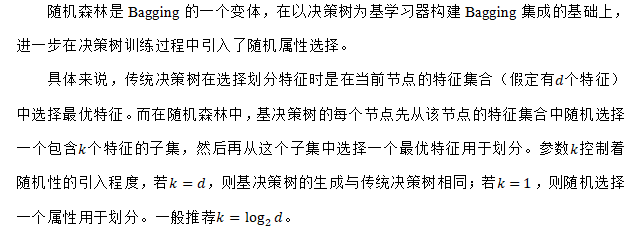
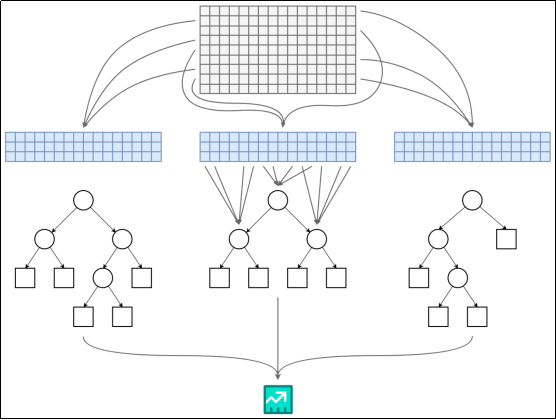
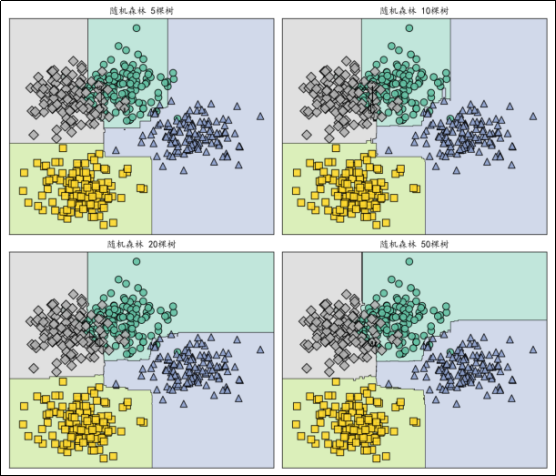
随机森林简单易实现,但在很多任务中都展现出了强大性能,被誉为“代表集成学习技术水平的方法”。Bagging中基学习器的多样性仅来自于样本扰动,而随机森林中基学习器的多样性不仅来自样本扰动,还来自特征扰动,这就使得最终集成的泛化性能可通过基学习器之间差异度的增加而进一步提升。










请登录后查看评论内容