

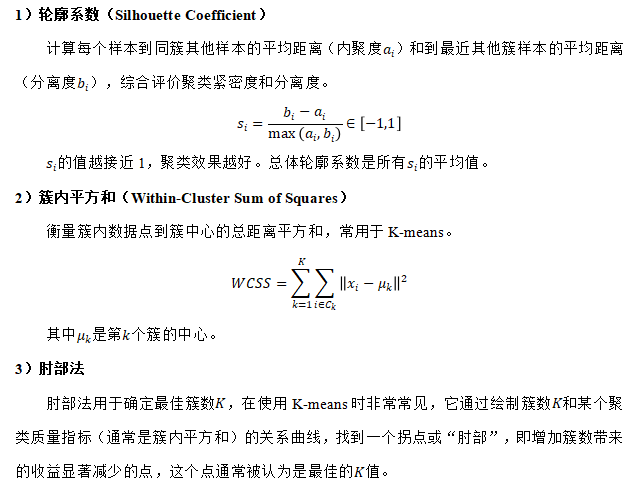
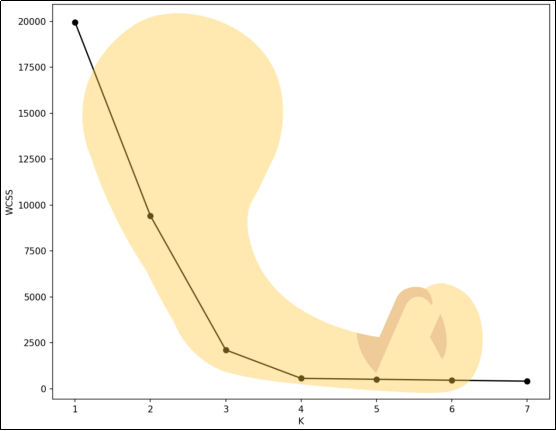
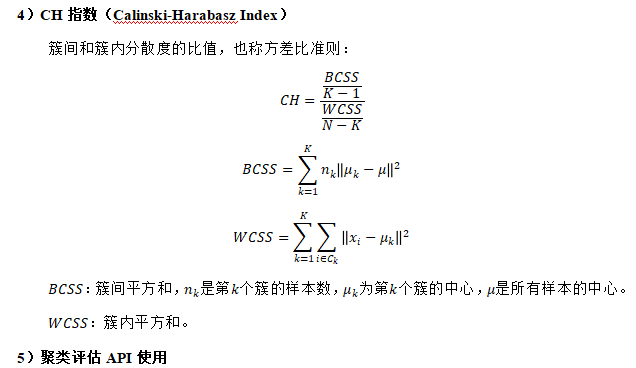
由于聚类任务没有预定义的标签(不像监督学习有真实类别可供比较),所以需要依赖聚类结果和原始数据来衡量模型的好坏,主要关注簇内的紧凑性和簇间的分离性。
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs
from sklearn.metrics import silhouette_score, calinski_harabasz_score

plt.rcParams["font.sans-serif"] = ["SimHei"]
plt.rcParams["axes.unicode_minus"] = False

# 使用 make_blobs 生成 3 个簇,每个簇 100 个点
X, y_true = make_blobs(n_samples=300, centers=3, cluster_std=5)
# 使用 K-Means 聚类
kmeans = KMeans(n_clusters=3)
kmeans.fit(X)
y_kmeans = kmeans.predict(X)  # 预测每个点的簇标签
centers = kmeans.cluster_centers_  # 获取簇中心
plt.scatter(X[:, 0], X[:, 1], s=50, c=y_kmeans, cmap="viridis")
plt.scatter(centers[:, 0], centers[:, 1], s=200, c="red", marker="*", label="簇中心")
plt.legend()
print("簇内平方和:", kmeans.inertia_)
print("轮廓系数:", silhouette_score(X, y_kmeans))
print("CH指数:", calinski_harabasz_score(X, y_kmeans))
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容