

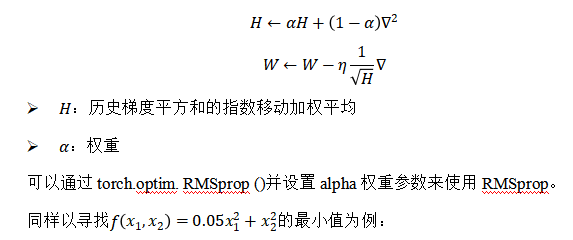
RMSProp(Root Mean Square Propagation,均方根传播)是在AdaGrad基础上的改进,它并非将过去所有梯度一视同仁的相加,而是逐渐遗忘过去的梯度,采用指数移动加权平均,呈指数地减小过去梯度的尺度。
import torch
import numpy as np
import matplotlib.pyplot as plt

def rmspropp(X, lr, alpha, n_iters):
    """rmspropp手动实现"""
    X_arr = X.detach().numpy().copy()  # 拷贝,用于记录优化过程
    H = torch.zeros_like(X)  # 存放历史梯度信息
    for epoch in range(n_iters):
        grad = 2 * X * w.T  # 当前梯度
        grad.squeeze_()  # 降维
        H = alpha * H + (1 - alpha) * grad**2  # 历史梯度平方和的指数加权平均
        X.data -= lr / (torch.sqrt(H) + 1e-8) * grad  # 更新参数,这里H后面加1e-8防止分母为0
        X_arr = np.vstack([X_arr, X.detach().numpy()])  # 记录优化过程
    return X_arr

def gradient_descent(X, optimizer, n_iters):
    X_arr = X.detach().numpy().copy()  # 拷贝,用于记录优化过程
    for epoch in range(n_iters):
        y = X**2 @ w
        y.backward()  # 反向传播
        optimizer.step()  # 更新参数
        optimizer.zero_grad()  # 清空梯度
        X_arr = np.vstack([X_arr, X.detach().numpy()])  # 记录优化过程
    return X_arr

# 从(-7, 2)出发
X = torch.tensor([-7, 2], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 1e-1  # 学习率
n_iters = 1000  # 迭代次数

# 普通梯度下降
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], "r")

# RMSProp
X_clone = X.clone().detach().requires_grad_(True)
X_arr2 = gradient_descent(X_clone, torch.optim.RMSprop([X_clone], lr=lr, alpha=0.99), n_iters=n_iters)
plt.plot(X_arr2[:, 0], X_arr2[:, 1], "b")

# RMSProp手动实现
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = rmspropp(X_clone, lr=lr, alpha=0.99, n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], c="orange", linestyle="--", linewidth=3)

# 绘制等高线图
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
plt.contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
plt.legend(["SGD", "RMSProp", "Manual RMSProp"])
plt.show()
7.5.5 Adam
Adam(Adaptive Moment Estimation,自适应矩估计)融合了Momentum和AdaGrad的方法。
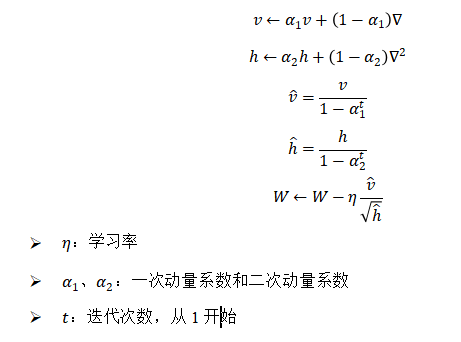
可以通过torch.optim. Adam ()并设置betas权重参数元组,其中包含两个权重参数,来使用Adam。
import torch
import numpy as np
import matplotlib.pyplot as plt

def adam(X, lr, betas, n_iters):
    """Adam手动实现"""
    X_arr = X.detach().numpy().copy()  # 拷贝,用于记录优化过程
    V = torch.zeros_like(X)  # 存放历史梯度信息
    H = torch.zeros_like(X)  # 存放历史梯度信息
    for epoch in range(n_iters):
        grad = 2 * X * w.T  # 当前梯度
        grad.squeeze_()  # 降维
        V = betas[0] * V + (1 - betas[0]) * grad  # 历史梯度的指数加权平均
        H = betas[1] * H + (1 - betas[1]) * grad**2  # 历史梯度平方和的指数加权平均
        V_hat = V / (1 - betas[0] ** (epoch + 1))
        H_hat = H / (1 - betas[1] ** (epoch + 1))
        X.data -= lr * V_hat / (torch.sqrt(H_hat) + 1e-8)  # 更新参数,这里H后面加1e-8防止分母为0
        X_arr = np.vstack([X_arr, X.detach().numpy()])  # 记录优化过程
    return X_arr

def gradient_descent(X, optimizer, n_iters):
    X_arr = X.detach().numpy().copy()  # 拷贝,用于记录优化过程
    for epoch in range(n_iters):
        y = X**2 @ w
        y.backward()  # 反向传播
        optimizer.step()  # 更新参数
        optimizer.zero_grad()  # 清空梯度
        X_arr = np.vstack([X_arr, X.detach().numpy()])  # 记录优化过程
    return X_arr

# 从(-7, 2)出发
X = torch.tensor([-7, 2], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 1e-1  # 学习率
n_iters = 1000  # 迭代次数

# 普通梯度下降
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], "r")

# Adam
X_clone = X.clone().detach().requires_grad_(True)
X_arr2 = gradient_descent(X_clone, torch.optim.Adam([X_clone], lr=lr, betas=(0.9, 0.999)), n_iters=n_iters)
plt.plot(X_arr2[:, 0], X_arr2[:, 1], "b")

# Adam手动实现
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = adam(X_clone, lr=lr, betas=(0.9, 0.999), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], c="orange", linestyle="--", linewidth=3, alpha=0.7)

# 绘制等高线图
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
plt.contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
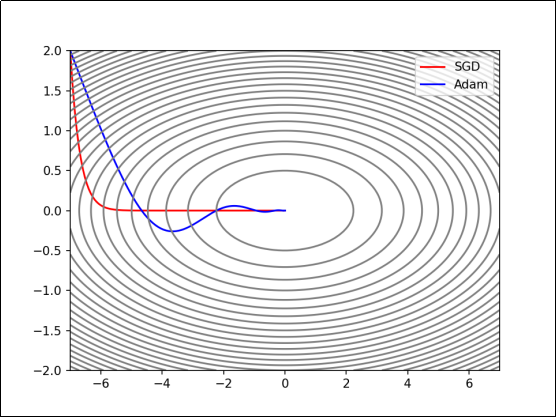
plt.legend(["SGD", "Adam", "Manual Adam"])
plt.show()
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容