

先安装pandas和scikit-learn库:pip install pandas scikit-learn。
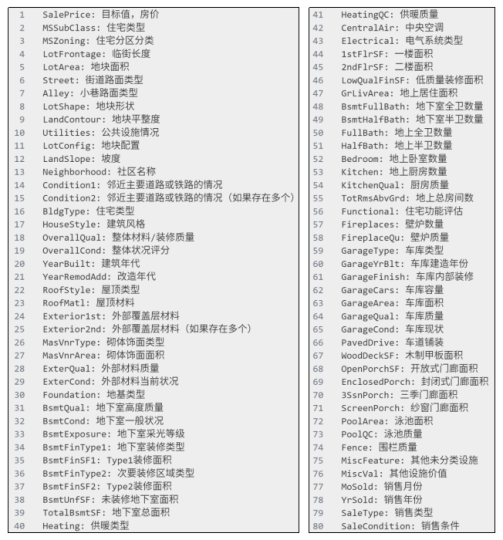
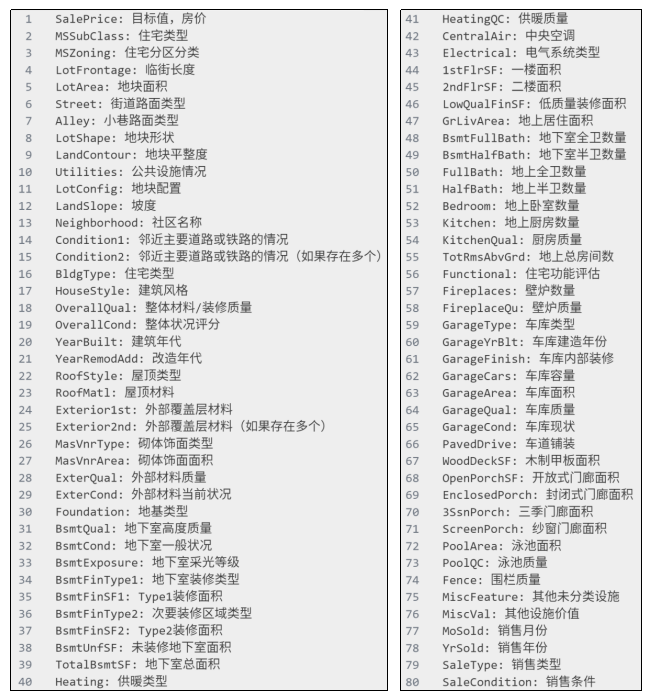
使用House Prices数据集:https://www.kaggle.com/c/house-prices-advanced-regression-techniques。
7.6.1 导入所需的模块
import torch
import pandas as pd
import torch.nn as nn
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from torch.utils.data import TensorDataset, DataLoader
7.6.2 特征工程
对特征进行处理,数值型特征使用均值填充缺失值,再标准化;类别型特征使用字符串“NaN”填充缺失值,再独特编码。之后构造数据集:
def create_dataset():
    """构造数据集"""
    # 读取数据
    data = pd.read_csv("data/house_prices.csv")
    # 去除无关特征
    data.drop(["Id"], axis=1, inplace=True)
    # 划分特征和目标
    X = data.drop("SalePrice", axis=1)
    y = data["SalePrice"]
    # 筛选出数值型特征
    numerical_features = X.select_dtypes(exclude="object").columns
    # 筛选出类别型特征
    categorical_features = X.select_dtypes(include="object").columns
    # 划分训练集和测试集
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    # 特征预处理
    #   数值型特征先用平均值填充缺失值,再进行标准化
    numerical_transformer = Pipeline(
        steps=[
            ("fillna", SimpleImputer(strategy="mean")),
            ("std", StandardScaler()),
        ]
    )
    #   类别型特征先将缺失值替换为字符串"NaN",再进行独热编码
    categorical_transformer = Pipeline(
        steps=[
            ("fillna", SimpleImputer(strategy="constant", fill_value="NaN")),
            ("onehot", OneHotEncoder(handle_unknown="ignore")),
        ]
    )
    #   组合特征预处理器
    preprocessor = ColumnTransformer(
        transformers=[
            ("num", numerical_transformer, numerical_features),
            ("cat", categorical_transformer, categorical_features),
        ]
    )
    #   进行特征预处理
    x_train = pd.DataFrame(preprocessor.fit_transform(x_train).toarray(), columns=preprocessor.get_feature_names_out())
    x_test = pd.DataFrame(preprocessor.transform(x_test).toarray(), columns=preprocessor.get_feature_names_out())
    # 构建数据集
    train_dataset = TensorDataset(torch.tensor(x_train.values).float(), torch.tensor(y_train.values).float())
    test_dataset = TensorDataset(torch.tensor(x_test.values).float(), torch.tensor(y_test.values).float())
    # 返回训练集,测试集,特征数量
    return train_dataset, test_dataset, x_train.shape[1]

train_dataset, test_dataset, feature_num = create_dataset()
7.6.3 搭建模型
# 搭建模型
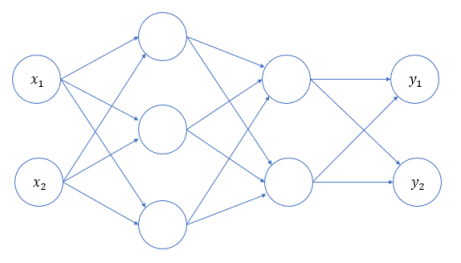
model = nn.Sequential(
    nn.Linear(feature_num, 128),
    nn.BatchNorm1d(128),
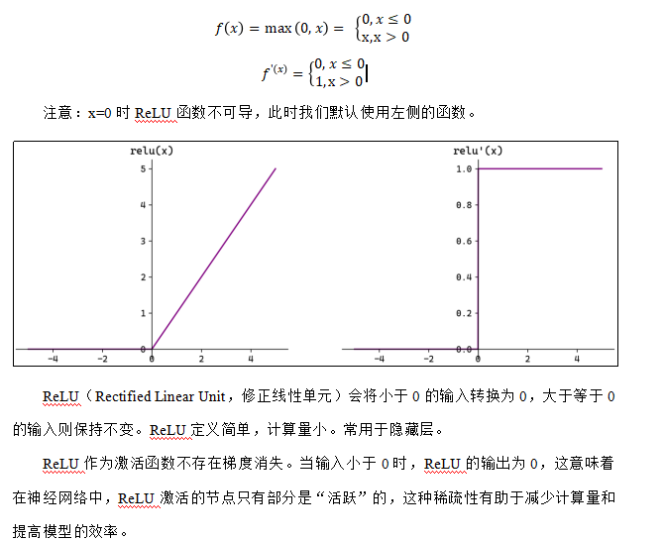
    nn.ReLU(),
    nn.Dropout(0.2),
    nn.Linear(128, 1),
)
7.6.4 损失函数
# 损失函数
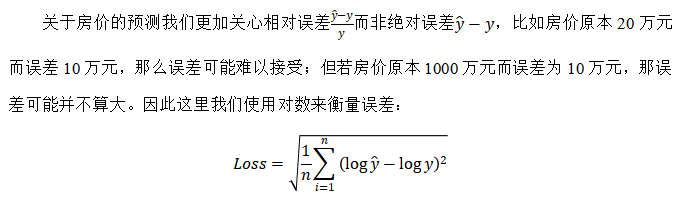
def log_rmse(pred, target):
    mse = nn.MSELoss()
    pred.squeeze_()
    pred = torch.clamp(pred, 1, float("inf"))  # 限制输出在1到正无穷之间
    return torch.sqrt(mse(torch.log(pred), torch.log(target)))
7.6.5 模型训练
# 模型训练
def train(model, train_dataset, test_dataset, lr, epoch_num, batch_size, device):
    def init_weight(layer):
        # 对线性层的权重进行初始化
        if type(layer) == nn.Linear:
            nn.init.xavier_normal_(layer.weight)

    model.apply(init_weight)  # 初始化参数
    model = model.to(device)  # 将模型加载到设备中
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)  # 优化器

    train_loss_list = []  # 记录训练损失
    test_loss_list = []  # 记录验证损失
    for epoch in range(epoch_num):

        # 训练过程
        model.train()  # 将模型设置为训练模式
        train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
        train_loss_accumulate = 0
        # 训练模型
        for batch_count, (X, y) in enumerate(train_loader):
            # 前向传播
            X, y = X.to(device), y.to(device)
            output = model(X)
            # 反向传播
            loss_value = log_rmse(output, y)
            optimizer.zero_grad()
            loss_value.backward()
            optimizer.step()
            # 累加损失
            train_loss_accumulate += loss_value.item()
            # 打印进度条
            print(f"\repoch:{epoch:0>3}[{'='*(int((batch_count+1) / len(train_loader)* 50 )):<50}]", end="")
        this_train_loss = train_loss_accumulate / len(train_loader)  # 计算平均损失
        train_loss_list.append(this_train_loss)  # 记录训练损失

        # 验证过程
        model.eval()  # 将模型设置为评估模式
        test_loader = DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=True)
        test_loss_accumulate = 0
        with torch.no_grad():  # 关闭梯度计算
            for X, y in test_loader:
                # 前向传播
                X, y = X.to(device), y.to(device)
                output = model(X)
                # 累加损失
                test_loss_accumulate += loss_value.item()
        this_test_loss = test_loss_accumulate / len(test_loader)  # 计算平均损失
        test_loss_list.append(this_test_loss)  # 记录验证损失

        # 打印训练损失,验证损失
        print(f" train_loss:{this_train_loss:.6f}, test_loss:{this_test_loss:.6f}")
    return train_loss_list, test_loss_list

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")  # 如果cude可用则使用cuda,否则使用cpu
train_loss_list, test_loss_list = train(model, train_dataset, test_dataset, 0.1, 200, 64, device)
plt.plot(train_loss_list, "r-", label="train_loss", linewidth=3)  # 绘制训练损失
plt.plot(test_loss_list, "k--", label="test_loss", linewidth=2)  # 绘制验证损失
plt.legend()
plt.show()
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容