

9.1 自然语言处理概述
我们平日使用的语言,如汉语或英语,称为自然语言。自然语言处理(Natural Language Processing,NLP)的目标就是让计算机理解人类语言,进而完成对我们有帮助的事情。
说到计算机可以理解的语言,我们可能会想到编程语言或者标记语言等。这些语言的语法定义可以唯一性地解释代码含义,计算机也能根据确定的规则分析代码。编程语言是一种机械的、缺乏活力的语言。换句话说,它是一种“硬语言”。而汉语或英语等自然语言是“软语言”,其含义和形式会灵活变化,并且会不断出现新的词语或新的含义。要让计算机去理解自然语言,使用常规方法是无法办到的。
9.1.1 基于同义词词典的方法
具有相同(同义词)或类似(近义词)含义的单词,可以归到同一个类别中;而根据单词“整体-部分”或者“上位-下位”关系,可以构建出层级的树状图。
这样,就可以构成一个庞大的“单词网络”,用它就可以教会计算机单词之间的关系,从而计算出单词的“相似度”。
主要缺点:
- 需要人工逐个定义单词之间的相关性,非常费时费力;
- 新词不断出现,语言不断变化,词典维护成本极高;
- 在表现力上也有限制。
9.1.2 基于计数的方法
大量的文本数据,构成了 语料库(corpus)。
我们的目的,就是从语料库中,自动且高效地提取出语言的“本质”。最简单的做法,就是统计“词频”。
- 分词:对词进行统计,首先需要对文本内容进行切分,找出一个个基本单元;
- 词关联ID:给单词标上一个 ID,构建单词和ID的关联字典(称为“词表”);
- 词向量化:用一个固定长度的向量来表示单词,也称为词的“分布式表示”。
对每一个词,可以统计它周围出现了什么单词、出现了多少次(称为“上下文”);把这些词频统计出来,就构成了一个向量;这个向量就可以表示当前的词了,称为“词向量”(word vector)。这样,所有词对应的向量,汇总起来就是一个矩阵,被称为 共现矩阵(co-occurrence matrix)。
主要缺点:
- 对所有词进行向量化表示的计算复杂度极高。
9.1.3 基于推理的方法
除了基于计数的方法,还可以使用推理的方法把词用向量表示出来。
我们希望在已知上下文的前提下,“推测”当前位置的词是什么。
利用神经网络,接收上下文信息作为输入,通过模型计算,输出各个单词可能得出现概率;从而就可以根据上下文,预测该出现的单词了。
9.2 词嵌入层
9.2.1 什么是词嵌入
自然语言是由文字构成的,而语言的含义是由单词构成的。即单词是含义的最小单位。因此为了让计算机理解自然语言,首先要让它理解单词含义。
词向量是用于表示单词意义的向量,也可以看作词的特征向量。将词映射到向量的技术称为 词嵌入(Word Embedding)。
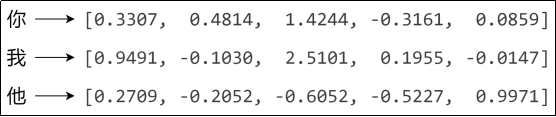
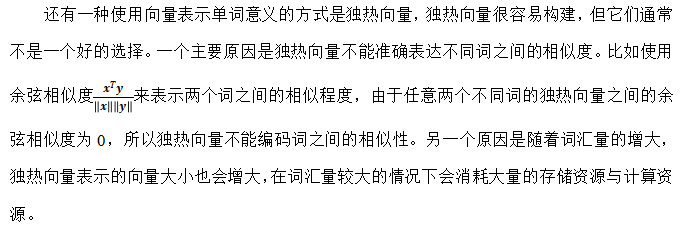
将词转换为词向量时:
- 首先需要对文本进行分词,再根据需要进行清洗和标准化。
- 构建词表(Vocabulary),每个词对应一个索引。
- 使用词嵌入矩阵将词索引转换为词向量。
9.2.2 API使用
可使用torch.nn.Embedding来初始化词嵌入矩阵:
torch.nn.Embedding(num_embeddings, embedding_dim)
# num_embeddings:词的数量
# embedding_dim:词向量的维度
例:
先安装jieba库用于分词:pip install jieba。
import torch
import torch.nn as nn
import jieba

# 设置随机种子
torch.manual_seed(42)
text = "自然语言是由文字构成的,而语言的含义是由单词构成的。即单词是含义的最小单位。因此为了让计算机理解自然语言,首先要让它理解单词含义。"
# 自定义停用词和标点符号
stopwords = {"的", "是", "而", "由", ",", "。", "、"}
# 分词,过滤停用词和标点,去重,构建词表
words = [word for word in jieba.lcut(text) if word not in stopwords]
vocab = list(set(words))  # 词表
# 构建词到索引的映射
word2idx = dict()
for idx, word in enumerate(vocab):
    word2idx[word] = idx
# 初始化嵌入层
embed = nn.Embedding(num_embeddings=len(word2idx), embedding_dim=5)
# 打印词向量
for idx, word in enumerate(vocab):
    word_vec = embed(torch.tensor(idx))  # 通过索引获取词向量
    print(f"{idx:>2}:{word:8}\t{word_vec.detach().numpy()}")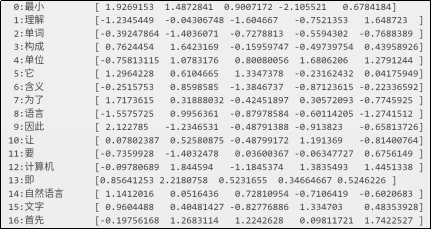











请登录后查看评论内容