



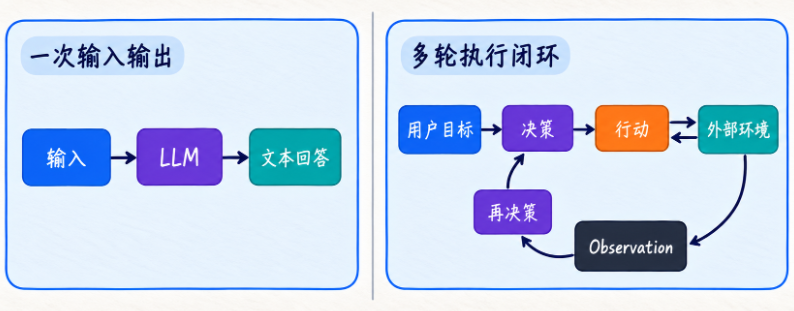
小节二:为什么不直接从 LangChain 开始?我们不是反框架,而是先把“黑盒”拆开
这里先把一个容易误解的地方说清楚。 这门课不是要证明,“LangChain 不好。” 也不是说,“真正厉害的人就应该全部手写,不能用框架。” 这种说法没有意义。 框架的价值非常明确:它帮我们抽象...
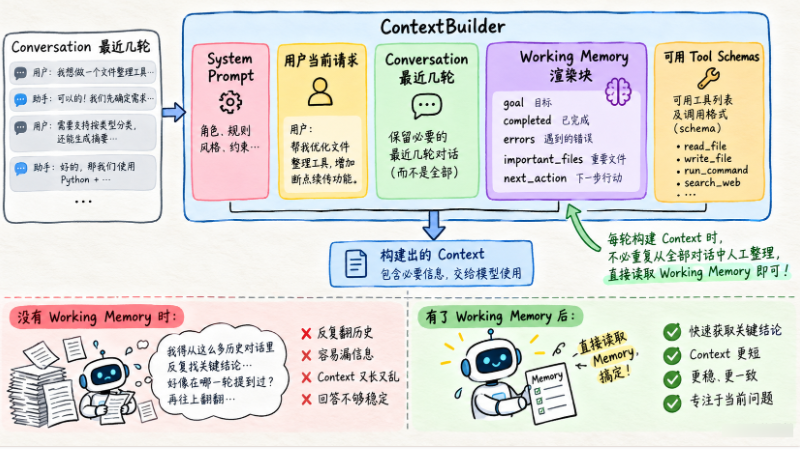
小节三:把 Working Memory 接进 ContextBuilder,减少每轮重复整理
讲到这里,Working Memory 终于不是“概念上很好”,而是要真正接进上下文构建链路里。下面这张图把 ContextBuilder 常见的输入块都摆出来了:System Prompt、用户当前请求、最近几轮 Conversat...
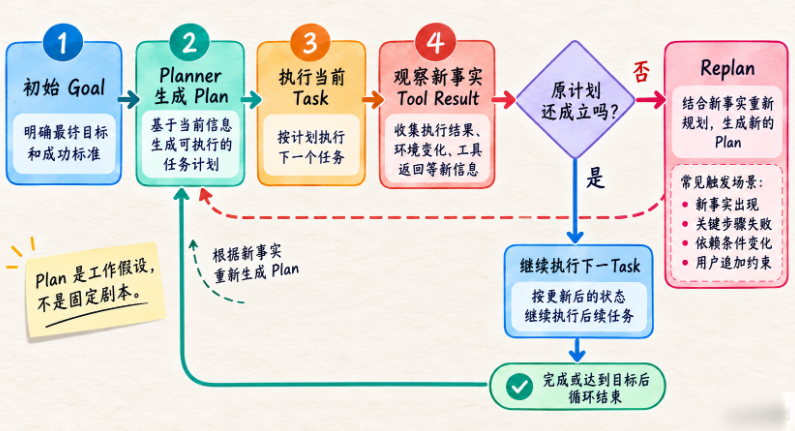
小节四:Plan 不是固定脚本——为什么 Replan 比“坚持原计划”更重要
这一节建议大家一定把心态扭过来:Plan 不是写死的剧本,而是一份“当前最优工作假设”。执行过程中一旦出现新事实,最合理的做法不是硬顶,而是及时重规划。下面这张图把这个循环关系画得很清...

3.2.3 分词工具
概述 目前市面上可用于中文分词的工具种类繁多,按照实现方式大致可以分为如下两类: 一类是基于词典或模型的传统方法,主要以“词”为单位进行切分; 另一类是基于子词建模算法(如BPE)的方式...
4.3.3 实战:创建一个 API 端点生成 Skill
这个 Skill 相对简单,不需要辅助脚本,只需一个 SKILL.md 加一份配置文件: .claude/skills/api-endpoint/├── SKILL.md # 核心指...
3. 一次计算多个统计值
可以通过agg()或aggregate()进行更复杂的操作,如一次计算多个统计值。 df = pd.read_csv('data/employees.csv') # 读取员工数据 # 按department_id分组,计算salary的最小值,中位数,最...
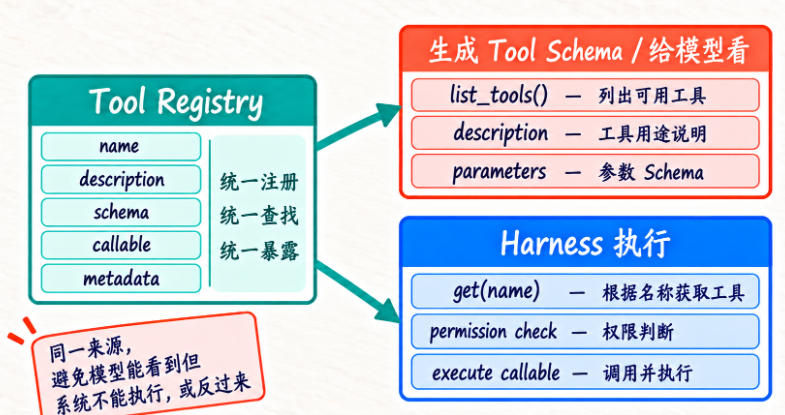
核心小节二:Tool 不只是函数——为什么 Registry 最好保存 Tool 对象和 Metadata
上一小节我们保存的是: name → function 够不够? 短期够。 但很快你会想知道: 这个 Tool 是干什么的? 有没有副作用? 属于哪一类? 是否需要审批? 超时多少? 后面 Schema 怎么生成? 如...
4.2.7 案例实操(AI智评V1.0)
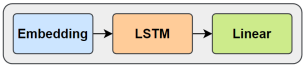
需求说明 本案例的目标是基于 LSTM 构建一个文本情感分类模型,对评论内容进行二分类判断(正面或负面)。 2.需求分析 1)数据集处理 本案例的目标对用户评论文本进行性感分类,因此需使用带有...
4. 模型选择与构建
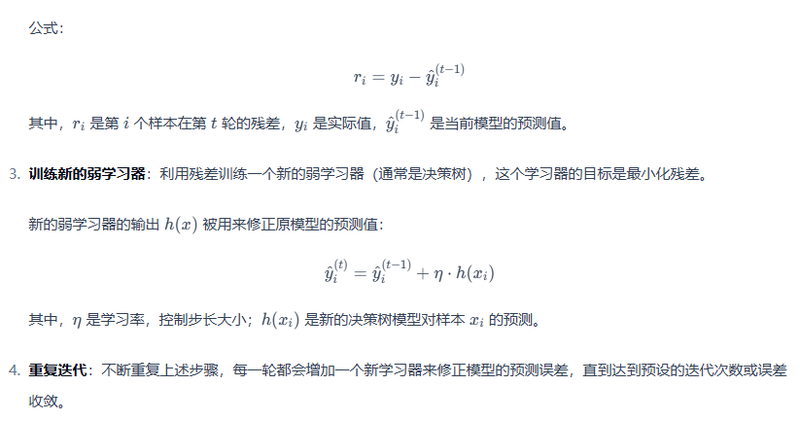
在本阶段,我们将根据业务需求和数据特征,选择最适合的数据分析或预测模型,并详细介绍所选算法的原理和适用性。模型将用于预测客户是否会流失(Exited),这一任务属于二元分类问题。 4.1 模...
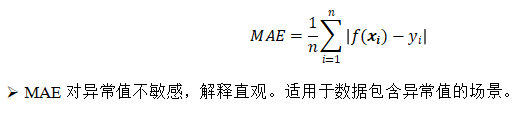
2.7 模型评价指标
对学习的泛化性能进行评估,不仅需要有效可行的实验估计方法,还需要有衡量模型泛化能力的评价指标,也叫做性能度量(performance measure)。 回归模型评价指标 模型的评价指标用于衡量模型在...

