

这里先把一个容易误解的地方说清楚。
这门课不是要证明,“LangChain 不好。”
也不是说,“真正厉害的人就应该全部手写,不能用框架。”
这种说法没有意义。
框架的价值非常明确:它帮我们抽象大量重复工程工作,让我们更快搭建系统。问题只在于学习顺序。
如果你一开始就写:
agent = create_agent(...)
agent.invoke(...)
程序能跑起来当然很好。
但如果你还不知道:
create_agent()内部到底创建了什么;- Tool Schema 是怎么交给模型的;
- Tool Call 谁负责解析;
- Tool Result 以什么形式重新放回上下文;
- Agent 为什么还会再调用第二个工具;
- Session 和 Run 是什么关系;
- 最大步数在哪里控制;
- Tool 失败以后发生了什么;
那么你学到的很可能只是一个“调用姿势”。
换一个框架以后,你又要重新记一次。
我们希望反过来。
先亲手实现最小模型:
while not finished:
    build context
    call llm
    parse action
    execute tool
    append observation
然后再逐渐加入:
State
Tool Registry
Provider
Memory
Middleware
Tracing
等你再回头看任何框架时,会发现它们不再是黑盒,而是不同的工程取舍。
一个非常典型的学习差别
假设一个同学只学会了框架调用。
项目里 Agent 开始反复执行:
read_file("app.py")
read_file("app.py")
read_file("app.py")
read_file("app.py")
……
他第一反应可能是,“是不是 Prompt 不够好?”
于是不断改 Prompt。
但如果你理解 Harness,会先从系统层面排查:
- 有没有
MAX_STEPS; - State 是否正确更新;
- Tool Result 是否真的进入 Context;
- Observation 是否被截断;
- 模型是否能看到已经读过的文件;
- 是否需要 Working Memory 记录“已完成动作”;
- 是否需要重复调用检测。
你会发现,这些问题根本不只是 Prompt 问题。
再比如,一个 Agent 调用:
read_file("../../../../etc/passwd")如果你只关注模型表现,可能会想,“怎么让模型别这么做?”
但 Harness 的思路是,不管模型想不想做,执行层都必须拒绝。
这就是工程与 Prompt 的区别。
我们手搓的不是“所有东西”
“手搓 Agent”也不是说要自己实现 Transformer、自己写 Tokenizer、自己训练大模型。
我们不会重复造那些没有教学价值的轮子。
我们真正手写的是 Agent 运行时最值得理解的部分:
Main Loop
State
Provider Interface
Tool Registry
Tool Schema
Context Builder
Working Memory
Session
Compaction
Middleware
Approval
Tracing
Evaluation
这些模块一旦你亲手做过,再去使用成熟框架,反而会更快。
比如看到框架里的“State”,你知道它不是为了形式感,而是因为 Agent 是一个多步执行过程;看到“Tool Executor”,你知道模型只负责产生调用意图,真正执行必须由程序完成;看到“Checkpoint”,你知道它解决的是任务中断与恢复。
这门课希望给你的不是某个框架版本的记忆,而是一套更稳定的心智模型。
用最简单的方式验证“模型不等于 Agent”
我们甚至可以写一个最简单的对比。
下面这段是“LLM 节点式应用”的结构模拟:
def fake_llm(prompt: str) -> str:
    return f"模型回答:{prompt}"


def run_llm_app(user_message: str) -> str:
    prompt = f"请回答用户问题:{user_message}"
    return fake_llm(prompt)


if __name__ == "__main__":
    print(run_llm_app("Python 项目为什么启动失败?"))
这里的模型只做一次:
Input → Output而 Agent 至少需要:
Input
 ↓
Decision
 ↓
Action
 ↓
Observation
 ↓
Decision
 ↓
……
两者不是“谁更高级”的关系,而是解决的问题不同。
如果问题本来一次回答就够,就没必要上 Agent。
如果任务需要和环境多次交互,Agent 才有意义。
把两种结构并排来看,我们就不会再把“多轮聊天”和“执行型 Agent”混为一谈:
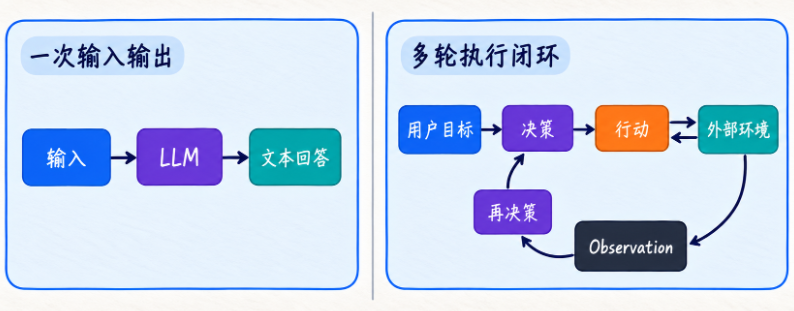
左边的 LLM 应用在一次推理后直接给出文本,适合本来就能一次回答的问题;右边的 Agent 会把行动结果当成 Observation,再决定下一步。真正拉开差距的不是多调用了几次模型,而是系统是否形成了与外部环境交互的反馈闭环。
框架应该在什么时候出现?
当你已经理解:
- 为什么要 Loop;
- 为什么要 State;
- Tool 为什么需要 Schema;
- Context 为什么会爆;
- 为什么需要 Middleware;
- 为什么需要 Tracing;
这时你再引入框架,会非常舒服。
因为你不再问,“这个 API 是干嘛的?”
而是问,“这个框架是怎么实现我已经理解的这些能力的?”
这就是学习层次的变化。
更重要的是,框架在真实工作里通常仍然是好选择。我们学习底层,并不是为了永远不用框架,而是为了拥有判断能力:哪些默认行为可以直接接受,哪些部分要自定义,哪里出了问题应该往哪一层排查。一个只会“照示例调用”的开发者,遇到异常时很容易把所有问题都归到 Prompt;一个理解 Harness 的开发者,会从模型、上下文、状态、工具、权限、网络、持久化、任务生命周期等多层去定位。
这也是课程里“手搓”两个字真正的含义:不是炫技,而是拆黑盒。
下面这张图把学习顺序表达得很直接:我们不是停留在黑盒外面反复记调用方式,而是先把 Loop、State、Tool、Context 等关键结构摊开看懂,再回到成熟框架中提高开发效率。
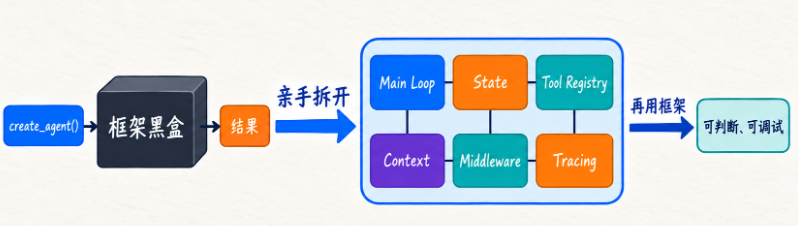
当这些模块在脑子里有了位置,框架报错时就不必只盯着 Prompt。我们可以进一步判断问题到底出在状态更新、工具注册、上下文构建、安全中间件,还是 Trace 记录上,这才是“先手搓”真正带来的能力。














请登录后查看评论内容