

对学习的泛化性能进行评估,不仅需要有效可行的实验估计方法,还需要有衡量模型泛化能力的评价指标,也叫做性能度量(performance measure)。
- 回归模型评价指标
模型的评价指标用于衡量模型在训练集或测试集上的性能,评估结果反映了模型预测的准确性和泛化能力。
对于回归问题,最常用的性能度量是“均方误差” (Mean Squared Error,MSE)。
- 平均绝对误差(MAE)
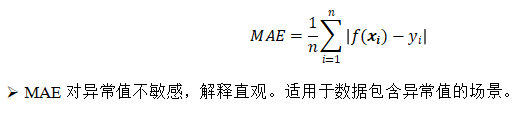
2. 均方误差(MSE)
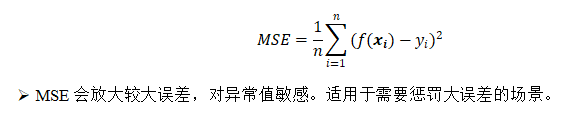
3.均方根误差(RMSE)
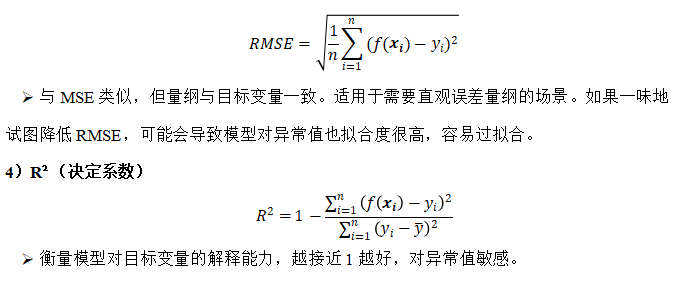
2.7.2 分类模型评价指标
对于分类问题,最常用的指标就是“准确率”(Accuracy),它定义为分类器对测试集正确分类的样本数与总样本数之比。此外还有一系列常用的评价指标。
- 混淆矩阵
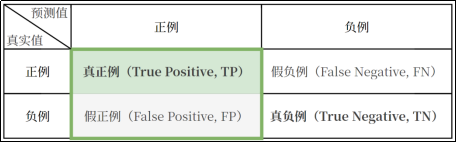
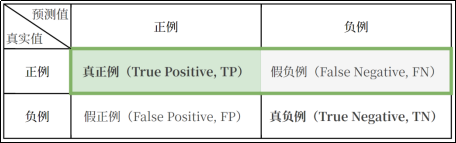
混淆矩阵(Confusion Matrix)是用于评估分类模型性能的工具,展示了模型预测结果与实际标签的对比情况。
对于二分类问题,混淆矩阵是一个2×2矩阵:
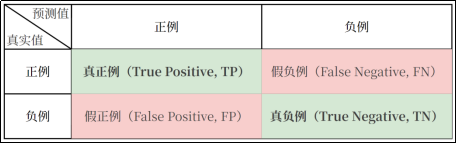
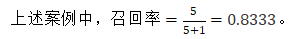
例如,有10个样本。6个是猫,4个是狗。假设以猫为正例,模型预测对了5个猫,2个狗。
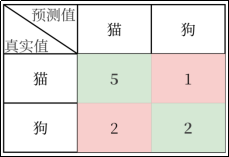
使用sklearn.metrics.confusion_matrix查看混淆矩阵
import pandas as pd
import seaborn as sns
from sklearn.metrics import confusion_matrix

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
matrix1 = confusion_matrix(y_true, y_pred1, labels=label)  # 混淆矩阵
print(pd.DataFrame(matrix1, columns=label, index=label))
sns.heatmap(matrix1, annot=True, fmt='d', cmap='Greens')- 准确率(Accuracy)
正确预测的比例。
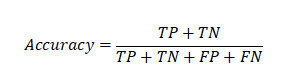
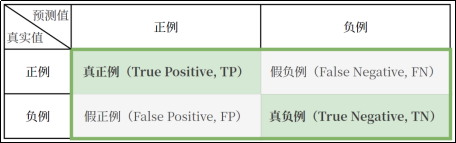
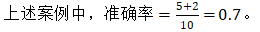
from sklearn.metrics import accuracy_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
accuracy = accuracy_score(y_true, y_pred1)
print(accuracy)2.精确率(Precision)
预测为正例的样本中实际为正例的比例,也叫查准率。
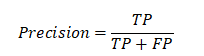
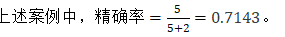
from sklearn.metrics import precision_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
precision = precision_score(y_true, y_pred1, pos_label="猫")  # pos_label指定正例
print(precision)3.召回率(Recall)
实际为正类的样本中预测为正类的比例,也叫查全率。
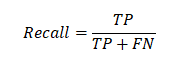
from sklearn.metrics import recall_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
recall = recall_score(y_true, y_pred1, pos_label="猫")  # pos_label指定正例
print(recall)4.F1分数(F1 Score)
精确率和召回率的调和平均。
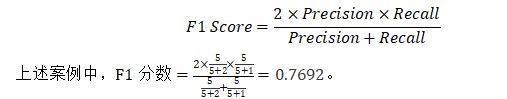
from sklearn.metrics import f1_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
f1 = f1_score(y_true, y_pred1, pos_label="猫")  # pos_label指定正例
print(f1)
在代码中,我们可通过sklearn.metrics.classification_report生成分类任务的评估报告,包括精确率、召回率、
F1分数等。
from sklearn.metrics import classification_report

report = classification_report(y_true, y_pred, labels=[], target_names=None)
# y_true:真实标签
# y_pred:预测的标签
# labels:可选,指定需要计算的类别列表(默认计算所有出现过的类别)
# target_names:可选,类别名称(默认使用 labels 指定的类别号)
例如:
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

# 生成一个二分类数据集
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=100)

# 划分训练集和测试集
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100)

# 训练一个逻辑回归模型
model = LogisticRegression()
model.fit(x_train, y_train)

# 预测
y_pred = model.predict(x_test)

# 生成分类报告
report = classification_report(y_test, y_pred)
print(report)5.ROC曲线
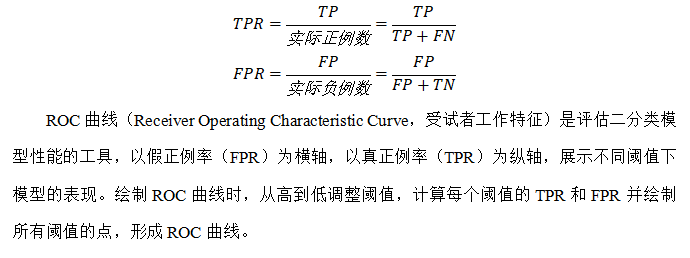
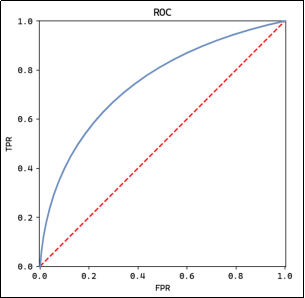
- 真正例率(TPR):实际为正例,被预测为正例的比例,即召回率。
- 假正例率(FPR):实际为负例,被预测为正例的比例。
- 阈值(Threshold):根据阈值将概率转换为类别标签。
6.案例:绘制ROC曲线
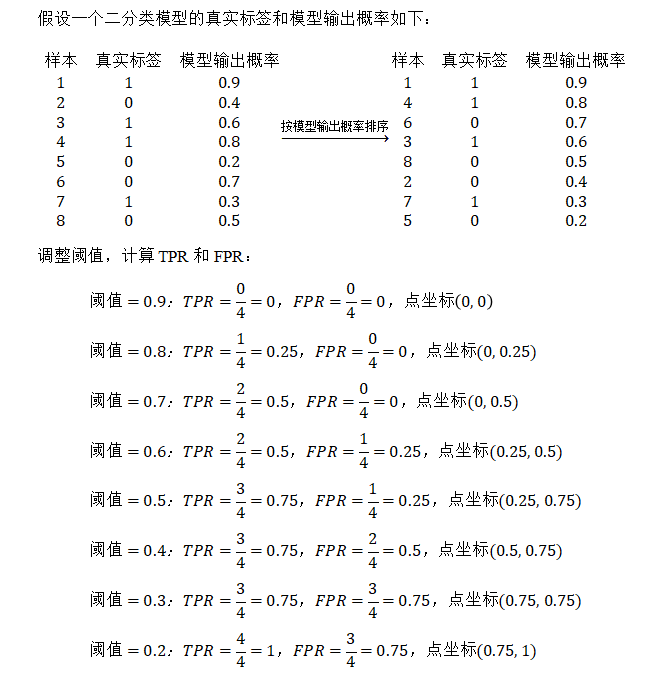
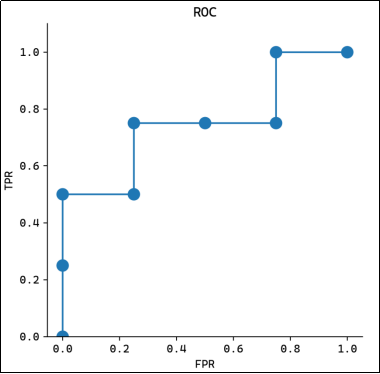
根据坐标点绘制ROC曲线:
7. AUC值
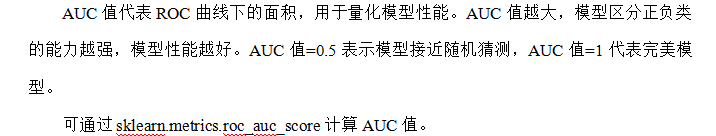
from sklearn.metrics import roc_auc_score

auc_score = roc_auc_score(y_true, y_score)
# y_true: 真实标签(0 或 1)
# y_score: 正例的概率值或置信度
例如:
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

# 生成一个二分类数据集
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=100)

# 划分训练集和测试集
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100)

# 训练一个逻辑回归模型
model = LogisticRegression()
model.fit(x_train, y_train)

# 预测概率值(取正类的概率)
y_pred_proba = model.predict_proba(x_test)[:, 1]

# 计算AUC
auc_score = roc_auc_score(y_test, y_pred_proba)
print(auc_score)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容